


 首頁
薩蒂亞·納德拉向使用人工智慧的企業發出嚴正警告
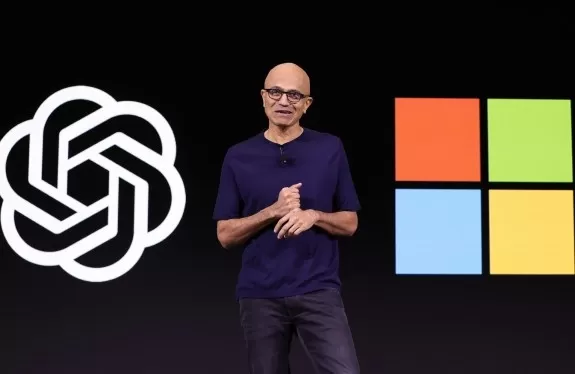
在圍繞人工智慧潛在缺點的諸多辯論中,有一項擔憂讓矽谷的人工智慧愛好者格外憂心:那些販售專有模型的主要人工智慧實驗室,其運作方式可能如同「特洛伊木馬」。
人們擔憂的是,當新創公司和企業採用來自 OpenAI 和 Anthropic 等實驗室的人工智慧模型時,這些實驗室將能越來越多地接觸到企業最敏感的商業數據。 模型開發商隨後可能利用這些資訊謀取私利,甚至可能轉而成為自身客戶的競爭對手。針對此風險的警告,來自包括風險投資人傑森·卡拉卡尼斯(Jason Calacanis)到帕蘭提爾(Palantir)執行長亞歷克斯·卡普(Alex Karp)等各界人士。
如今,微軟執行長薩蒂亞·納德拉(Satya Nadella)在週一發表的一篇令人意外的部落格文章中,也加入了這股聲浪。納德拉警告,AI 使用者——他稱之為「買家」——實際上付了雙重代價。他們明知要為 AI 代幣的使用付費,但在過程中卻也無意間交出了寶貴的數據。
「你本質上為智慧付了兩次代價,一次是用金錢,另一次則是用更珍貴的東西:為了讓這項智慧發揮作用,你必須揭露的專有知識。你越希望模型表現得更好,就必須餵給它更多的知識!」他在文中寫道。
他認為,最危險的是,企業實質上正在教導模型掌握自身業務的細微之處。
「模型從『廢氣』中學習——包括人們撰寫的提示語、代理人員使用的工具,尤其是當模型出錯時人們所做的修正。每一次修正都會被提煉成機構的專有知識,」他寫道。
這正是「競爭對手永遠無法買到的知識」,然而企業卻正在將其拱手相讓。
納德拉主張,如果允許人工智慧公司自由抓取網際網路資料來訓練其模型,那麼企業有權研究——或「提煉」——這些模型作為回報,這才是公平的。 所謂「蒸餾」,是指利用模型自身的輸出結果來理解其運作原理,並根據這些洞見訓練出一個新的、通常成本更低的模型。今年二月,Anthropic 指控中國的開源模型向 Claude 發送數百萬條提示詞以改進其自身模型,並敦促美國政府收緊出口管制。
納德拉的觀點是,模型開發者不能兩頭得利。他們一方面自由地利用全球數據進行訓練,另一方面卻限制他人對其模型進行同樣的訓練,這種做法實屬虛偽。
「雖然模型供應商擁有在公開數據上訓練模型的合理使用權,這項偉大創新確實不可或缺,但我認為現狀卻是轉身對模型蒸餾施加限制性條款,這實在諷刺,」這位微軟執行長寫道。
納德拉特別擔憂的是,模型開發商「保留從客戶使用及互動資料中學習的權利」。
納德拉提出的解決方案,正是大型雲端服務供應商執行長會建議的那種做法。他希望企業能「保留」其資料的所有權,包括提示詞、回饋等內容。 因此,他敦促企業在雲端上建立自己的「專屬學習環境」——畢竟企業的數據很可能本來就存放在雲端,而這恰好可能意味著微軟的雲端服務 Azure。 他還建議企業部署所謂的「協調層」——本質上是一種能輕鬆在不同供應商的人工智慧模型之間切換的方法,而非被鎖定在單一供應商身上。像人工智慧「閘道」這類能實現此功能的工具,已日益普及。
雖然納德拉從未直接使用「開源」一詞來描述保留所有權的方法,但這顯然是其潛台詞。然而,還有另一層潛台詞。
許多大型企業除了使用雲端服務外,仍自行營運資料中心,而這些企業正逐漸轉向在自家場地(業界術語稱為「on-prem」)部署開源模型。 Solo.io 的創辦人兼執行長伊迪特·萊文(Idit Levine)——該公司開發網路與資安軟體,協助企業管理 AI 系統——表示,她正親眼目睹自家客戶出現這種轉變。 「在嘗試過專有模型建構工具後,他們開始詢問:『我能否採用開源模型並在本地部署?它幾乎能完成大型供應商90%的功能,成本卻低得多。』」她向 TechCrunch 表示。「他們明白這一點,而且能夠掌控它。」
Solo.io 的技術去年被選為 Linux 基金會 Agentgateway 專案的核心技術。該公司的客戶包括 T-Mobile、ADP 和 SAP 等企業。她觀察到越來越多企業開始部署本地化的開源模型,並將此視為企業 AI 應用中的下一波重大趨勢。
持此觀點的並非只有她一人。Vercel——這家以建置和託管網站平台聞名、近期新增了 AI 模型切換工具的公司——以及協助開發者將請求路由至不同 AI 模型的 OpenRouter,兩者都觀察到流向開源模型的流量正急遽攀升。 事實上,上個月經由 Vercel 閘道轉發的總流量中,開放式模型佔了 29%。
鑑於微軟執行長——該公司曾投資 OpenAI 與 Anthropic 兩家企業——如今公開呼籲企業在使用專有模型時應保持謹慎,我們預期此趨勢將持續擴大。「在運用智慧的同時,你也在創造智慧。而你所創造的,理應屬於你自己,」納德拉寫道。
相關文章
 微軟高管稱AI資料抓取是“歷史上最大的勞動盜竊”,未經刪減的檔案顯示
紐約時報針對OpenAI和微軟提起的為期三年的版權訴訟中解密的檔案顯示,一家公司承認AI抓取構成盜竊,並對媒體機構構成嚴重威脅。根據訴訟檔案,微軟的一位高管私下將公司的AI訓練方法稱為“盜竊”,而OpenAI的領導層承認,其模型對訓練它們的出版商和記者構成了“生存威脅”。新解密的記錄還詳細說明了這些公司如何繞過付費牆而不被察覺地訪問和利用這些內容,透過大規模抓取構建訓練資料集,並故意從資料中刪除版權宣告。需要注意的是,這些新資訊大多來自《紐約時報》自身的法律簡報,而非仍處於保密狀態的原始證
AI 墳場:一份持續更新的失敗專案與新創公司清單
Relay 是一項以人工智慧驅動的工作流程自動化平台,定位為 Zapier 的替代方案,已於週一停止營運。該服務讓使用者能透過 AI 代理程式自動化電子郵件和任務工作流程,但隨著 OpenAI、Google 及其他主要平台將類似的自動化功能直接整合至其生態系統中,成立五年的 Relay 已難以證明其作為獨立產品的存在價值。Relay 這家被大型平台超越的新創公司,反映了當前產業格局的一面。然而,許
美國因智慧財產權問題對中國人工智慧公司實施制裁
週二,美國財政部長斯科特·貝森特宣佈,美國政府將審查來自中國的大語言模型,以排查潛在的智慧財產權盜竊行為,並警告稱,若確認存在此類違規行為,將對中國的AI企業實施制裁。“我們聽到了很多關於開源模型興起並對美國的大語言模型構成威脅的討論,”貝森特週二在福克斯商業頻道表示。“本屆政府支援開源模型,但我們不支援智慧財產權盜竊。如果我們發現,尤其是海外模型正在竊取我們優秀企業的成果,我們有權因這種盜竊行為對其進行制裁。”貝森特的言論最初由彭博社報道。此番表態之際,中國模型——最近的是月之暗面(Moon
相關專題推薦
設計與藝術
 頂尖 AI 插畫工具:更快地創作編輯畫面與封面插圖
2026 年最新高評分 AI 插畫工具:我們精心挑選的清單收錄了功能強大、設計出色的工具,能助您快速創作出令人驚豔的編輯場景與吸睛的封面藝術。每項選項均經過嚴格的實際測試,並提供免費版與付費版的比較,協助您找到最適合您工作流程的工具。 立即嘗試這些不可錯過的解決方案,釋放您的人工智慧優勢,並提升您的創意生產力。現在就前往 XIX.AI 探索吧。
 10 個工具
 xix.ai
教育與學習
頂尖 AI 補習老師助您備考:練習數學、科學和英語
2026 年最新、評價最高的考試備考 AI 輔導工具,盡在 XIX.AI!我們精心挑選的清單收錄了多款強大且顛覆傳統的工具,提供免費與付費版本的比較、實際測試,以及每週更新的排行榜。這些工具能幫助您提升寫作效率、簡化複雜主題的學習,並釋放您的學術潛能。 立即探索,發掘最適合您的備考工具,並從今天開始創作,釋放您的 AI 優勢!
10 個工具
xix.ai
金融
用於個人財務管理的 AI 預算規劃工具
2026 年最新最佳頂級評分 AI 預算規劃工具,專為個人財務管理打造,現已登陸 XIX.AI!本精選合集收錄了強大且具顛覆性的解決方案,助您開展實際測試、理解消費習慣,並制定個性化計劃以提升生產力。享受免費與付費版的對比及詳細排名。這些必試工具旨在簡化財務管理,助您釋放 AI 優勢。立即探索!
11 個工具
xix.ai
健康與養生
AI 睡眠追蹤助手:透過更佳的睡前習慣提升恢復效果
2026 年最新精選、評價最高的 AI 睡眠追蹤助手,助您獲得最佳恢復效果。這份全面更新的每週指南收錄了強大的工具,提供實際測試報告、免費與付費版本的比較,以及詳細排名,協助您找到必試的解決方案,以提升睡眠品質並培養更好的就寢習慣。 立即造訪 XIX.AI,解鎖您的 AI 優勢。
10 個工具
xix.ai
數據分析
用於產品與營收分析的 AI SQL 協作助手
2026 年最新最佳、評價最高的 AI SQL 輔助工具,專為產品與營收分析打造! XIX.AI 精心甄選了一系列強大且顛覆業界的必試工具,這些工具均經過實戰測試,並透過每週更新的排行榜進行評比。這些工具能透過加速資料分析、簡化複雜查詢,並產生精準洞察來推動更明智的商業決策,從而大幅提升使用者生產力。立即探索,發掘最適合您的工具,釋放您的 AI 優勢!
14 個工具
xix.ai
教育與學習
最佳的「教學型」AI 作業輔助工具:學習概念,而不僅是答案
2026 年最新最佳高評價 AI 作業輔助工具:不僅提供答案,更教授核心概念。專為學生打造的強大工具,必試精選清單,每週更新,免費與付費版本比較,實際測試,精準排名,助您充分發揮學習潛能。立即探索,發掘最適合您的工具,讓學習更聰明。
10 個工具
xix.ai

 評論 (0)
0/500
在圍繞人工智慧潛在缺點的諸多辯論中,有一項擔憂讓矽谷的人工智慧愛好者格外憂心:那些販售專有模型的主要人工智慧實驗室,其運作方式可能如同「特洛伊木馬」。
人們擔憂的是,當新創公司和企業採用來自 OpenAI 和 Anthropic 等實驗室的人工智慧模型時,這些實驗室將能越來越多地接觸到企業最敏感的商業數據。 模型開發商隨後可能利用這些資訊謀取私利,甚至可能轉而成為自身客戶的競爭對手。針對此風險的警告,來自包括風險投資人傑森·卡拉卡尼斯(Jason Calacanis)到帕蘭提爾(Palantir)執行長亞歷克斯·卡普(Alex Karp)等各界人士。
如今,微軟執行長薩蒂亞·納德拉(Satya Nadella)在週一發表的一篇令人意外的部落格文章中,也加入了這股聲浪。納德拉警告,AI 使用者——他稱之為「買家」——實際上付了雙重代價。他們明知要為 AI 代幣的使用付費,但在過程中卻也無意間交出了寶貴的數據。
「你本質上為智慧付了兩次代價,一次是用金錢,另一次則是用更珍貴的東西:為了讓這項智慧發揮作用,你必須揭露的專有知識。你越希望模型表現得更好,就必須餵給它更多的知識!」他在文中寫道。
他認為,最危險的是,企業實質上正在教導模型掌握自身業務的細微之處。
「模型從『廢氣』中學習——包括人們撰寫的提示語、代理人員使用的工具,尤其是當模型出錯時人們所做的修正。每一次修正都會被提煉成機構的專有知識,」他寫道。
這正是「競爭對手永遠無法買到的知識」,然而企業卻正在將其拱手相讓。
納德拉主張,如果允許人工智慧公司自由抓取網際網路資料來訓練其模型,那麼企業有權研究——或「提煉」——這些模型作為回報,這才是公平的。 所謂「蒸餾」,是指利用模型自身的輸出結果來理解其運作原理,並根據這些洞見訓練出一個新的、通常成本更低的模型。今年二月,Anthropic 指控中國的開源模型向 Claude 發送數百萬條提示詞以改進其自身模型,並敦促美國政府收緊出口管制。
納德拉的觀點是,模型開發者不能兩頭得利。他們一方面自由地利用全球數據進行訓練,另一方面卻限制他人對其模型進行同樣的訓練,這種做法實屬虛偽。
「雖然模型供應商擁有在公開數據上訓練模型的合理使用權,這項偉大創新確實不可或缺,但我認為現狀卻是轉身對模型蒸餾施加限制性條款,這實在諷刺,」這位微軟執行長寫道。
納德拉特別擔憂的是,模型開發商「保留從客戶使用及互動資料中學習的權利」。
納德拉提出的解決方案,正是大型雲端服務供應商執行長會建議的那種做法。他希望企業能「保留」其資料的所有權,包括提示詞、回饋等內容。 因此,他敦促企業在雲端上建立自己的「專屬學習環境」——畢竟企業的數據很可能本來就存放在雲端,而這恰好可能意味著微軟的雲端服務 Azure。 他還建議企業部署所謂的「協調層」——本質上是一種能輕鬆在不同供應商的人工智慧模型之間切換的方法,而非被鎖定在單一供應商身上。像人工智慧「閘道」這類能實現此功能的工具,已日益普及。
雖然納德拉從未直接使用「開源」一詞來描述保留所有權的方法,但這顯然是其潛台詞。然而,還有另一層潛台詞。
許多大型企業除了使用雲端服務外,仍自行營運資料中心,而這些企業正逐漸轉向在自家場地(業界術語稱為「on-prem」)部署開源模型。 Solo.io 的創辦人兼執行長伊迪特·萊文(Idit Levine)——該公司開發網路與資安軟體,協助企業管理 AI 系統——表示,她正親眼目睹自家客戶出現這種轉變。 「在嘗試過專有模型建構工具後,他們開始詢問:『我能否採用開源模型並在本地部署?它幾乎能完成大型供應商90%的功能,成本卻低得多。』」她向 TechCrunch 表示。「他們明白這一點,而且能夠掌控它。」
Solo.io 的技術去年被選為 Linux 基金會 Agentgateway 專案的核心技術。該公司的客戶包括 T-Mobile、ADP 和 SAP 等企業。她觀察到越來越多企業開始部署本地化的開源模型,並將此視為企業 AI 應用中的下一波重大趨勢。
持此觀點的並非只有她一人。Vercel——這家以建置和託管網站平台聞名、近期新增了 AI 模型切換工具的公司——以及協助開發者將請求路由至不同 AI 模型的 OpenRouter,兩者都觀察到流向開源模型的流量正急遽攀升。 事實上,上個月經由 Vercel 閘道轉發的總流量中,開放式模型佔了 29%。
鑑於微軟執行長——該公司曾投資 OpenAI 與 Anthropic 兩家企業——如今公開呼籲企業在使用專有模型時應保持謹慎,我們預期此趨勢將持續擴大。「在運用智慧的同時,你也在創造智慧。而你所創造的,理應屬於你自己,」納德拉寫道。








 微軟高管稱AI資料抓取是“歷史上最大的勞動盜竊”,未經刪減的檔案顯示
紐約時報針對OpenAI和微軟提起的為期三年的版權訴訟中解密的檔案顯示,一家公司承認AI抓取構成盜竊,並對媒體機構構成嚴重威脅。根據訴訟檔案,微軟的一位高管私下將公司的AI訓練方法稱為“盜竊”,而OpenAI的領導層承認,其模型對訓練它們的出版商和記者構成了“生存威脅”。新解密的記錄還詳細說明了這些公司如何繞過付費牆而不被察覺地訪問和利用這些內容,透過大規模抓取構建訓練資料集,並故意從資料中刪除版權宣告。需要注意的是,這些新資訊大多來自《紐約時報》自身的法律簡報,而非仍處於保密狀態的原始證
 AI 墳場:一份持續更新的失敗專案與新創公司清單
Relay 是一項以人工智慧驅動的工作流程自動化平台,定位為 Zapier 的替代方案,已於週一停止營運。該服務讓使用者能透過 AI 代理程式自動化電子郵件和任務工作流程,但隨著 OpenAI、Google 及其他主要平台將類似的自動化功能直接整合至其生態系統中,成立五年的 Relay 已難以證明其作為獨立產品的存在價值。Relay 這家被大型平台超越的新創公司,反映了當前產業格局的一面。然而,許
 美國因智慧財產權問題對中國人工智慧公司實施制裁
週二,美國財政部長斯科特·貝森特宣佈,美國政府將審查來自中國的大語言模型,以排查潛在的智慧財產權盜竊行為,並警告稱,若確認存在此類違規行為,將對中國的AI企業實施制裁。“我們聽到了很多關於開源模型興起並對美國的大語言模型構成威脅的討論,”貝森特週二在福克斯商業頻道表示。“本屆政府支援開源模型,但我們不支援智慧財產權盜竊。如果我們發現,尤其是海外模型正在竊取我們優秀企業的成果,我們有權因這種盜竊行為對其進行制裁。”貝森特的言論最初由彭博社報道。此番表態之際,中國模型——最近的是月之暗面(Moon

2026 年最新高評分 AI 插畫工具:我們精心挑選的清單收錄了功能強大、設計出色的工具,能助您快速創作出令人驚豔的編輯場景與吸睛的封面藝術。每項選項均經過嚴格的實際測試,並提供免費版與付費版的比較,協助您找到最適合您工作流程的工具。 立即嘗試這些不可錯過的解決方案,釋放您的人工智慧優勢,並提升您的創意生產力。現在就前往 XIX.AI 探索吧。
10 個工具
xix.ai

2026 年最新、評價最高的考試備考 AI 輔導工具,盡在 XIX.AI!我們精心挑選的清單收錄了多款強大且顛覆傳統的工具,提供免費與付費版本的比較、實際測試,以及每週更新的排行榜。這些工具能幫助您提升寫作效率、簡化複雜主題的學習,並釋放您的學術潛能。 立即探索,發掘最適合您的備考工具,並從今天開始創作,釋放您的 AI 優勢!
10 個工具
xix.ai

2026 年最新最佳頂級評分 AI 預算規劃工具,專為個人財務管理打造,現已登陸 XIX.AI!本精選合集收錄了強大且具顛覆性的解決方案,助您開展實際測試、理解消費習慣,並制定個性化計劃以提升生產力。享受免費與付費版的對比及詳細排名。這些必試工具旨在簡化財務管理,助您釋放 AI 優勢。立即探索!
11 個工具
xix.ai

2026 年最新精選、評價最高的 AI 睡眠追蹤助手,助您獲得最佳恢復效果。這份全面更新的每週指南收錄了強大的工具,提供實際測試報告、免費與付費版本的比較,以及詳細排名,協助您找到必試的解決方案,以提升睡眠品質並培養更好的就寢習慣。 立即造訪 XIX.AI,解鎖您的 AI 優勢。
10 個工具
xix.ai

2026 年最新最佳、評價最高的 AI SQL 輔助工具,專為產品與營收分析打造! XIX.AI 精心甄選了一系列強大且顛覆業界的必試工具,這些工具均經過實戰測試,並透過每週更新的排行榜進行評比。這些工具能透過加速資料分析、簡化複雜查詢,並產生精準洞察來推動更明智的商業決策,從而大幅提升使用者生產力。立即探索,發掘最適合您的工具,釋放您的 AI 優勢!
14 個工具
xix.ai

2026 年最新最佳高評價 AI 作業輔助工具:不僅提供答案,更教授核心概念。專為學生打造的強大工具,必試精選清單,每週更新,免費與付費版本比較,實際測試,精準排名,助您充分發揮學習潛能。立即探索,發掘最適合您的工具,讓學習更聰明。
10 個工具
xix.ai












