


 首頁
OpenCUA 的開放原始碼 AI 代理挑戰 OpenAI 和 Anthropic 的專屬模型
來自香港大學 (HKU) 和合作機構的研究人員開發了一個創新的開放源碼框架,稱為 OpenCUA,為建立能夠操作電腦的人工智能代理建立了穩健的基礎。這個全面的工具包提供了擴大電腦使用代理(CUA)開發的重要組成部分,包括專門的工具、廣泛的訓練數據集和經過驗證的方法。
初步評估顯示,與其他開放原始碼解決方案相比,使用 OpenCUA 訓練的模型在 CUA 基準上表現優異,同時可媲美 OpenAI 和 Anthropic 等業界領導者的專屬系統。
開發電腦使用代理程式的複雜挑戰
電腦使用代理程式代表了人工智慧的轉型,可自主執行從簡單網頁導覽到複雜軟體操作的數位任務。這些智慧型系統在企業工作流程自動化方面擁有極大的潛力,但大多數先進的 CUAs 仍是專屬的黑盒子。
"商用 CUAs 缺乏透明度,限制了技術進步,並提出了重要的安全考量,」研究團隊在發表的作品中指出。「科學界需要真正開放的框架,以適當調查能力、限制和潛在風險」。
目前的開放原始碼計畫面臨重大的障礙,包括
- 大規模、多樣化資料收集的基礎架構不足
- 優質 GUI 互動資料集的可用性有限
- 文件不足使得研究難以複製
正如本文所解釋的"這些限制共同妨礙了通用 CUAs 的進展,並阻礙了對其可擴展性、泛化能力和最佳學習方法的全面探索。
OpenCUA 架構簡介
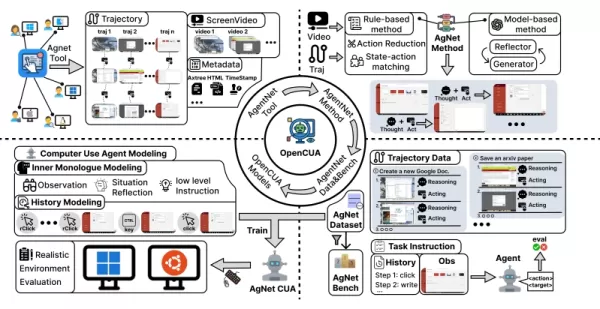
*OpenCUA 架構概觀 (資料來源:香港大學 XLANG 實驗室)*。 OpenCUA 框架引進了一個整合式解決方案,可同時應付資料收集與模型訓練的挑戰。其核心元件是 AgentNet 工具 - 專門的軟體,可在多種作業系統中捕捉詳細的人機互動。
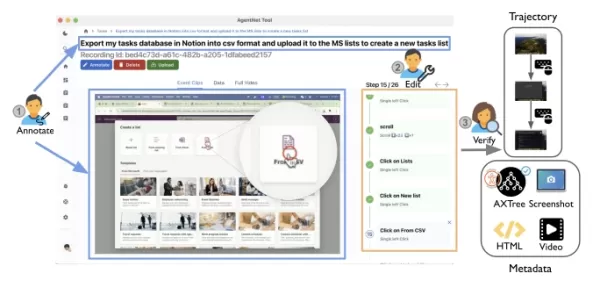
*AgentNet資料收集工具 (資料來源:香港大學XLang實驗室) 這個創新的工具在背景中獨立運作,進行記錄:
- 螢幕活動影片
- 精確的滑鼠/鍵盤輸入
- 定義螢幕元素的無障礙樹狀結構
研究人員將這些原始互動資料處理成精煉的「狀態-動作軌跡」,將電腦螢幕截圖與對應的使用者動作配對。由此產生的 AgentNet 資料集包含超過 22,600 個任務示範,跨越 Windows、macOS 和 Ubuntu 環境,以及超過 200 個不同的應用程式和網站。
香港大學博士研究員兼研究合著者王欣媛強調了他們嚴格的隱私保護措施:「我們實施了一個多層次的安全框架,允許註解者對其提交的資料進行完全的可視性和控制,然後在資料發佈之前進行人工驗證和自動敏感內容掃描」。
創新的訓練方法
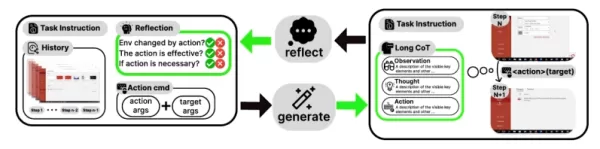
*OpenCUA的思維鏈推理過程(來源:香港大學XLang實驗室)* 該架構引入了一個新穎的資料處理管道,結合了已清理的狀態-動作對與結構化的思維鏈推理。此方法可為每個動作產生詳細的「認知獨白」,包括
- 高階螢幕觀察
- 策略分析與規劃
- 精確的可執行指令
據 Wang 所說,企業可以透過記錄內部工作流程並應用相同的推理框架,調整此管道來訓練專屬系統的專門代理。"他解釋:「這可讓企業開發高效能的客製化代理程式,而無須手動建立推理軌跡。
基準效能與企業應用
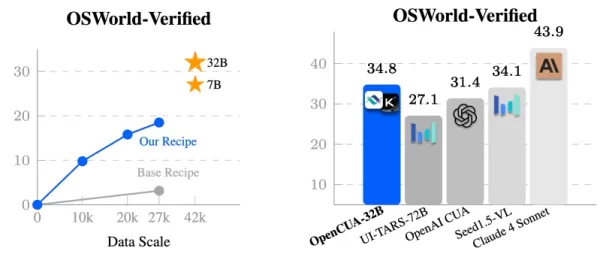
*OpenCUA 效能比較 (資料來源:香港大學 XLANG Lab)* 在 OSWorld-Verified 基準上,320 億個參數的 OpenCUA 模型在開源解決方案中取得創紀錄的效能,同時大幅縮小與領先專利系統的差距。主要的企業成果包括
- 框架適用於各種不同的模型架構和規模
- 跨平台和任務類型的強大通用性
- 對於重複性工作流程的自動化特別有效
Wang 強調了實作上的挑戰:「真實世界的部署需要強大的安全機制,以防止在任務執行過程中出現意外的系統修改或有害的副作用」。
研究團隊已公開發表所有框架元件,包括原始碼、資料集和模型權重。隨著 OpenCUA 驅動的代理程式的進步,它們可能會從根本上改變工作場所的動態,讓人類工作者專注於策略目標,而人工智能則處理作業執行。
相關文章
 Base44 推出專有 AI 模型,以增強其 Vibe Coding 平臺的安全性
Base44,這個一年前僅成立六個月、團隊規模僅為八人的初創公司,被Wix以8000萬美元收購,如今已開始部署其專有AI模型,幫助使用者使用自然語言構建應用程式。這一進展正值AI社羣爭論前沿模型是否適用於所有用例,以及依賴外部模型的企業能否保持長期競爭優勢之時。總部位於灣區的Base44的最新戰略旨在解決這兩方面的擔憂。儘管其定製大語言模型(LLM)剛剛推出,Base44的目標是最終超越前沿模型。創始人Maor Shlomo指出,“作為我們整個技術棧的一部分來訓練並擁有該模型,使我們能夠在延遲
Multiverse Computing 推出免費壓縮生成式人工智慧模型
大型語言模型面臨著重大挑戰:其龐大的體積。西班牙新創公司Multiverse Computing正透過開發壓縮模型來解決此問題,旨在彌合尖端AI能力與企業實際可負擔部署方案之間的差距。其核心創新在於「CompactifAI」壓縮技術——這項受量子運算原理啟發的技術,已被這家巴斯克公司用於優化OpenAI的模型。即日起,開發者可在Hugging Face平台免費使用Multiverse增強版的Hyp
秘密追蹤數據揭露人工智慧模型遭竊事件
一種新方法能在數秒內對ChatGPT等模型進行隱形水印處理,無需重新訓練,既不會在標準輸出中留下痕跡,又能抵禦所有實際的移除嘗試。 水印技術與「版權誘餌」的核心差異在於:無論可見或隱藏的水印,通常設計為貫穿整個資料集(如圖像資料集)的恆定存在,藉此對隨意複製行為形成持續威懾。相對地,虛構條目是將一小段文字(通常為單詞或定義)植入龐大通用資料庫,旨在證明盜用行為。其原理在於:當整部作品遭未經授權複製
相關專題推薦
音樂創作
 用於混音製作、取樣準備及卡拉OK母帶處理的 AI 聲部分離工具
2026年最新、最優秀且評分最高的AI音軌分離工具彙總,專為混音製作、取樣準備以及卡拉OK音訊處理而設計。這些功能強大的創新工具經過實際測試,能夠實現精準的音訊分離,顯著提升工作效率。XIX.AI每週都會更新免費的付費產品對比指南,幫助您找到最適合自身需求的工具。立即探索,發揮您的AI優勢。
 8 個工具
 xix.ai
數據分析
用於收入看板、轉化漏斗分析及產品指標分析的 AI SQL 助手
2026年最新最優秀的AI SQL輔助工具排名揭曉!XIX.AI精心挑選了一系列功能強大的工具,這些工具會定期更新,並透過真實的場景測試來驗證其效能。使用這些值得嘗試的工具,您可以快速生成精準的收入分析報表、分析銷售流程,並追蹤產品各項指標,從而大幅提升工作效率。立即探索,找到最適合您的資料驅動決策工具!238個字元
9 個工具
xix.ai
音樂創作
最佳用於歌曲草稿的 AI 旋律創作工具
2026 年最新最佳頂級評分 AI 旋律創作工具,助力歌曲草稿創作!XIX.AI 精心策劃了一套極具影響力且經過嚴格真實世界測試的變革性合集,旨在提供最佳的創作體驗。您可以找到詳細的免費與付費版對比、精準的排名以及必試選項,這些工具旨在幫助您輕鬆創作出令人驚豔的歌曲草稿,並顯著提升您的創意生產力。立即探索,發現您的完美工具!
8 個工具
xix.ai
聊天機器人
最適合面試練習的 AI 對話訓練工具
2026 年最新、最受好評的 AI 面試對話訓練工具,盡在 XIX.AI!這份精心精選的清單收錄了多款功能強大、顛覆傳統的工具,這些工具均經過嚴格的實戰測試,能提供精準的回饋。 您將在此找到免費版與付費版的比較分析,以及詳細的排名榜單,助您挑選必試的選項,從而提升自信與技能。立即探索,發掘助您在面試中脫穎而出的完美工具!
12 個工具
xix.ai
設計與藝術
最適合進行創意實驗的 AI 風格轉移工具
2026 年最新、最佳且評價最高的 AI 風格轉移工具,助您進行創意實驗!XIX.AI 精心精選了一系列強大且具革命性的必試工具,這些工具經實際測試與嚴格評比,能帶來卓越成果。這些頂尖解決方案能加速內容創作並開啟無盡的創意可能性,協助創作者顯著提升生產力。 立即探索,找出最適合您的工具,並從今天開始創作吧!
9 個工具
xix.ai
漫畫創作
最適合視覺敘事的 AI 對話氣泡工具
2026 年最新、最受好評的視覺敘事 AI 對話氣泡工具,現已登陸 XIX.AI!這份精心挑選的合集收錄了強大且具顛覆性的工具,能協助創作者提升生產力並突破創作瓶頸。 查看免費版與付費版的比較、參考實際測試結果,並查閱最新排行榜,找出最適合打造引人入勝視覺敘事的必試解決方案。立即探索,發掘您的理想工具!
10 個工具
xix.ai

 評論 (1)
0/500
![JuanJackson]()
Любопытно, как открытые проекты вроде OpenCUA бросят вызов гигантам вроде OpenAI. Может, наконец-то появится реальная альтернатива? Хотя, конечно, всегда есть опасения по поводу безопасности таких агентов — вдруг начнут делать что-то не то? 😅
來自香港大學 (HKU) 和合作機構的研究人員開發了一個創新的開放源碼框架,稱為 OpenCUA,為建立能夠操作電腦的人工智能代理建立了穩健的基礎。這個全面的工具包提供了擴大電腦使用代理(CUA)開發的重要組成部分,包括專門的工具、廣泛的訓練數據集和經過驗證的方法。
初步評估顯示,與其他開放原始碼解決方案相比,使用 OpenCUA 訓練的模型在 CUA 基準上表現優異,同時可媲美 OpenAI 和 Anthropic 等業界領導者的專屬系統。
開發電腦使用代理程式的複雜挑戰
電腦使用代理程式代表了人工智慧的轉型,可自主執行從簡單網頁導覽到複雜軟體操作的數位任務。這些智慧型系統在企業工作流程自動化方面擁有極大的潛力,但大多數先進的 CUAs 仍是專屬的黑盒子。
"商用 CUAs 缺乏透明度,限制了技術進步,並提出了重要的安全考量,」研究團隊在發表的作品中指出。「科學界需要真正開放的框架,以適當調查能力、限制和潛在風險」。
目前的開放原始碼計畫面臨重大的障礙,包括
- 大規模、多樣化資料收集的基礎架構不足
- 優質 GUI 互動資料集的可用性有限
- 文件不足使得研究難以複製
正如本文所解釋的"這些限制共同妨礙了通用 CUAs 的進展,並阻礙了對其可擴展性、泛化能力和最佳學習方法的全面探索。
OpenCUA 架構簡介
OpenCUA 框架引進了一個整合式解決方案,可同時應付資料收集與模型訓練的挑戰。其核心元件是 AgentNet 工具 - 專門的軟體,可在多種作業系統中捕捉詳細的人機互動。
這個創新的工具在背景中獨立運作,進行記錄:
- 螢幕活動影片
- 精確的滑鼠/鍵盤輸入
- 定義螢幕元素的無障礙樹狀結構
研究人員將這些原始互動資料處理成精煉的「狀態-動作軌跡」,將電腦螢幕截圖與對應的使用者動作配對。由此產生的 AgentNet 資料集包含超過 22,600 個任務示範,跨越 Windows、macOS 和 Ubuntu 環境,以及超過 200 個不同的應用程式和網站。
香港大學博士研究員兼研究合著者王欣媛強調了他們嚴格的隱私保護措施:「我們實施了一個多層次的安全框架,允許註解者對其提交的資料進行完全的可視性和控制,然後在資料發佈之前進行人工驗證和自動敏感內容掃描」。
創新的訓練方法
該架構引入了一個新穎的資料處理管道,結合了已清理的狀態-動作對與結構化的思維鏈推理。此方法可為每個動作產生詳細的「認知獨白」,包括
- 高階螢幕觀察
- 策略分析與規劃
- 精確的可執行指令
據 Wang 所說,企業可以透過記錄內部工作流程並應用相同的推理框架,調整此管道來訓練專屬系統的專門代理。"他解釋:「這可讓企業開發高效能的客製化代理程式,而無須手動建立推理軌跡。
基準效能與企業應用
在 OSWorld-Verified 基準上,320 億個參數的 OpenCUA 模型在開源解決方案中取得創紀錄的效能,同時大幅縮小與領先專利系統的差距。主要的企業成果包括
- 框架適用於各種不同的模型架構和規模
- 跨平台和任務類型的強大通用性
- 對於重複性工作流程的自動化特別有效
Wang 強調了實作上的挑戰:「真實世界的部署需要強大的安全機制,以防止在任務執行過程中出現意外的系統修改或有害的副作用」。
研究團隊已公開發表所有框架元件,包括原始碼、資料集和模型權重。隨著 OpenCUA 驅動的代理程式的進步,它們可能會從根本上改變工作場所的動態,讓人類工作者專注於策略目標,而人工智能則處理作業執行。








 Base44 推出專有 AI 模型,以增強其 Vibe Coding 平臺的安全性
Base44,這個一年前僅成立六個月、團隊規模僅為八人的初創公司,被Wix以8000萬美元收購,如今已開始部署其專有AI模型,幫助使用者使用自然語言構建應用程式。這一進展正值AI社羣爭論前沿模型是否適用於所有用例,以及依賴外部模型的企業能否保持長期競爭優勢之時。總部位於灣區的Base44的最新戰略旨在解決這兩方面的擔憂。儘管其定製大語言模型(LLM)剛剛推出,Base44的目標是最終超越前沿模型。創始人Maor Shlomo指出,“作為我們整個技術棧的一部分來訓練並擁有該模型,使我們能夠在延遲
 Multiverse Computing 推出免費壓縮生成式人工智慧模型
大型語言模型面臨著重大挑戰:其龐大的體積。西班牙新創公司Multiverse Computing正透過開發壓縮模型來解決此問題,旨在彌合尖端AI能力與企業實際可負擔部署方案之間的差距。其核心創新在於「CompactifAI」壓縮技術——這項受量子運算原理啟發的技術,已被這家巴斯克公司用於優化OpenAI的模型。即日起,開發者可在Hugging Face平台免費使用Multiverse增強版的Hyp
 秘密追蹤數據揭露人工智慧模型遭竊事件
一種新方法能在數秒內對ChatGPT等模型進行隱形水印處理,無需重新訓練,既不會在標準輸出中留下痕跡,又能抵禦所有實際的移除嘗試。 水印技術與「版權誘餌」的核心差異在於:無論可見或隱藏的水印,通常設計為貫穿整個資料集(如圖像資料集)的恆定存在,藉此對隨意複製行為形成持續威懾。相對地,虛構條目是將一小段文字(通常為單詞或定義)植入龐大通用資料庫,旨在證明盜用行為。其原理在於:當整部作品遭未經授權複製

2026年最新、最優秀且評分最高的AI音軌分離工具彙總,專為混音製作、取樣準備以及卡拉OK音訊處理而設計。這些功能強大的創新工具經過實際測試,能夠實現精準的音訊分離,顯著提升工作效率。XIX.AI每週都會更新免費的付費產品對比指南,幫助您找到最適合自身需求的工具。立即探索,發揮您的AI優勢。
8 個工具
xix.ai

2026年最新最優秀的AI SQL輔助工具排名揭曉!XIX.AI精心挑選了一系列功能強大的工具,這些工具會定期更新,並透過真實的場景測試來驗證其效能。使用這些值得嘗試的工具,您可以快速生成精準的收入分析報表、分析銷售流程,並追蹤產品各項指標,從而大幅提升工作效率。立即探索,找到最適合您的資料驅動決策工具!238個字元
9 個工具
xix.ai

2026 年最新最佳頂級評分 AI 旋律創作工具,助力歌曲草稿創作!XIX.AI 精心策劃了一套極具影響力且經過嚴格真實世界測試的變革性合集,旨在提供最佳的創作體驗。您可以找到詳細的免費與付費版對比、精準的排名以及必試選項,這些工具旨在幫助您輕鬆創作出令人驚豔的歌曲草稿,並顯著提升您的創意生產力。立即探索,發現您的完美工具!
8 個工具
xix.ai

2026 年最新、最受好評的 AI 面試對話訓練工具,盡在 XIX.AI!這份精心精選的清單收錄了多款功能強大、顛覆傳統的工具,這些工具均經過嚴格的實戰測試,能提供精準的回饋。 您將在此找到免費版與付費版的比較分析,以及詳細的排名榜單,助您挑選必試的選項,從而提升自信與技能。立即探索,發掘助您在面試中脫穎而出的完美工具!
12 個工具
xix.ai

2026 年最新、最佳且評價最高的 AI 風格轉移工具,助您進行創意實驗!XIX.AI 精心精選了一系列強大且具革命性的必試工具,這些工具經實際測試與嚴格評比,能帶來卓越成果。這些頂尖解決方案能加速內容創作並開啟無盡的創意可能性,協助創作者顯著提升生產力。 立即探索,找出最適合您的工具,並從今天開始創作吧!
9 個工具
xix.ai

2026 年最新、最受好評的視覺敘事 AI 對話氣泡工具,現已登陸 XIX.AI!這份精心挑選的合集收錄了強大且具顛覆性的工具,能協助創作者提升生產力並突破創作瓶頸。 查看免費版與付費版的比較、參考實際測試結果,並查閱最新排行榜,找出最適合打造引人入勝視覺敘事的必試解決方案。立即探索,發掘您的理想工具!
10 個工具
xix.ai

Любопытно, как открытые проекты вроде OpenCUA бросят вызов гигантам вроде OpenAI. Может, наконец-то появится реальная альтернатива? Хотя, конечно, всегда есть опасения по поводу безопасности таких агентов — вдруг начнут делать что-то не то? 😅












