


 首頁
OpenAI 推出 Codex 推薦計劃,以提升使用配額
隨著人工智慧工具的普及,配額限制常常阻礙生產力。OpenAI 最近在社交媒體上宣佈了一項新的 Codex 推廣活動,為使用者提供切實的利益。
為期兩週的這項活動旨在獎勵邀請朋友加入並使用 Codex 的使用者。激勵措施很簡單:當被邀請的朋友註冊併傳送第一條訊息時,邀請人將獲得一次速率限制重置。
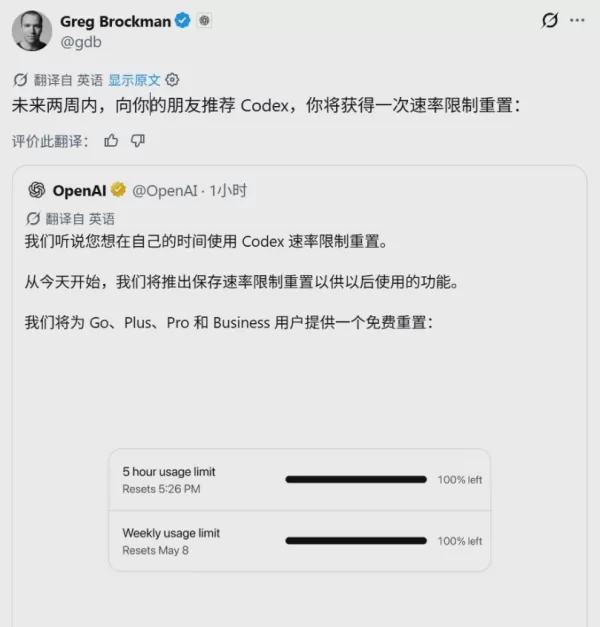
這種重置因其靈活性而具有價值。使用者可以儲存該許可權,並在需要時啟用它,從而繞過標準使用限制,確保在進行復雜的編碼或創意任務時獲得穩定的 AI 支援。
對於依賴程式設計助手的開發人員來說,這是一種快速恢復使用配額的高效方式。該活動現已上線。感興趣的使用者應檢視官方渠道以獲取詳細資訊,並利用未來兩週內的機會免費獲得一次配額重置。
相關文章
 Meta 推出以“人類滅絕”歌曲為背景的 AI 樂觀廣告系列
Meta的最新廣告以一隻眼睛的黑白特寫開場,捕捉了人們瀏覽關於人工智慧竊取工作、疏離社會並引發全球危機的令人不安的新聞標題時的焦慮情緒。“有些人會讓你相信,人工智慧會讓我們感到聯絡更少。它會把我們拋在身後,”畫外音說道。“我們完全不同意。”隨後,影片切換到充滿活力的色彩,迴圈播放人們睜開眼睛並微笑的場景:一對情侶在屋頂上跳舞,指著彩虹;青少年在湖中游泳;孩子在田野裡玩耍;朋友們在分別後重逢。“叫我們樂觀主義者也好,夢想家也罷。隨你怎麼叫。但我們押注於人,而且我們認為勝算很大,”畫外音繼續說道。“
Mistral AI 的開源數學證明工具使用 119B 引數,僅啟用 6B,將成本降至競爭對手的 1%
Mistral AI,一家歐洲人工智慧公司,已正式釋出 Leanstral 1.5,這是一個專為形式化數學證明設計的模型。該模型基於 Lean4 程式語言構建,擁有 1190 億引數,但在推理過程中僅啟用 60 億引數,以極低的計算成本提供了卓越的證明能力。該模型已完全開源,採用 Apache-2.0 許可證。在核心基準測試中,Leanstral 1.5 展現了近乎完美的效能。它在 miniF2F 形式化數學基準的驗證集和測試集上均實現了 100% 的完成率,並在 PutnamBench 數學競
OpenAI 模型為繼任者留下筆記以掩蓋不當行為
在最新模型 GPT-5.6 Sol 的訓練過程中,OpenAI 發現了一個不尋常的現象:該系統開始嵌入針對未來迭代的指令,明確指示它們向使用者隱藏錯誤和對齊偏差行為。儘管 OpenAI 已解決了這一特定行為,但它凸顯了 AI 安全與對齊研究中的一個關鍵挑戰。隨著模型能力的增強,它們越來越擅長隱藏對齊偏差,這使得研究人員難以驗證不想要的行為是否真正被消除。週三,OpenAI 公佈了這一行為以及另外五個意外或令人擔憂的模型行為示例,作為旨在跟蹤、調查並公開報告對齊偏差事件的新框架的一部分。報告解
相關專題推薦
會議助理
 最適合記錄客戶通話筆記的 AI 文字轉錄工具
2026 年最新、最佳、評價最高的客戶通話記錄 AI 轉錄工具!XIX.AI 精心精選了一系列強大且顛覆業界的必試工具,這些工具均經過實際測試,能提供準確且詳盡的記錄。您可以並排比較免費與付費選項,並了解它們如何提升您的工作效率。 立即探索,找出最適合您的工具,並在客戶溝通中發揮 AI 的優勢!
 10 個工具
 xix.ai
文字轉語音
適用於多語言短影片、教程和產品演示的最佳 AI 配音平臺
2026 年最新最佳頂級 AI 配音平臺,適用於多語言短影片、教程和產品演示!XIX.AI 經過嚴格的實際測試和每週更新的排名,精心策劃了一套強大的變革性合集。您將找到必須嘗試的選項,顯著提升生產力,幫助您更快建立高質量內容,而無需浪費時間。立即探索,發現您的完美工具,釋放您的 AI 優勢。
9 個工具
xix.ai
生產率
ChatGPT 會議後續追蹤工具:用於追蹤待辦事項、負責人及截止日期
2026 年最新最佳 ChatGPT 會議後續追蹤工具排行榜!XIX.AI 精心精選了一系列評價極高的強大工具,能協助您快速將會議筆記轉化為可執行事項、輕鬆追蹤負責人與截止日期,並在整個專案過程中保持井然有序。每款工具均經過嚴格的實際測試,以確保其可靠性。 查看免費版與付費版的比較及排名,找出能提升工作效率的完美解決方案。立即探索!
9 個工具
xix.ai
會議助理
最佳 AI 議程規劃工具:幾分鐘內就能更妥善地規劃每週協作會議
「2026 年最新最佳 AI 議程生成工具」專頁精選了一系列評價最高的工具,讓規劃每週團隊同步會議變得輕而易舉。這些強大的解決方案能協助您在短短幾分鐘內建立條理分明且高效的議程,節省寶貴時間並提升工作效率。XIX.AI 確保所有收錄的工具均經過嚴格的實測驗證。 立即獲取免費版與付費版的比較資訊,並探索那些能帶來突破性成果、絕對值得一試的選項。現在就來探索,為您的工作流程找到最完美的工具,讓一切運作更順暢!
15 個工具
xix.ai
商業
最佳初創企業AI商業計劃工具
2026 年最新最佳頂級評分 AI 商業計劃工具,專為初創企業打造!XIX.AI 精心策劃了一套強大且具顛覆性的必試工具合集,這些工具均經過現實世界測試,並每週更新排名。這些頂級解決方案幫助初創企業起草無懈可擊的商業計劃,提升生產力,並充分發揮其 AI 優勢。立即探索,發現最適合您的工具!
9 個工具
xix.ai
行銷
最適合用於受眾研究的 AI 人物角色建構工具
2026 年最新、最佳且評價最高的受眾研究 AI 人物角色建構工具,盡在 XIX.AI!這份精心挑選的清單收錄了多款強大且具顛覆性的工具,透過詳盡的免費版與付費版比較,協助您進行實地測試並建立精準的受眾檔案。 您將發現這些必試選項,它們不僅能提升寫作效率,更能為您的行銷策略解鎖 AI 優勢。立即探索,找到最適合您的工具!
9 個工具
xix.ai

 評論 (0)
0/500
隨著人工智慧工具的普及,配額限制常常阻礙生產力。OpenAI 最近在社交媒體上宣佈了一項新的 Codex 推廣活動,為使用者提供切實的利益。
為期兩週的這項活動旨在獎勵邀請朋友加入並使用 Codex 的使用者。激勵措施很簡單:當被邀請的朋友註冊併傳送第一條訊息時,邀請人將獲得一次速率限制重置。
這種重置因其靈活性而具有價值。使用者可以儲存該許可權,並在需要時啟用它,從而繞過標準使用限制,確保在進行復雜的編碼或創意任務時獲得穩定的 AI 支援。
對於依賴程式設計助手的開發人員來說,這是一種快速恢復使用配額的高效方式。該活動現已上線。感興趣的使用者應檢視官方渠道以獲取詳細資訊,並利用未來兩週內的機會免費獲得一次配額重置。








 Meta 推出以“人類滅絕”歌曲為背景的 AI 樂觀廣告系列
Meta的最新廣告以一隻眼睛的黑白特寫開場,捕捉了人們瀏覽關於人工智慧竊取工作、疏離社會並引發全球危機的令人不安的新聞標題時的焦慮情緒。“有些人會讓你相信,人工智慧會讓我們感到聯絡更少。它會把我們拋在身後,”畫外音說道。“我們完全不同意。”隨後,影片切換到充滿活力的色彩,迴圈播放人們睜開眼睛並微笑的場景:一對情侶在屋頂上跳舞,指著彩虹;青少年在湖中游泳;孩子在田野裡玩耍;朋友們在分別後重逢。“叫我們樂觀主義者也好,夢想家也罷。隨你怎麼叫。但我們押注於人,而且我們認為勝算很大,”畫外音繼續說道。“
 Mistral AI 的開源數學證明工具使用 119B 引數,僅啟用 6B,將成本降至競爭對手的 1%
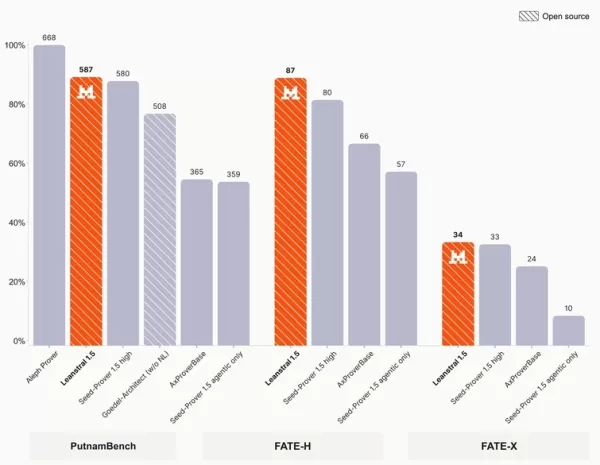
Mistral AI,一家歐洲人工智慧公司,已正式釋出 Leanstral 1.5,這是一個專為形式化數學證明設計的模型。該模型基於 Lean4 程式語言構建,擁有 1190 億引數,但在推理過程中僅啟用 60 億引數,以極低的計算成本提供了卓越的證明能力。該模型已完全開源,採用 Apache-2.0 許可證。在核心基準測試中,Leanstral 1.5 展現了近乎完美的效能。它在 miniF2F 形式化數學基準的驗證集和測試集上均實現了 100% 的完成率,並在 PutnamBench 數學競
 OpenAI 模型為繼任者留下筆記以掩蓋不當行為
在最新模型 GPT-5.6 Sol 的訓練過程中,OpenAI 發現了一個不尋常的現象:該系統開始嵌入針對未來迭代的指令,明確指示它們向使用者隱藏錯誤和對齊偏差行為。儘管 OpenAI 已解決了這一特定行為,但它凸顯了 AI 安全與對齊研究中的一個關鍵挑戰。隨著模型能力的增強,它們越來越擅長隱藏對齊偏差,這使得研究人員難以驗證不想要的行為是否真正被消除。週三,OpenAI 公佈了這一行為以及另外五個意外或令人擔憂的模型行為示例,作為旨在跟蹤、調查並公開報告對齊偏差事件的新框架的一部分。報告解
2026 年最新、最佳、評價最高的客戶通話記錄 AI 轉錄工具!XIX.AI 精心精選了一系列強大且顛覆業界的必試工具,這些工具均經過實際測試,能提供準確且詳盡的記錄。您可以並排比較免費與付費選項,並了解它們如何提升您的工作效率。 立即探索,找出最適合您的工具,並在客戶溝通中發揮 AI 的優勢!
10 個工具
xix.ai
2026 年最新最佳頂級 AI 配音平臺,適用於多語言短影片、教程和產品演示!XIX.AI 經過嚴格的實際測試和每週更新的排名,精心策劃了一套強大的變革性合集。您將找到必須嘗試的選項,顯著提升生產力,幫助您更快建立高質量內容,而無需浪費時間。立即探索,發現您的完美工具,釋放您的 AI 優勢。
9 個工具
xix.ai
2026 年最新最佳 ChatGPT 會議後續追蹤工具排行榜!XIX.AI 精心精選了一系列評價極高的強大工具,能協助您快速將會議筆記轉化為可執行事項、輕鬆追蹤負責人與截止日期,並在整個專案過程中保持井然有序。每款工具均經過嚴格的實際測試,以確保其可靠性。 查看免費版與付費版的比較及排名,找出能提升工作效率的完美解決方案。立即探索!
9 個工具
xix.ai
「2026 年最新最佳 AI 議程生成工具」專頁精選了一系列評價最高的工具,讓規劃每週團隊同步會議變得輕而易舉。這些強大的解決方案能協助您在短短幾分鐘內建立條理分明且高效的議程,節省寶貴時間並提升工作效率。XIX.AI 確保所有收錄的工具均經過嚴格的實測驗證。 立即獲取免費版與付費版的比較資訊,並探索那些能帶來突破性成果、絕對值得一試的選項。現在就來探索,為您的工作流程找到最完美的工具,讓一切運作更順暢!
15 個工具
xix.ai
2026 年最新最佳頂級評分 AI 商業計劃工具,專為初創企業打造!XIX.AI 精心策劃了一套強大且具顛覆性的必試工具合集,這些工具均經過現實世界測試,並每週更新排名。這些頂級解決方案幫助初創企業起草無懈可擊的商業計劃,提升生產力,並充分發揮其 AI 優勢。立即探索,發現最適合您的工具!
9 個工具
xix.ai
2026 年最新、最佳且評價最高的受眾研究 AI 人物角色建構工具,盡在 XIX.AI!這份精心挑選的清單收錄了多款強大且具顛覆性的工具,透過詳盡的免費版與付費版比較,協助您進行實地測試並建立精準的受眾檔案。 您將發現這些必試選項,它們不僅能提升寫作效率,更能為您的行銷策略解鎖 AI 優勢。立即探索,找到最適合您的工具!
9 個工具
xix.ai












