


 首頁
康維生物獲貝瑟默創投及科技領袖注資2500萬美元
人工智慧在藥物研發領域正急速發展,隨著製藥與生物科技公司試圖縮短研發週期數年並提升成功率,同時面對不斷攀升的成本壓力。目前已有超過200家新創企業競相將人工智慧直接整合至研究工作流程,吸引投資者日益關注。Converge Bio是最新把握此趨勢的公司,在人工智慧驅動的藥物發現領域競爭加劇之際成功獲得新一輪融資。
這家總部位於波士頓與特拉維夫的新創公司,透過運用以分子數據訓練的生成式人工智慧協助製藥與生物科技企業加速藥物開發,在貝瑟默創投領投下完成超額認購的2500萬美元A輪融資。TLV Partners與Vintage Investment Partners亦參與投資,並獲得Meta、OpenAI及Wiz匿名高管的額外支持。
實際運作中,Converge透過DNA、RNA及蛋白質序列訓練生成式模型,再將其整合至製藥與生物技術工作流程以加速藥物開發。
Converge Bio執行長暨共同創辦人Dov Gertz在TechCrunch獨家專訪中表示:「藥物開發生命週期涵蓋明確階段——從目標識別與發現到製造、臨床試驗及後續流程——每個階段皆存在我們能支援的實驗環節。我們的平台持續橫跨這些階段擴展,協助新藥更快進入市場。」
目前Converge已推出面向客戶的系統,該新創公司已發表三套獨立人工智慧系統:分別專注於抗體設計、蛋白質產量優化,以及生物標記與目標發現。
「以我們的抗體設計系統為例,它並非單一模型,而是由三個整合組件構成:首先,生成模型創造新型抗體; 接著,預測模型依據分子特性篩選抗體;最後,基於物理學模型的對接系統模擬抗體與靶點間的三維相互作用。」執行長葛茲補充道。他強調價值在於整體系統而非單一模型:「客戶無需自行組裝模型,我們提供可直接整合至工作流程的即用型系統。」
這筆新資金是在該公司於2024年完成550萬美元種子輪融資約一年半後到位。
Techcrunch活動 加入 Disrupt 2026 候補名單
立即加入Disrupt 2026候補名單,搶先掌握早鳥票開售資訊。 歷屆Disrupt大會曾邀得Google Cloud、Netflix、Microsoft、Box、Phia、a16z、ElevenLabs、Wayve、Hugging Face、Elad Gil及Vinod Khosla等業界巨擘登台——逾250位領袖驅動200多場專題議程,助您加速成長並強化競爭優勢。更可與橫跨各領域的數百家新創企業建立連結。
加入Disrupt 2026候補名單
立即加入 Disrupt 2026 候補名單,搶先掌握早鳥票開售資訊。 歷屆Disrupt盛會曾邀集Google Cloud、Netflix、Microsoft、Box、Phia、a16z、ElevenLabs、Wayve、Hugging Face、Elad Gil及Vinod Khosla等業界巨擘登台——逾250位領袖驅動的200餘場議程,專為助您加速成長、強化競爭優勢而設計。更可與橫跨各領域的數百家創新新創企業建立連結。
舊金山 | 2026年10月13-15日 立即加入候補名單 自成立以來,這家兩歲初創企業已實現快速擴張。Gertz表示,Converge已與40家製藥及生物科技公司建立合作夥伴關係,目前平台上管理著約40個專案。其客戶遍及美國、加拿大、歐洲及以色列,現正積極拓展亞洲市場。
團隊規模亦快速擴張,從2024年11月的9名員工增至34人。在此過程中,Converge開始發布公開案例研究。格茨指出,其中一項案例中,該新創企業協助合作夥伴在單次運算迭代中將蛋白質產量提升4至4.5倍;另一案例則成功生成結合親和力達單納摩爾級別的超高親和力抗體。
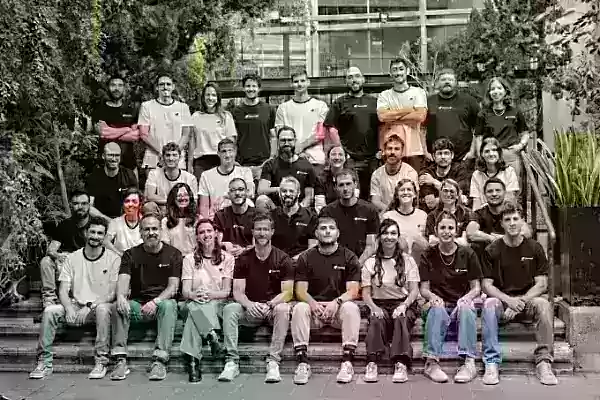
圖片來源:Converge Bio 人工智慧驅動的藥物發現正展現強勁動能。去年禮來公司與英偉達合作,打造業界號稱最強大的藥物發現超級電腦。2024年10月,Google DeepMind旗下AlphaFold專案開發團隊更憑藉能預測蛋白質結構的人工智慧系統,榮獲諾貝爾化學獎。
當被問及這股勢頭如何影響Converge Bio的發展時,格茨表示公司正見證生命科學史上最大的財務契機,整個產業正從「試錯法」轉型為數據驅動的分子設計。
「我們強烈感受到這股動能,尤其在收件匣中。一年半前創立公司時,外界仍存有相當程度的懷疑,」格茨向TechCrunch透露。他補充道,得益於Converge等企業與學術界的成功案例,這份懷疑已迅速消散。
大型語言模型因能分析生物序列並提出新分子而受到藥物發現領域的關注,但「幻覺」現象與準確性等挑戰依然存在。「在文本中,幻覺通常容易被發現,」這位執行長表示。 「在分子領域,驗證新化合物可能耗時數週,成本遠高於文字分析。」為解決此問題,Converge結合生成式模型與預測式模型,透過篩選新分子降低風險並提升合作夥伴成果。「此篩選機制雖非完美,但能顯著降低風險並為客戶創造更佳成效。」格茨補充道。
TechCrunch同時探詢了對LLM持保留態度的專家如Yann LeCun的觀點。「我極敬重Yann LeCun,完全認同他的見解。核心科學理解不應依賴文本模型。要真正掌握生物學,模型必須以DNA、RNA、蛋白質及小分子進行訓練。」Gertz如此闡釋。
基於文本的LLM僅作為輔助工具使用,例如協助客戶梳理已生成分子的文獻資料。「它們並非我們的核心技術,」格茨強調,「我們不受單一架構束縛,會根據需求靈活運用LLM、擴散模型、傳統機器學習及統計方法。」
「我們的願景是讓每家生命科學機構都將Converge Bio作為其生成式AI實驗室。實體實驗室將永遠存在,但它們將由能透過計算創建假說與分子的生成式實驗室所輔助。我們致力成為整個產業的生成式實驗室。」格茨表示。
相關文章
 科大訊飛釋出訊飛星火大模型 V2.5
9月1日,科大訊飛將開源兩款面向邊緣場景的大語言模型——星火X2.5-4B和星火X2.5-1.7B,據最新官方公告。這兩款模型原生支援高達100萬token的上下文視窗。它們在智慧體互動、數學推理和通用理解等關鍵領域實現了顯著提升,為車載系統、智慧裝置和物聯網生態等邊緣應用提供了強有力的支援。在上述邊緣模型釋出後,科大訊飛計劃於9月7日推出擁有2930億引數的星火X2.5基礎模型。該版本將進一步推進程式碼生成和多智慧體協作等核心技術。在公司2026年年中簡報會上宣佈,一款完全基於國產算力基礎設施
Meta 在使用者強烈反對後取消了 AI 照片編輯功能
Meta,這家社交媒體巨頭,再次捲入關於人工智慧與使用者隱私之間微妙平衡的公開辯論。據 TechCrunch 報道,Meta 的 Superintelligence Labs 本週早些時候推出了一款新的 AI 影象生成器 Muse Image。然而,一個備受好評的關鍵功能——允許使用者透過“@”符號標記來修改和生成來自公開 Instagram 賬戶的影象——由於缺乏適當的通知機制,立即引發了使用者以及 CAA 等機構的強烈反對。面對強烈的批評,Meta 迅速撤銷了該決定,並於週五透過部落格文章宣佈將
DeepMind執行長哈西里斯:我每天睡六個小時,通常在凌晨1點左右感到精力充沛。
Fortune 最近刊登了對谷歌 DeepMind 執行長 Demis Hassabis 的採訪,揭示了他對休息和生產力的非傳統方法。Hassabis 透露,他睡眠時間非常少,將清醒時間劃分為兩個不同的工作階段。關於他的睡眠習慣,Hassabis 表示:“我目標睡六小時,但我的習慣非同尋常。我可以在白天有效運作。”他強調,睡眠少於六小時會對大腦健康產生負面影響。Hassabis 於 2010 年聯合創立了 DeepMind(後被谷歌收購),並因其在蛋白質結構預測方面的開創性工作榮獲 20
相關專題推薦
動畫創作
 適用於社群媒體內容的 AI 場景動畫工具
XIX.AI 在此精選了 2026 年最新、最佳且評價最高的社群媒體內容 AI 場景動畫工具。這些強大且顛覆業界的工具不僅提供實際測試結果,更包含詳盡的免費版與付費版比較,能協助創作者大幅提升工作效率。立即探索,釋放您的 AI 優勢。
 9 個工具
 xix.ai
視頻創作
適用於 Reels、Shorts 及產品上市活動的 AI 短影片吸睛開場生成器
2026 年最新最佳 AI 短影片開場白生成器,適用於 Reels、Shorts 及產品上市活動!XIX.AI 嚴選備受好評、功能強大且能顛覆遊戲規則的工具,這些工具皆經過實際測試,能帶來絕對值得一試的成果。本頁面每週更新,提供免費與付費版本的比較排行榜,助您找到提升內容創意與生產力的完美解決方案。 立即探索,釋放您的 AI 競爭優勢!
11 個工具
xix.ai
寫作
適用於長篇寫作的 AI 文章大綱工具
2026 年最新、最受好評的長文寫作 AI 大綱工具!這份精選清單收錄了強大且具顛覆性的工具,能透過實際測試生成精準、結構化的大綱,大幅提升寫作效率。XIX.AI 正是這份菁英名單中的一員。 獲取免費版與付費版的比較指南,助您挑選最合適的工具。立即探索,釋放您的 AI 優勢!
9 個工具
xix.ai
聊天機器人
用於語言練習、面試準備和日常流利度的最佳 AI 角色扮演聊天應用
2026 年最新最佳頂級評分 AI 角色扮演聊天應用,用於語言練習、面試準備和日常流利度!XIX.AI 精心策劃了一個強大的變革性合集,提供免費與付費對比、真實世界測試以及每週更新的排名。這些必試工具可幫助您提升寫作技能,克服流利度挑戰,並提高所有日常場景下的溝通效率。立即探索,發現您語言成長的完美工具!
10 個工具
xix.ai
音樂創作
用於混音製作、取樣準備及卡拉OK母帶處理的 AI 聲部分離工具
2026年最新、最優秀且評分最高的AI音軌分離工具彙總,專為混音製作、取樣準備以及卡拉OK音訊處理而設計。這些功能強大的創新工具經過實際測試,能夠實現精準的音訊分離,顯著提升工作效率。XIX.AI每週都會更新免費的付費產品對比指南,幫助您找到最適合自身需求的工具。立即探索,發揮您的AI優勢。
8 個工具
xix.ai
數據分析
用於收入看板、轉化漏斗分析及產品指標分析的 AI SQL 助手
2026年最新最優秀的AI SQL輔助工具排名揭曉!XIX.AI精心挑選了一系列功能強大的工具,這些工具會定期更新,並透過真實的場景測試來驗證其效能。使用這些值得嘗試的工具,您可以快速生成精準的收入分析報表、分析銷售流程,並追蹤產品各項指標,從而大幅提升工作效率。立即探索,找到最適合您的資料驅動決策工具!238個字元
9 個工具
xix.ai

 評論 (2)
0/500
![EdwardSmith]()
Finally, some real money flowing into AI drug discovery. But with 200 startups, how many will actually deliver? 🤔
![WilliamYoung]()
25 Millionen für AI in der Medikamentenentwicklung? Das Feld wird ja immer voller. Bessemer ist natürlich ein großer Name, aber bei über 200 Startups frage ich mich, wie viele in 5 Jahren noch übrig sind. Die Kosten im Pharmabereich sind wirklich explodiert, also klar, dass man nach effizienteren Wegen sucht. Hoffentlich führt das nicht nur zu schnelleren, sondern auch zu besseren und sichereren Therapien. Die ethischen Fragen bei AI-gestützter Forschung sollte man dabei aber nicht aus den Augen verlieren. Spannende Zeiten! 🤔
人工智慧在藥物研發領域正急速發展,隨著製藥與生物科技公司試圖縮短研發週期數年並提升成功率,同時面對不斷攀升的成本壓力。目前已有超過200家新創企業競相將人工智慧直接整合至研究工作流程,吸引投資者日益關注。Converge Bio是最新把握此趨勢的公司,在人工智慧驅動的藥物發現領域競爭加劇之際成功獲得新一輪融資。
這家總部位於波士頓與特拉維夫的新創公司,透過運用以分子數據訓練的生成式人工智慧協助製藥與生物科技企業加速藥物開發,在貝瑟默創投領投下完成超額認購的2500萬美元A輪融資。TLV Partners與Vintage Investment Partners亦參與投資,並獲得Meta、OpenAI及Wiz匿名高管的額外支持。
實際運作中,Converge透過DNA、RNA及蛋白質序列訓練生成式模型,再將其整合至製藥與生物技術工作流程以加速藥物開發。
Converge Bio執行長暨共同創辦人Dov Gertz在TechCrunch獨家專訪中表示:「藥物開發生命週期涵蓋明確階段——從目標識別與發現到製造、臨床試驗及後續流程——每個階段皆存在我們能支援的實驗環節。我們的平台持續橫跨這些階段擴展,協助新藥更快進入市場。」
目前Converge已推出面向客戶的系統,該新創公司已發表三套獨立人工智慧系統:分別專注於抗體設計、蛋白質產量優化,以及生物標記與目標發現。
「以我們的抗體設計系統為例,它並非單一模型,而是由三個整合組件構成:首先,生成模型創造新型抗體; 接著,預測模型依據分子特性篩選抗體;最後,基於物理學模型的對接系統模擬抗體與靶點間的三維相互作用。」執行長葛茲補充道。他強調價值在於整體系統而非單一模型:「客戶無需自行組裝模型,我們提供可直接整合至工作流程的即用型系統。」
這筆新資金是在該公司於2024年完成550萬美元種子輪融資約一年半後到位。
Techcrunch活動加入 Disrupt 2026 候補名單
立即加入Disrupt 2026候補名單,搶先掌握早鳥票開售資訊。 歷屆Disrupt大會曾邀得Google Cloud、Netflix、Microsoft、Box、Phia、a16z、ElevenLabs、Wayve、Hugging Face、Elad Gil及Vinod Khosla等業界巨擘登台——逾250位領袖驅動200多場專題議程,助您加速成長並強化競爭優勢。更可與橫跨各領域的數百家新創企業建立連結。
加入Disrupt 2026候補名單
立即加入 Disrupt 2026 候補名單,搶先掌握早鳥票開售資訊。 歷屆Disrupt盛會曾邀集Google Cloud、Netflix、Microsoft、Box、Phia、a16z、ElevenLabs、Wayve、Hugging Face、Elad Gil及Vinod Khosla等業界巨擘登台——逾250位領袖驅動的200餘場議程,專為助您加速成長、強化競爭優勢而設計。更可與橫跨各領域的數百家創新新創企業建立連結。
舊金山 | 2026年10月13-15日 立即加入候補名單自成立以來,這家兩歲初創企業已實現快速擴張。Gertz表示,Converge已與40家製藥及生物科技公司建立合作夥伴關係,目前平台上管理著約40個專案。其客戶遍及美國、加拿大、歐洲及以色列,現正積極拓展亞洲市場。
團隊規模亦快速擴張,從2024年11月的9名員工增至34人。在此過程中,Converge開始發布公開案例研究。格茨指出,其中一項案例中,該新創企業協助合作夥伴在單次運算迭代中將蛋白質產量提升4至4.5倍;另一案例則成功生成結合親和力達單納摩爾級別的超高親和力抗體。
人工智慧驅動的藥物發現正展現強勁動能。去年禮來公司與英偉達合作,打造業界號稱最強大的藥物發現超級電腦。2024年10月,Google DeepMind旗下AlphaFold專案開發團隊更憑藉能預測蛋白質結構的人工智慧系統,榮獲諾貝爾化學獎。
當被問及這股勢頭如何影響Converge Bio的發展時,格茨表示公司正見證生命科學史上最大的財務契機,整個產業正從「試錯法」轉型為數據驅動的分子設計。
「我們強烈感受到這股動能,尤其在收件匣中。一年半前創立公司時,外界仍存有相當程度的懷疑,」格茨向TechCrunch透露。他補充道,得益於Converge等企業與學術界的成功案例,這份懷疑已迅速消散。
大型語言模型因能分析生物序列並提出新分子而受到藥物發現領域的關注,但「幻覺」現象與準確性等挑戰依然存在。「在文本中,幻覺通常容易被發現,」這位執行長表示。 「在分子領域,驗證新化合物可能耗時數週,成本遠高於文字分析。」為解決此問題,Converge結合生成式模型與預測式模型,透過篩選新分子降低風險並提升合作夥伴成果。「此篩選機制雖非完美,但能顯著降低風險並為客戶創造更佳成效。」格茨補充道。
TechCrunch同時探詢了對LLM持保留態度的專家如Yann LeCun的觀點。「我極敬重Yann LeCun,完全認同他的見解。核心科學理解不應依賴文本模型。要真正掌握生物學,模型必須以DNA、RNA、蛋白質及小分子進行訓練。」Gertz如此闡釋。
基於文本的LLM僅作為輔助工具使用,例如協助客戶梳理已生成分子的文獻資料。「它們並非我們的核心技術,」格茨強調,「我們不受單一架構束縛,會根據需求靈活運用LLM、擴散模型、傳統機器學習及統計方法。」
「我們的願景是讓每家生命科學機構都將Converge Bio作為其生成式AI實驗室。實體實驗室將永遠存在,但它們將由能透過計算創建假說與分子的生成式實驗室所輔助。我們致力成為整個產業的生成式實驗室。」格茨表示。








 科大訊飛釋出訊飛星火大模型 V2.5
9月1日,科大訊飛將開源兩款面向邊緣場景的大語言模型——星火X2.5-4B和星火X2.5-1.7B,據最新官方公告。這兩款模型原生支援高達100萬token的上下文視窗。它們在智慧體互動、數學推理和通用理解等關鍵領域實現了顯著提升,為車載系統、智慧裝置和物聯網生態等邊緣應用提供了強有力的支援。在上述邊緣模型釋出後,科大訊飛計劃於9月7日推出擁有2930億引數的星火X2.5基礎模型。該版本將進一步推進程式碼生成和多智慧體協作等核心技術。在公司2026年年中簡報會上宣佈,一款完全基於國產算力基礎設施
 Meta 在使用者強烈反對後取消了 AI 照片編輯功能
Meta,這家社交媒體巨頭,再次捲入關於人工智慧與使用者隱私之間微妙平衡的公開辯論。據 TechCrunch 報道,Meta 的 Superintelligence Labs 本週早些時候推出了一款新的 AI 影象生成器 Muse Image。然而,一個備受好評的關鍵功能——允許使用者透過“@”符號標記來修改和生成來自公開 Instagram 賬戶的影象——由於缺乏適當的通知機制,立即引發了使用者以及 CAA 等機構的強烈反對。面對強烈的批評,Meta 迅速撤銷了該決定,並於週五透過部落格文章宣佈將
 DeepMind執行長哈西里斯:我每天睡六個小時,通常在凌晨1點左右感到精力充沛。
Fortune 最近刊登了對谷歌 DeepMind 執行長 Demis Hassabis 的採訪,揭示了他對休息和生產力的非傳統方法。Hassabis 透露,他睡眠時間非常少,將清醒時間劃分為兩個不同的工作階段。關於他的睡眠習慣,Hassabis 表示:“我目標睡六小時,但我的習慣非同尋常。我可以在白天有效運作。”他強調,睡眠少於六小時會對大腦健康產生負面影響。Hassabis 於 2010 年聯合創立了 DeepMind(後被谷歌收購),並因其在蛋白質結構預測方面的開創性工作榮獲 20

XIX.AI 在此精選了 2026 年最新、最佳且評價最高的社群媒體內容 AI 場景動畫工具。這些強大且顛覆業界的工具不僅提供實際測試結果,更包含詳盡的免費版與付費版比較,能協助創作者大幅提升工作效率。立即探索,釋放您的 AI 優勢。
9 個工具
xix.ai

2026 年最新最佳 AI 短影片開場白生成器,適用於 Reels、Shorts 及產品上市活動!XIX.AI 嚴選備受好評、功能強大且能顛覆遊戲規則的工具,這些工具皆經過實際測試,能帶來絕對值得一試的成果。本頁面每週更新,提供免費與付費版本的比較排行榜,助您找到提升內容創意與生產力的完美解決方案。 立即探索,釋放您的 AI 競爭優勢!
11 個工具
xix.ai

2026 年最新、最受好評的長文寫作 AI 大綱工具!這份精選清單收錄了強大且具顛覆性的工具,能透過實際測試生成精準、結構化的大綱,大幅提升寫作效率。XIX.AI 正是這份菁英名單中的一員。 獲取免費版與付費版的比較指南,助您挑選最合適的工具。立即探索,釋放您的 AI 優勢!
9 個工具
xix.ai

2026 年最新最佳頂級評分 AI 角色扮演聊天應用,用於語言練習、面試準備和日常流利度!XIX.AI 精心策劃了一個強大的變革性合集,提供免費與付費對比、真實世界測試以及每週更新的排名。這些必試工具可幫助您提升寫作技能,克服流利度挑戰,並提高所有日常場景下的溝通效率。立即探索,發現您語言成長的完美工具!
10 個工具
xix.ai

2026年最新、最優秀且評分最高的AI音軌分離工具彙總,專為混音製作、取樣準備以及卡拉OK音訊處理而設計。這些功能強大的創新工具經過實際測試,能夠實現精準的音訊分離,顯著提升工作效率。XIX.AI每週都會更新免費的付費產品對比指南,幫助您找到最適合自身需求的工具。立即探索,發揮您的AI優勢。
8 個工具
xix.ai

2026年最新最優秀的AI SQL輔助工具排名揭曉!XIX.AI精心挑選了一系列功能強大的工具,這些工具會定期更新,並透過真實的場景測試來驗證其效能。使用這些值得嘗試的工具,您可以快速生成精準的收入分析報表、分析銷售流程,並追蹤產品各項指標,從而大幅提升工作效率。立即探索,找到最適合您的資料驅動決策工具!238個字元
9 個工具
xix.ai

Finally, some real money flowing into AI drug discovery. But with 200 startups, how many will actually deliver? 🤔
25 Millionen für AI in der Medikamentenentwicklung? Das Feld wird ja immer voller. Bessemer ist natürlich ein großer Name, aber bei über 200 Startups frage ich mich, wie viele in 5 Jahren noch übrig sind. Die Kosten im Pharmabereich sind wirklich explodiert, also klar, dass man nach effizienteren Wegen sucht. Hoffentlich führt das nicht nur zu schnelleren, sondern auch zu besseren und sichereren Therapien. Die ethischen Fragen bei AI-gestützter Forschung sollte man dabei aber nicht aus den Augen verlieren. Spannende Zeiten! 🤔












