


 Дом
Система Gemini Omni от Google создает видео на основе изображений, аудиозаписей и текста
Три года назад компания Google представила проект Gemini с целью создания мультимодальной большой языковой модели — единой нейронной сети, обученной на тексте, изображениях, аудио и видео, способной генерировать контент во всех этих форматах.
На сегодняшней конференции разработчиков Google I/O компания сделала шаг к реализации этой концепции, представив Gemini Omni — новое семейство мультимодальных моделей. Генеральный директор Google Сундар Пичаи заявил, что Omni позволит пользователям «создавать что угодно из любого входного материала».
Первоначально Omni сосредоточится на видео. Теперь пользователи могут комбинировать изображения, аудио, видео и текст. Вместо того чтобы просто сшивать эти элементы вместе, Omni интеллектуально анализирует все модальности, чтобы создать связный результат. Это приводит к созданию высококачественных видеороликов, демонстрирующих понимание физики, культуры, истории и науки.
Omni также позволяет пользователям редактировать фотографии с помощью простых текстовых команд, устраняя необходимость в сложном программном обеспечении, аналогично инструменту Google Nano Banana.
Google уже предлагает Veo — специализированную видеомодель, которая преобразует текст и изображения в видео и позволяет управлять аватарами и настраивать их. Однако Николь Брихтово, директор по управлению продуктами в Google DeepMind, подчеркнула, что сегодняшний релиз представляет собой нечто большее, чем просто обновление Veo: «Это следующий шаг в объединении интеллекта Gemini с возможностями рендеринга наших медиа-моделей».
Во время брифинга для СМИ в понедельник главный технолог DeepMind Корай Кавукчуоглу привел пример: когда ему предложили «пояснительное видео с пластилиновой анимацией о сворачивании белков», Omni быстро сгенерировал стоп-моушн-видео с закадровым голосом, объясняющим: «Белки начинаются как цепочки аминокислот. Они сворачиваются в структуры, такие как альфа-спирали и плоские участки, называемые бета-листами, в конечном итоге образуя точную трехмерную форму».
Долгосрочная перспектива для Omni более широка и включает в себя такие возможности, как генерация изображений из аудио или аудио из видео.
«Когда мы впервые анонсировали Gemini, это была наша первая изначально мультимодальная модель ИИ», — отметил Пичаи во время брифинга. «Мы знали, что обучение ее на комбинации текста, кода, аудио, изображений и видео приведет к более глубокому пониманию мира. С помощью моделей мира ИИ эволюционирует от предсказания текста к моделированию реальности. Gemini Omni — это следующий шаг в этом направлении».
В рамках этого релиза пользователи также смогут создавать видео с участием своих собственных цифровых аватаров — функция, популяризованная приложением Sora от OpenAI (ныне снятым с производства) с помощью Cameos. По словам Брихтовой, для предотвращения появления дипфейков пользователи должны пройти специальный процесс регистрации, который включает в себя запись себя на видео, произнося серию цифр. Затем аватар сохраняется для дальнейшего использования.
Кроме того, все видео, созданные с помощью Omni, будут содержать цифровой водяной знак SynthID от Google, что позволит пользователям проверять, был ли контент сгенерирован с помощью продуктов Gemini.
Первой моделью в семействе является Gemini Omni Flash, запускаемая сегодня в приложении Gemini, YouTube Shorts и студии искусственного интеллекта Flow. Flash может рендерить 10-секундные видео. Брихтова пояснила, что эта продолжительность не является ограничением модели, а стратегическим решением, направленным на расширение доступности, исходя из того, что в настоящее время большинство пользователей предпочитают более короткие ролики. Поддержка более длинных видео запланирована на ближайшее будущее.
Google, похоже, позиционирует Omni Flash в первую очередь как инструмент для потребителей. Во время разговора с TechCrunch Брихтовая и инженер-исследователь DeepMind Гейб Барт-Марон описали сценарии использования аватаров как личные, например, создание видео, где вы получаете награду или посещаете Луну, или удаление постороннего человека из фона видео с отпуска.
Барт-Марон лаконично подытожил: «Они похожи на персонализированные мемы».
«Мы определенно сосредоточились на том, чтобы сделать это простым для использования потребителями», — сказала Брихтовая. «Не многие видеомодели успешно перешли на массовый потребительский рынок, так что это наша попытка сделать это».
Эта простота использования сопровождается одним предостережением: Брихтовая и Барт-Марон отметили, что подсказки для редактирования должны быть очень конкретными. В противном случае Omni может перередактировать или непреднамеренно изменить элементы, которые пользователь намеревался сохранить — с этой проблемой сталкиваются и пользователи Nano Banana.
Изображения:Google
Несмотря на непосредственную ориентацию на потребителей, потенциал Omni для корпоративных и творческих приложений очевиден. В ближайшие недели Google сделает Omni доступным через API. Ожидается, что инструмент для генерации аватаров, уже доступный в Shorts, станет популярным среди создателей контента. В более широком смысле сквозной мультимодальный рабочий процесс может революционизировать рекламу и кинопроизводство.
Стартап Luma AI разрабатывает аналогичный инструмент на базе собственной «унифицированной» модели, способный генерировать целую рекламную кампанию на основе брифа и изображения продукта.
«Мы действительно очень гордимся возможностями модели по рендерингу текста, которые очень полезны для таких приложений, как реклама», — сказала Брихтова. «Если вам нужен продукт-плейсмент или даже просто слоган, точность имеет решающее значение... Мы, безусловно, ожидаем, что кинематографисты и другие создатели контента также примут эту модель».
Для более профессиональных задач лучше подойдет готовящаяся к выпуску модель Omni Pro, разработанная для обеспечения превосходной производительности при выполнении всех задач Omni. Google пока не объявила дату выпуска Pro, но Брихтово указала, что она будет запущена, когда «мы достигнем значительного скачка в возможностях по сравнению с Flash».
Связанная статья
 Google запускает функцию обнаружения поддельных звонков для защиты от мошенничества с использованием ИИ-дипфейков, имитирующих личность
Во вторник компания Google объявила о запуске в Android функции обнаружения поддельных звонков, призванной защитить пользователей от мошенничества с использованием технологии «дипфейк» на базе искусст
Frontier AI Labs отказывается раскрывать стратегии локализации неконтролируемых моделей
Последние исследования показывают, что лишь немногие ведущие лаборатории, занимающиеся ИИ, опубликовали или продемонстрировали планы реагирования на попытки выхода системы из-под контроля. План сдержи
На конференции IO 2026 компания Google представила «умные» очки с аудиофункциями, повторив стратегию Meta
Google стратегически возвращается на рынок умных очков.Во вторник на конференции Google I/O технологический гигант объявил о сотрудничестве с Warby Parker и Gentle Monster с целью запуска новой линейк
Рекомендации по связанным специальным темам
чат-бот
 Лучшие приложения для ролевых чатов с ИИ для практики языка, подготовки к собеседованиям и ежедневной разговорной практики
2026 г. — новейшие, лучшие и наиболее рейтинговые приложения для ИИ-ролевых чатов, предназначенные для практики языка, подготовки к собеседованиям и ежедневной беглости речи! XIX.AI предлагает мощную коллекцию, меняющую правила игры: бесплатные и платные варианты, реальные тесты и обновляемые еженедельно рейтинги. Эти обязательные к использованию инструменты помогут вам улучшить навыки письма, преодолеть трудности с беглостью и повысить эффективность общения во всех повседневных ситуациях. Исследуйте сейчас, чтобы найти идеальный инструмент для развития вашего языка!
 10 инструментов
 xix.ai
Музыкальная композиция
Инструменты разделения стемов с использованием ИИ для создания ремиксов, подготовки образцов звука и формирования финальных версий караоке.
2026 год: лучшие и наиболее высоко оценённые инструменты для разделения аудиосигналов с использованием ИИ, отобранные специально для работы над ремиксами, подготовки образцов звука и создания караоке-версий. Эти мощные революционные инструменты проходят реальные тесты, обеспечивая точную изоляцию аудиосигналов и значительно повышая производительность. XIX.AI предоставляет еженедельно обновляемый бесплатный справочник сравнения платных и бесплатных решений, который поможет вам найти оптимальный вариант, соответствующий вашим потребностям. Ознакомьтесь с ним прямо сейчас, чтобы раскрыть потенциал ИИ в вашей работе.
8 инструментов
xix.ai
Анализ данных
ИИ-копилоты для SQL, предназначенные для создания панелей управления доходами, анализа воронки продаж и отслеживания показателей продуктов.
2026 год: лучшие AI-ассистенты для SQL, занявшие верхние строчки рейтингов! XIX.AI собрал мощный набор инструментов, регулярно обновляемый на основе реальных тестов. Эти неотъемлемые инструменты помогают создавать точные дашборды с данными о доходах, анализировать каналы продаж и оперативно отслеживать показатели продуктов, значительно повышая производительность. Ознакомьтесь сейчас, чтобы найти идеальный инструмент для принятия решений на основе данных! 238 символов
9 инструментов
xix.ai
Музыкальная композиция
Лучшие инструменты для написания мелодий с помощью ИИ для черновиков песен
2026 год: лучшие, топовые и высокооценённые инструменты ИИ для написания мелодий для черновиков песен! XIX.AI подобрал высокоэффективную коллекцию, меняющую правила игры, которая прошла строгие реальные испытания, чтобы обеспечить лучший опыт написания. Вы можете найти подробные сравнения бесплатных и платных версий, точные рейтинги и обязательные к использованию варианты, разработанные, чтобы помочь вам создавать потрясающие черновики песен без усилий и значительно повысить вашу творческую продуктивность. Исследуйте сейчас, чтобы найти свой идеальный инструмент!
8 инструментов
xix.ai
чат-бот
Лучшие инструменты для тренировки разговоров с помощью ИИ для подготовки к собеседованиям
2026 г. — новейшие, лучшие и наиболее высоко оцененные инструменты для тренировки разговорных навыков с помощью ИИ для подготовки к собеседованиям уже доступны на XIX.AI! Эта тщательно отобранная подборка включает мощные, революционные инструменты, прошедшие строгие реальные испытания и обеспечивающие точную обратную связь. Вы найдете сравнение бесплатных и платных вариантов, а также подробные рейтинги, которые помогут вам выбрать наиболее подходящий инструмент, повышающий вашу уверенность и навыки. Исследуйте сейчас, чтобы найти идеальный инструмент для успешного прохождения собеседований!
12 инструментов
xix.ai
Дизайн и искусство
Лучшие инструменты для переноса стилей с помощью ИИ для творческих экспериментов
2026: лучшие и самые популярные инструменты для переноса стиля с помощью ИИ для творческих экспериментов! XIX.AI подготовила подборку мощных, революционных инструментов, которые обязательно стоит попробовать: они демонстрируют исключительные результаты, подтвержденные реальными тестами и тщательным рейтингом. Эти ведущие решения помогают творческим людям значительно повысить продуктивность, ускоряя создание контента и открывая безграничные творческие возможности. Ознакомьтесь с ними прямо сейчас, чтобы найти идеальный инструмент и начать творить уже сегодня!
9 инструментов
xix.ai

 Комментарии (0)
Три года назад компания Google представила проект Gemini с целью создания мультимодальной большой языковой модели — единой нейронной сети, обученной на тексте, изображениях, аудио и видео, способной генерировать контент во всех этих форматах.
На сегодняшней конференции разработчиков Google I/O компания сделала шаг к реализации этой концепции, представив Gemini Omni — новое семейство мультимодальных моделей. Генеральный директор Google Сундар Пичаи заявил, что Omni позволит пользователям «создавать что угодно из любого входного материала».
Первоначально Omni сосредоточится на видео. Теперь пользователи могут комбинировать изображения, аудио, видео и текст. Вместо того чтобы просто сшивать эти элементы вместе, Omni интеллектуально анализирует все модальности, чтобы создать связный результат. Это приводит к созданию высококачественных видеороликов, демонстрирующих понимание физики, культуры, истории и науки.
Omni также позволяет пользователям редактировать фотографии с помощью простых текстовых команд, устраняя необходимость в сложном программном обеспечении, аналогично инструменту Google Nano Banana.
Google уже предлагает Veo — специализированную видеомодель, которая преобразует текст и изображения в видео и позволяет управлять аватарами и настраивать их. Однако Николь Брихтово, директор по управлению продуктами в Google DeepMind, подчеркнула, что сегодняшний релиз представляет собой нечто большее, чем просто обновление Veo: «Это следующий шаг в объединении интеллекта Gemini с возможностями рендеринга наших медиа-моделей».
Во время брифинга для СМИ в понедельник главный технолог DeepMind Корай Кавукчуоглу привел пример: когда ему предложили «пояснительное видео с пластилиновой анимацией о сворачивании белков», Omni быстро сгенерировал стоп-моушн-видео с закадровым голосом, объясняющим: «Белки начинаются как цепочки аминокислот. Они сворачиваются в структуры, такие как альфа-спирали и плоские участки, называемые бета-листами, в конечном итоге образуя точную трехмерную форму».
Долгосрочная перспектива для Omni более широка и включает в себя такие возможности, как генерация изображений из аудио или аудио из видео.
«Когда мы впервые анонсировали Gemini, это была наша первая изначально мультимодальная модель ИИ», — отметил Пичаи во время брифинга. «Мы знали, что обучение ее на комбинации текста, кода, аудио, изображений и видео приведет к более глубокому пониманию мира. С помощью моделей мира ИИ эволюционирует от предсказания текста к моделированию реальности. Gemini Omni — это следующий шаг в этом направлении».
В рамках этого релиза пользователи также смогут создавать видео с участием своих собственных цифровых аватаров — функция, популяризованная приложением Sora от OpenAI (ныне снятым с производства) с помощью Cameos. По словам Брихтовой, для предотвращения появления дипфейков пользователи должны пройти специальный процесс регистрации, который включает в себя запись себя на видео, произнося серию цифр. Затем аватар сохраняется для дальнейшего использования.
Кроме того, все видео, созданные с помощью Omni, будут содержать цифровой водяной знак SynthID от Google, что позволит пользователям проверять, был ли контент сгенерирован с помощью продуктов Gemini.
Первой моделью в семействе является Gemini Omni Flash, запускаемая сегодня в приложении Gemini, YouTube Shorts и студии искусственного интеллекта Flow. Flash может рендерить 10-секундные видео. Брихтова пояснила, что эта продолжительность не является ограничением модели, а стратегическим решением, направленным на расширение доступности, исходя из того, что в настоящее время большинство пользователей предпочитают более короткие ролики. Поддержка более длинных видео запланирована на ближайшее будущее.
Google, похоже, позиционирует Omni Flash в первую очередь как инструмент для потребителей. Во время разговора с TechCrunch Брихтовая и инженер-исследователь DeepMind Гейб Барт-Марон описали сценарии использования аватаров как личные, например, создание видео, где вы получаете награду или посещаете Луну, или удаление постороннего человека из фона видео с отпуска.
Барт-Марон лаконично подытожил: «Они похожи на персонализированные мемы».
«Мы определенно сосредоточились на том, чтобы сделать это простым для использования потребителями», — сказала Брихтовая. «Не многие видеомодели успешно перешли на массовый потребительский рынок, так что это наша попытка сделать это».
Эта простота использования сопровождается одним предостережением: Брихтовая и Барт-Марон отметили, что подсказки для редактирования должны быть очень конкретными. В противном случае Omni может перередактировать или непреднамеренно изменить элементы, которые пользователь намеревался сохранить — с этой проблемой сталкиваются и пользователи Nano Banana.
Изображения:Google
Несмотря на непосредственную ориентацию на потребителей, потенциал Omni для корпоративных и творческих приложений очевиден. В ближайшие недели Google сделает Omni доступным через API. Ожидается, что инструмент для генерации аватаров, уже доступный в Shorts, станет популярным среди создателей контента. В более широком смысле сквозной мультимодальный рабочий процесс может революционизировать рекламу и кинопроизводство.
Стартап Luma AI разрабатывает аналогичный инструмент на базе собственной «унифицированной» модели, способный генерировать целую рекламную кампанию на основе брифа и изображения продукта.
«Мы действительно очень гордимся возможностями модели по рендерингу текста, которые очень полезны для таких приложений, как реклама», — сказала Брихтова. «Если вам нужен продукт-плейсмент или даже просто слоган, точность имеет решающее значение... Мы, безусловно, ожидаем, что кинематографисты и другие создатели контента также примут эту модель».
Для более профессиональных задач лучше подойдет готовящаяся к выпуску модель Omni Pro, разработанная для обеспечения превосходной производительности при выполнении всех задач Omni. Google пока не объявила дату выпуска Pro, но Брихтово указала, что она будет запущена, когда «мы достигнем значительного скачка в возможностях по сравнению с Flash».








 Google запускает функцию обнаружения поддельных звонков для защиты от мошенничества с использованием ИИ-дипфейков, имитирующих личность
Во вторник компания Google объявила о запуске в Android функции обнаружения поддельных звонков, призванной защитить пользователей от мошенничества с использованием технологии «дипфейк» на базе искусст
 Frontier AI Labs отказывается раскрывать стратегии локализации неконтролируемых моделей
Последние исследования показывают, что лишь немногие ведущие лаборатории, занимающиеся ИИ, опубликовали или продемонстрировали планы реагирования на попытки выхода системы из-под контроля. План сдержи
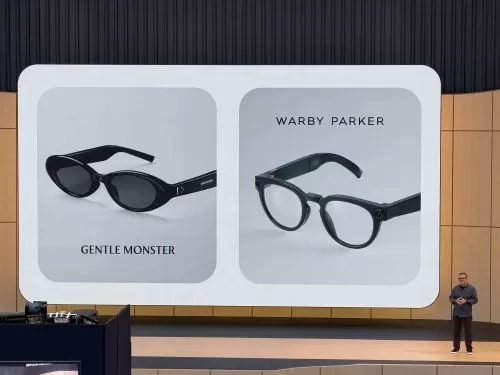 На конференции IO 2026 компания Google представила «умные» очки с аудиофункциями, повторив стратегию Meta
Google стратегически возвращается на рынок умных очков.Во вторник на конференции Google I/O технологический гигант объявил о сотрудничестве с Warby Parker и Gentle Monster с целью запуска новой линейк

2026 г. — новейшие, лучшие и наиболее рейтинговые приложения для ИИ-ролевых чатов, предназначенные для практики языка, подготовки к собеседованиям и ежедневной беглости речи! XIX.AI предлагает мощную коллекцию, меняющую правила игры: бесплатные и платные варианты, реальные тесты и обновляемые еженедельно рейтинги. Эти обязательные к использованию инструменты помогут вам улучшить навыки письма, преодолеть трудности с беглостью и повысить эффективность общения во всех повседневных ситуациях. Исследуйте сейчас, чтобы найти идеальный инструмент для развития вашего языка!
10 инструментов
xix.ai

2026 год: лучшие и наиболее высоко оценённые инструменты для разделения аудиосигналов с использованием ИИ, отобранные специально для работы над ремиксами, подготовки образцов звука и создания караоке-версий. Эти мощные революционные инструменты проходят реальные тесты, обеспечивая точную изоляцию аудиосигналов и значительно повышая производительность. XIX.AI предоставляет еженедельно обновляемый бесплатный справочник сравнения платных и бесплатных решений, который поможет вам найти оптимальный вариант, соответствующий вашим потребностям. Ознакомьтесь с ним прямо сейчас, чтобы раскрыть потенциал ИИ в вашей работе.
8 инструментов
xix.ai

2026 год: лучшие AI-ассистенты для SQL, занявшие верхние строчки рейтингов! XIX.AI собрал мощный набор инструментов, регулярно обновляемый на основе реальных тестов. Эти неотъемлемые инструменты помогают создавать точные дашборды с данными о доходах, анализировать каналы продаж и оперативно отслеживать показатели продуктов, значительно повышая производительность. Ознакомьтесь сейчас, чтобы найти идеальный инструмент для принятия решений на основе данных! 238 символов
9 инструментов
xix.ai

2026 год: лучшие, топовые и высокооценённые инструменты ИИ для написания мелодий для черновиков песен! XIX.AI подобрал высокоэффективную коллекцию, меняющую правила игры, которая прошла строгие реальные испытания, чтобы обеспечить лучший опыт написания. Вы можете найти подробные сравнения бесплатных и платных версий, точные рейтинги и обязательные к использованию варианты, разработанные, чтобы помочь вам создавать потрясающие черновики песен без усилий и значительно повысить вашу творческую продуктивность. Исследуйте сейчас, чтобы найти свой идеальный инструмент!
8 инструментов
xix.ai

2026 г. — новейшие, лучшие и наиболее высоко оцененные инструменты для тренировки разговорных навыков с помощью ИИ для подготовки к собеседованиям уже доступны на XIX.AI! Эта тщательно отобранная подборка включает мощные, революционные инструменты, прошедшие строгие реальные испытания и обеспечивающие точную обратную связь. Вы найдете сравнение бесплатных и платных вариантов, а также подробные рейтинги, которые помогут вам выбрать наиболее подходящий инструмент, повышающий вашу уверенность и навыки. Исследуйте сейчас, чтобы найти идеальный инструмент для успешного прохождения собеседований!
12 инструментов
xix.ai

2026: лучшие и самые популярные инструменты для переноса стиля с помощью ИИ для творческих экспериментов! XIX.AI подготовила подборку мощных, революционных инструментов, которые обязательно стоит попробовать: они демонстрируют исключительные результаты, подтвержденные реальными тестами и тщательным рейтингом. Эти ведущие решения помогают творческим людям значительно повысить продуктивность, ускоряя создание контента и открывая безграничные творческие возможности. Ознакомьтесь с ними прямо сейчас, чтобы найти идеальный инструмент и начать творить уже сегодня!
9 инструментов
xix.ai












