


 Maison
Gemini Omni de Google génère des vidéos à partir d'images, d'enregistrements audio et de texte
Il y a trois ans, Google a lancé Gemini dans le but de développer un grand modèle linguistique multimodal, c'est-à-dire un réseau neuronal unifié formé sur du texte, des images, de l'audio et de la vidéo, capable de générer du contenu dans tous ces formats.
Lors de sa conférence des développeurs Google I/O qui s'est tenue aujourd'hui, l'entreprise a franchi une nouvelle étape vers cette vision avec Gemini Omni, une nouvelle famille de modèles multimodaux. Le PDG de Google, Sundar Pichai, a déclaré qu'Omni permettrait aux utilisateurs de « créer n'importe quoi à partir de n'importe quelle entrée ».
Omni se concentre dans un premier temps sur la vidéo. Les utilisateurs peuvent désormais combiner images, audio, vidéo et texte. Au lieu de se contenter d’assembler ces éléments, Omni effectue un raisonnement intelligent à travers toutes les modalités pour produire un résultat cohérent. Il en résulte des vidéos de haute qualité qui démontrent une compréhension de la physique, de la culture, de l’histoire et des sciences.
Omni permet également aux utilisateurs de retoucher des photos à l’aide de simples commandes textuelles, éliminant ainsi le recours à des logiciels complexes, à l’instar de l’outil Nano Banana de Google.
Google propose déjà Veo, un modèle vidéo dédié qui transforme le texte et les images en vidéos et permet de diriger et de personnaliser des avatars. Cependant, Nicole Brichtova, directrice de la gestion des produits chez Google DeepMind, a souligné que la version lancée aujourd’hui représente bien plus qu’une simple mise à jour de Veo : « C’est la prochaine étape dans la fusion de l’intelligence de Gemini avec les capacités de rendu de nos modèles multimédias. »
Lors d’une conférence de presse lundi, Koray Kavukcuoglu, technologue en chef chez DeepMind, a donné un exemple : lorsqu’on lui a demandé « une animation en pâte à modeler expliquant le repliement des protéines », Omni a rapidement généré une vidéo en stop-motion accompagnée d’une voix off expliquant : « Les protéines commencent par être des chaînes d’acides aminés. Elles se replient en structures telles que des hélices alpha et des sections plates appelées feuillets bêta, pour finalement former une forme tridimensionnelle précise. »
La vision à long terme pour Omni est plus large, englobant des capacités telles que la génération d’images à partir d’audio ou d’audio à partir de vidéo.
« Lorsque nous avons annoncé Gemini pour la première fois, il s’agissait de notre premier modèle d’IA multimodal natif », a fait remarquer Pichai lors de la présentation. « Nous savions que l’entraîner sur une combinaison de texte, de code, d’audio, d’images et de vidéo permettrait une compréhension plus approfondie du monde. Avec les modèles du monde, l’IA évolue de la prédiction de texte à la simulation de la réalité. Gemini Omni est la prochaine étape dans cette direction. »
Dans le cadre de ce lancement, les utilisateurs pourront également créer des vidéos mettant en scène leurs propres avatars numériques — une fonctionnalité popularisée par l’application Sora d’OpenAI, désormais abandonnée, avec Cameos. Pour prévenir les deepfakes, les utilisateurs doivent suivre un processus d’intégration dédié, qui consiste à s’enregistrer en train de prononcer une série de chiffres, selon Brichtova. L’avatar est ensuite enregistré pour une utilisation future.
De plus, toutes les vidéos créées avec Omni comporteront le filigrane numérique SynthID de Google, permettant aux utilisateurs de vérifier si le contenu a été généré à l’aide des produits Gemini.
Le premier modèle de la gamme est Gemini Omni Flash, lancé aujourd’hui sur l’application Gemini, YouTube Shorts et le studio de création IA Flow. Flash peut générer des vidéos de 10 secondes. Mme Brichtova a précisé que cette durée n’était pas une limitation du modèle, mais un choix stratégique visant à élargir l’accessibilité, anticipant que la plupart des utilisateurs préfèrent actuellement des clips plus courts. La prise en charge de vidéos plus longues est prévue dans un avenir proche.
Google semble positionner Omni Flash principalement comme un outil grand public. Lors d’un entretien avec TechCrunch, Brichtova et Gabe Barth-Maron, ingénieur de recherche chez DeepMind, ont décrit des cas d’utilisation des avatars comme étant personnels, tels que la création d’une vidéo de soi-même remportant un prix ou visitant la Lune, ou encore la suppression d’un passant de l’arrière-plan d’une vidéo de vacances.
Barth-Maron l'a résumé succinctement : « C'est comme des mèmes personnalisés. »
« Nous nous sommes clairement attachés à rendre cet outil facile à utiliser pour les consommateurs », a déclaré Brichtova. « Peu de modèles vidéo ont réussi à percer sur le marché grand public, c'est donc notre tentative pour y parvenir. »
Cette facilité d’utilisation s’accompagne toutefois d’une mise en garde : Brichtova et Barth-Maron ont souligné que les instructions de montage devaient être très précises. Sinon, Omni risquerait de trop retoucher ou de modifier involontairement des éléments que l’utilisateur souhaitait conserver — un défi auquel sont également confrontés les utilisateurs de Nano Banana.
Crédits image :Google
Malgré son orientation immédiate vers le grand public, le potentiel d’Omni pour les applications d’entreprise et créatives est évident. Google rendra Omni disponible via une API dans les semaines à venir. L’outil de génération d’avatars — déjà disponible sur Shorts — devrait gagner en popularité auprès des créateurs de contenu. Plus largement, un flux de travail multimodal de bout en bout pourrait révolutionner la publicité et la réalisation de films.
La start-up Luma AI développe un outil agentique similaire, alimenté par son propre modèle « unifié », capable de générer une campagne publicitaire complète à partir d’un brief et d’une image de produit.
« Nous sommes en fait assez fiers des capacités de rendu de texte du modèle, qui sont très utiles pour des applications comme la publicité », a déclaré Brichtova. « Si vous avez besoin d’un placement de produit ou même simplement d’un slogan, la précision est cruciale… Nous prévoyons certainement que les cinéastes et autres créateurs adopteront également ce modèle. »
Les cas d’utilisation plus professionnels pourraient être mieux servis par le futur modèle Omni Pro, conçu pour offrir des performances supérieures dans toutes les tâches Omni. Google n’a pas encore annoncé de date de sortie pour la version Pro, mais Mme Brichtova a indiqué qu’elle serait lancée lorsque « nous aurons réalisé un bond en avant significatif en termes de capacités, bien au-delà de Flash ».
Article connexe
 Google déploie un système de détection des faux appels pour se prémunir contre les escroqueries par usurpation d'identité via des « deepfakes » générés par l'IA
Google a annoncé mardi que le système Android allait déployer une fonctionnalité de détection des faux appels afin de protéger les utilisateurs contre les escroqueries par usurpation d’identité utilis
Frontier AI Labs refuse de dévoiler ses stratégies de confinement des modèles indésirables
Des recherches récentes indiquent que très peu de grands laboratoires spécialisés dans l’IA ont publié ou présenté des plans d’intervention en cas de défaillance. Un plan d’intervention définit les pr
Google dévoile des lunettes connectées à commande vocale lors de l'IO 2026, emboîtant le pas à la stratégie de Meta
Google fait un retour stratégique sur le marché des lunettes connectées.Lors de la conférence Google I/O qui s’est tenue mardi, le géant de la technologie a dévoilé un partenariat avec Warby Parker et
Recommandations de sujets spéciaux liés
Création vidéo
 Générateurs d'accroches pour vidéos courtes basés sur l'IA, destinés aux Reels, aux Shorts et aux campagnes de lancement de produits
Les meilleurs générateurs de accroches pour vidéos courtes basées sur l'IA en 2026 : pour Reels, Shorts et campagnes de lancement de produits ! XIX.AI sélectionne les outils les mieux notés, puissants et révolutionnaires, qui offrent des résultats incontournables grâce à des tests en conditions réelles. Cette page, mise à jour chaque semaine, propose des classements comparatifs entre les solutions gratuites et payantes pour vous aider à trouver la solution idéale afin de booster votre créativité et votre productivité en matière de contenu. Découvrez-la dès maintenant pour exploiter pleinement le potentiel de l’IA !
 11 outils
 xix.ai
en écrivant
Outils d'IA pour la structuration d'articles destinés à la rédaction de textes longs
2026 : les meilleurs outils d'aide à la rédaction de plans pour les textes longs, sélectionnés parmi les mieux notés ! Cette sélection rigoureuse regroupe des outils puissants et révolutionnaires qui fournissent des plans précis et structurés, validés par des tests concrets, afin d'améliorer considérablement l'efficacité de la rédaction. XIX.AI fait partie de cette sélection d'élite. Consultez notre comparatif entre les versions gratuites et payantes pour vous aider à choisir l'outil idéal. Découvrez-les dès maintenant et tirez parti de l'IA !
9 outils
xix.ai
chatbot
Meilleures applications de chat de jeu de rôle par IA pour la pratique des langues, la préparation aux entretiens et la fluidité quotidienne
2026 Dernières Meilleures Applications de Chat IA pour le Jeu de Rôle, les plus bien notées pour la Pratique des Langues, la Préparation aux Entretiens et la Fluidité Quotidienne ! XIX.AI sélectionne une collection puissante et révolutionnaire qui propose une comparaison gratuit vs payant, des tests en conditions réelles et des classements mis à jour chaque semaine. Ces outils à essayer absolument vous aident à améliorer vos compétences en écriture, à surmonter les défis de fluidité et à optimiser l’efficacité de la communication dans tous les scénarios quotidiens. Explorez dès maintenant pour découvrir l’outil parfait pour votre progression linguistique !
10 outils
xix.ai
Composition musicale
Outils de séparation des pistes audio par IA pour la production de remix, la préparation de samples et les masters de karaoké
2026 : Les meilleures et plus récentes outils de séparation des pistes audio par IA, hautement notés, sélectionnés spécialement pour la production de remix, la préparation de samples et l’enregistrement de karaokés. Ces outils puissants et révolutionnaires, éprouvés dans des conditions réelles, permettent une isolation audio précise, ce qui améliore considérablement la productivité. XIX.AI propose un guide de comparaison gratuit mis à jour chaque semaine entre les versions payantes et gratuites, afin de vous aider à trouver la solution idéale adaptée à vos besoins. Découvrez-les dès maintenant pour tirer parti des avantages offerts par l’IA.
8 outils
xix.ai
Analyse des données
Copilotes SQL basés sur l’IA pour les tableaux de bord de chiffre d’affaires, l’analyse des funnels et les indicateurs de produits
2026 : Les meilleurs copilotes AI SQL actuels, classés parmi les plus performants ! XIX.AI a sélectionné une collection puissante et révolutionnaire, mise à jour chaque semaine grâce à des tests concrets. Ces outils indispensables vous aident à créer des tableaux de bord financiers précis, à analyser les canaux de vente et à suivre en temps réel les indicateurs produits, ce qui améliore considérablement votre productivité. Découvrez-les dès maintenant pour trouver l’outil idéal pour des décisions basées sur les données ! 238 caractères
9 outils
xix.ai
Composition musicale
Meilleurs outils d’écriture de mélodies par IA pour les ébauches de chansons
2026 Derniers Meilleurs Outils d’Écriture de Mélodie par IA les Mieux Notés pour des Ébauches de Chansons ! XIX.AI a sélectionné une collection hautement puissante et révolutionnaire, soumise à des tests rigoureux en conditions réelles, afin d’offrir la meilleure expérience d’écriture. Vous pouvez y trouver des comparaisons détaillées entre versions gratuites et payantes, des classements précis, ainsi que des options incontournables conçues pour vous aider à créer sans effort des ébauches de chansons remarquables et à booster significativement votre productivité créative. Explorez dès maintenant pour découvrir l’outil qui vous correspond parfaitement !
8 outils
xix.ai

 commentaires (0)
Il y a trois ans, Google a lancé Gemini dans le but de développer un grand modèle linguistique multimodal, c'est-à-dire un réseau neuronal unifié formé sur du texte, des images, de l'audio et de la vidéo, capable de générer du contenu dans tous ces formats.
Lors de sa conférence des développeurs Google I/O qui s'est tenue aujourd'hui, l'entreprise a franchi une nouvelle étape vers cette vision avec Gemini Omni, une nouvelle famille de modèles multimodaux. Le PDG de Google, Sundar Pichai, a déclaré qu'Omni permettrait aux utilisateurs de « créer n'importe quoi à partir de n'importe quelle entrée ».
Omni se concentre dans un premier temps sur la vidéo. Les utilisateurs peuvent désormais combiner images, audio, vidéo et texte. Au lieu de se contenter d’assembler ces éléments, Omni effectue un raisonnement intelligent à travers toutes les modalités pour produire un résultat cohérent. Il en résulte des vidéos de haute qualité qui démontrent une compréhension de la physique, de la culture, de l’histoire et des sciences.
Omni permet également aux utilisateurs de retoucher des photos à l’aide de simples commandes textuelles, éliminant ainsi le recours à des logiciels complexes, à l’instar de l’outil Nano Banana de Google.
Google propose déjà Veo, un modèle vidéo dédié qui transforme le texte et les images en vidéos et permet de diriger et de personnaliser des avatars. Cependant, Nicole Brichtova, directrice de la gestion des produits chez Google DeepMind, a souligné que la version lancée aujourd’hui représente bien plus qu’une simple mise à jour de Veo : « C’est la prochaine étape dans la fusion de l’intelligence de Gemini avec les capacités de rendu de nos modèles multimédias. »
Lors d’une conférence de presse lundi, Koray Kavukcuoglu, technologue en chef chez DeepMind, a donné un exemple : lorsqu’on lui a demandé « une animation en pâte à modeler expliquant le repliement des protéines », Omni a rapidement généré une vidéo en stop-motion accompagnée d’une voix off expliquant : « Les protéines commencent par être des chaînes d’acides aminés. Elles se replient en structures telles que des hélices alpha et des sections plates appelées feuillets bêta, pour finalement former une forme tridimensionnelle précise. »
La vision à long terme pour Omni est plus large, englobant des capacités telles que la génération d’images à partir d’audio ou d’audio à partir de vidéo.
« Lorsque nous avons annoncé Gemini pour la première fois, il s’agissait de notre premier modèle d’IA multimodal natif », a fait remarquer Pichai lors de la présentation. « Nous savions que l’entraîner sur une combinaison de texte, de code, d’audio, d’images et de vidéo permettrait une compréhension plus approfondie du monde. Avec les modèles du monde, l’IA évolue de la prédiction de texte à la simulation de la réalité. Gemini Omni est la prochaine étape dans cette direction. »
Dans le cadre de ce lancement, les utilisateurs pourront également créer des vidéos mettant en scène leurs propres avatars numériques — une fonctionnalité popularisée par l’application Sora d’OpenAI, désormais abandonnée, avec Cameos. Pour prévenir les deepfakes, les utilisateurs doivent suivre un processus d’intégration dédié, qui consiste à s’enregistrer en train de prononcer une série de chiffres, selon Brichtova. L’avatar est ensuite enregistré pour une utilisation future.
De plus, toutes les vidéos créées avec Omni comporteront le filigrane numérique SynthID de Google, permettant aux utilisateurs de vérifier si le contenu a été généré à l’aide des produits Gemini.
Le premier modèle de la gamme est Gemini Omni Flash, lancé aujourd’hui sur l’application Gemini, YouTube Shorts et le studio de création IA Flow. Flash peut générer des vidéos de 10 secondes. Mme Brichtova a précisé que cette durée n’était pas une limitation du modèle, mais un choix stratégique visant à élargir l’accessibilité, anticipant que la plupart des utilisateurs préfèrent actuellement des clips plus courts. La prise en charge de vidéos plus longues est prévue dans un avenir proche.
Google semble positionner Omni Flash principalement comme un outil grand public. Lors d’un entretien avec TechCrunch, Brichtova et Gabe Barth-Maron, ingénieur de recherche chez DeepMind, ont décrit des cas d’utilisation des avatars comme étant personnels, tels que la création d’une vidéo de soi-même remportant un prix ou visitant la Lune, ou encore la suppression d’un passant de l’arrière-plan d’une vidéo de vacances.
Barth-Maron l'a résumé succinctement : « C'est comme des mèmes personnalisés. »
« Nous nous sommes clairement attachés à rendre cet outil facile à utiliser pour les consommateurs », a déclaré Brichtova. « Peu de modèles vidéo ont réussi à percer sur le marché grand public, c'est donc notre tentative pour y parvenir. »
Cette facilité d’utilisation s’accompagne toutefois d’une mise en garde : Brichtova et Barth-Maron ont souligné que les instructions de montage devaient être très précises. Sinon, Omni risquerait de trop retoucher ou de modifier involontairement des éléments que l’utilisateur souhaitait conserver — un défi auquel sont également confrontés les utilisateurs de Nano Banana.
Crédits image :Google
Malgré son orientation immédiate vers le grand public, le potentiel d’Omni pour les applications d’entreprise et créatives est évident. Google rendra Omni disponible via une API dans les semaines à venir. L’outil de génération d’avatars — déjà disponible sur Shorts — devrait gagner en popularité auprès des créateurs de contenu. Plus largement, un flux de travail multimodal de bout en bout pourrait révolutionner la publicité et la réalisation de films.
La start-up Luma AI développe un outil agentique similaire, alimenté par son propre modèle « unifié », capable de générer une campagne publicitaire complète à partir d’un brief et d’une image de produit.
« Nous sommes en fait assez fiers des capacités de rendu de texte du modèle, qui sont très utiles pour des applications comme la publicité », a déclaré Brichtova. « Si vous avez besoin d’un placement de produit ou même simplement d’un slogan, la précision est cruciale… Nous prévoyons certainement que les cinéastes et autres créateurs adopteront également ce modèle. »
Les cas d’utilisation plus professionnels pourraient être mieux servis par le futur modèle Omni Pro, conçu pour offrir des performances supérieures dans toutes les tâches Omni. Google n’a pas encore annoncé de date de sortie pour la version Pro, mais Mme Brichtova a indiqué qu’elle serait lancée lorsque « nous aurons réalisé un bond en avant significatif en termes de capacités, bien au-delà de Flash ».








 Google déploie un système de détection des faux appels pour se prémunir contre les escroqueries par usurpation d'identité via des « deepfakes » générés par l'IA
Google a annoncé mardi que le système Android allait déployer une fonctionnalité de détection des faux appels afin de protéger les utilisateurs contre les escroqueries par usurpation d’identité utilis
 Frontier AI Labs refuse de dévoiler ses stratégies de confinement des modèles indésirables
Des recherches récentes indiquent que très peu de grands laboratoires spécialisés dans l’IA ont publié ou présenté des plans d’intervention en cas de défaillance. Un plan d’intervention définit les pr
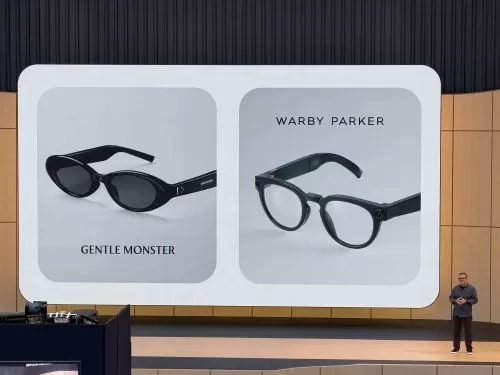 Google dévoile des lunettes connectées à commande vocale lors de l'IO 2026, emboîtant le pas à la stratégie de Meta
Google fait un retour stratégique sur le marché des lunettes connectées.Lors de la conférence Google I/O qui s’est tenue mardi, le géant de la technologie a dévoilé un partenariat avec Warby Parker et

Les meilleurs générateurs de accroches pour vidéos courtes basées sur l'IA en 2026 : pour Reels, Shorts et campagnes de lancement de produits ! XIX.AI sélectionne les outils les mieux notés, puissants et révolutionnaires, qui offrent des résultats incontournables grâce à des tests en conditions réelles. Cette page, mise à jour chaque semaine, propose des classements comparatifs entre les solutions gratuites et payantes pour vous aider à trouver la solution idéale afin de booster votre créativité et votre productivité en matière de contenu. Découvrez-la dès maintenant pour exploiter pleinement le potentiel de l’IA !
11 outils
xix.ai

2026 : les meilleurs outils d'aide à la rédaction de plans pour les textes longs, sélectionnés parmi les mieux notés ! Cette sélection rigoureuse regroupe des outils puissants et révolutionnaires qui fournissent des plans précis et structurés, validés par des tests concrets, afin d'améliorer considérablement l'efficacité de la rédaction. XIX.AI fait partie de cette sélection d'élite. Consultez notre comparatif entre les versions gratuites et payantes pour vous aider à choisir l'outil idéal. Découvrez-les dès maintenant et tirez parti de l'IA !
9 outils
xix.ai

2026 Dernières Meilleures Applications de Chat IA pour le Jeu de Rôle, les plus bien notées pour la Pratique des Langues, la Préparation aux Entretiens et la Fluidité Quotidienne ! XIX.AI sélectionne une collection puissante et révolutionnaire qui propose une comparaison gratuit vs payant, des tests en conditions réelles et des classements mis à jour chaque semaine. Ces outils à essayer absolument vous aident à améliorer vos compétences en écriture, à surmonter les défis de fluidité et à optimiser l’efficacité de la communication dans tous les scénarios quotidiens. Explorez dès maintenant pour découvrir l’outil parfait pour votre progression linguistique !
10 outils
xix.ai

2026 : Les meilleures et plus récentes outils de séparation des pistes audio par IA, hautement notés, sélectionnés spécialement pour la production de remix, la préparation de samples et l’enregistrement de karaokés. Ces outils puissants et révolutionnaires, éprouvés dans des conditions réelles, permettent une isolation audio précise, ce qui améliore considérablement la productivité. XIX.AI propose un guide de comparaison gratuit mis à jour chaque semaine entre les versions payantes et gratuites, afin de vous aider à trouver la solution idéale adaptée à vos besoins. Découvrez-les dès maintenant pour tirer parti des avantages offerts par l’IA.
8 outils
xix.ai

2026 : Les meilleurs copilotes AI SQL actuels, classés parmi les plus performants ! XIX.AI a sélectionné une collection puissante et révolutionnaire, mise à jour chaque semaine grâce à des tests concrets. Ces outils indispensables vous aident à créer des tableaux de bord financiers précis, à analyser les canaux de vente et à suivre en temps réel les indicateurs produits, ce qui améliore considérablement votre productivité. Découvrez-les dès maintenant pour trouver l’outil idéal pour des décisions basées sur les données ! 238 caractères
9 outils
xix.ai

2026 Derniers Meilleurs Outils d’Écriture de Mélodie par IA les Mieux Notés pour des Ébauches de Chansons ! XIX.AI a sélectionné une collection hautement puissante et révolutionnaire, soumise à des tests rigoureux en conditions réelles, afin d’offrir la meilleure expérience d’écriture. Vous pouvez y trouver des comparaisons détaillées entre versions gratuites et payantes, des classements précis, ainsi que des options incontournables conçues pour vous aider à créer sans effort des ébauches de chansons remarquables et à booster significativement votre productivité créative. Explorez dès maintenant pour découvrir l’outil qui vous correspond parfaitement !
8 outils
xix.ai












