


 Дом
Первый в Китае иск о защите чести и достоинства с использованием искусственного интеллекта завершился решением суда об обязании Baidu принести извинения
Хотя искусственный интеллект предоставляет удобства, распространяемая им дезинформация всё чаще нарушает правовые нормы. Недавно в Нанкине, провинция Цзянсу, было вынесено первое в Китае окончательное решение по делу о «клевете с использованием ИИ».
Исковое заявление было подано адвокатом из Цзянсу Ли Сяоляном, который обнаружил, что инструмент «интеллектуального ответа ИИ» компании Baidu сгенерировал ложные утверждения, включая вымышленное тюремное заключение сроком на три года. Как юридический специалист, он обязан поддерживать безупечную репутацию, и эти неточности нанесли ущерб его статусу и карьере.
В ответ на эту вредоносную дезинформацию Ли Сяолян подал в суд на компанию Beijing Baidu Netcom Science and Technology Co., Ltd., требуя правовой защиты от нарушения его прав.
Суд постановил, что системы искусственного интеллекта обязаны обеспечивать точность контента и избегать распространения ложной информации, наносящей ущерб репутации. Компания Baidu была признана виновной в нарушении прав Ли на репутацию посредством своих ответов ИИ и обязана понести юридическую ответственность.
Окончательное решение суда Нанкина подтвердило ответственность компании Baidu за клевету. Компании было предписано в течение десяти дней после вступления решения в силу опубликовать письменное извинение перед Ли Сяоляном для минимизации ущерба.
Это судебное решение устанавливает четкие правовые границы для контента, созданного искусственным интеллектом, напоминая технологическим компаниям, что алгоритмы подчиняются закону. Разработчики должны приоритетно уделять внимание проверке подлинности и соответствия выходных данных, одновременно развивая возможности моделей.
Связанная статья
 Как исправить Core Web Vitals для улучшения позиций в поисковой выдаче?
Представляем Free Willy: Новая эра для языковых моделей с открытым исходным кодомСодержание:Woody's AI и Carper AI Lab: Стратегическое партнерствоКритическая роль обработки естественного языкаЗнакомство с Free Willy 1 и Free Willy 2Сравнение с к
Завершилась конференция TechCrunch Disrupt 2026
Настал последний день TechCrunch Disrupt 2026, который станет кульминацией насыщенной недели. В третий день в выставочном центре Moscone West в Сан-Франциско, где собрались более 10 000 основателей ст
QueryStory призывает к осторожности в отношении контента, сгенерированного искусственным интеллектом
В 2009 году Шапор Нагибзаде, работая инженером по системному администрированию в Google, открыл для себя силу убедительного повествования. Во время операции «Аврора», когда хакеры, действующие по зака
Рекомендации по связанным специальным темам
Дизайн и искусство
 Лучшие инструменты для создания иллюстраций с помощью ИИ: быстрее создавайте редакционные сцены и обложки
2026: Новейшие и самые популярные инструменты для создания иллюстраций с помощью ИИ: в нашем тщательно подобранном списке представлены лучшие инструменты с мощными функциональными возможностями, позволяющие быстро создавать потрясающие редакционные сцены и привлекательные обложки. Каждый вариант прошел тщательные практические испытания; мы предлагаем сравнение бесплатных и платных версий, чтобы помочь вам найти идеальный вариант для вашего рабочего процесса. Попробуйте эти незаменимые решения уже сегодня, чтобы раскрыть потенциал искусственного интеллекта и повысить свою творческую продуктивность. Узнайте больше на сайте XIX.AI.
 10 инструментов
 xix.ai
Образование и обучение
Лучшие репетиторы по искусственному интеллекту для подготовки к экзаменам: практикуйтесь по математике, естественным наукам и английскому языку
2026 года: лучшие и самые популярные ИИ-репетиторы для подготовки к экзаменам представлены на XIX.AI! В нашем тщательно подобранном списке представлены мощные инструменты, которые кардинально изменят ваш подход к обучению: здесь вы найдете сравнение бесплатных и платных версий, тесты на практике и еженедельно обновляемые рейтинги. Они помогут повысить эффективность вашего письма, упростить изучение сложных тем и раскрыть ваш академический потенциал. Ознакомьтесь с ними прямо сейчас, чтобы найти идеальный инструмент для подготовки к экзаменам, и начните творить уже сегодня, чтобы раскрыть свои преимущества благодаря ИИ!
10 инструментов
xix.ai
Финансы
Инструменты планирования бюджета на основе ИИ для управления личными финансами
В 2026 году на XIX.AI представлены новейшие, лучшие и наиболее рейтинговые инструменты ИИ для бюджетного планирования по личным финансам! Эта тщательно отобранная коллекция включает мощные, революционные решения, которые помогают проводить реальные тесты, понимать привычки расходов и создавать персонализированные планы для повышения продуктивности. Наслаждайтесь бесплатным сравнением с платными версиями вместе с подробными рейтингами. Инструменты, которые обязательно стоит попробовать, разработаны для упрощения управления деньгами и раскрытия вашего преимущества ИИ. Исследуйте сейчас!
11 инструментов
xix.ai
Здоровье и благополучие
Помощники для отслеживания сна с ИИ: улучшите восстановление за счёт более правильных привычек перед сном
2026 год: лучшие и наиболее высоко оценённые помощники для отслеживания сна на основе ИИ, отобранные для максимального восстановления организма. В этом полностью обновлённом еженедельном руководстве представлены мощные инструменты с результатами реальных тестов, сравнением бесплатных и платных версий, а также подробными рейтингами, которые помогут вам найти оптимальное решение для улучшения качества сна и формирования лучших привычек перед сном. Ознакомьтесь с ним прямо сейчас на сайте XIX.AI, чтобы раскрыть потенциал ИИ в вашей жизни.
10 инструментов
xix.ai
Анализ данных
AI-копилоты SQL для аналитики продуктов и выручки
2026: лучшие и самые популярные ИИ-помощники для работы с SQL в сфере аналитики продуктов и доходов! XIX.AI подготовила мощную, революционную подборку инструментов, которые обязательно стоит попробовать. Они проходят проверку в реальных условиях и включаются в еженедельно обновляемый рейтинг. Эти инструменты помогают пользователям значительно повысить продуктивность за счет ускорения анализа данных, оптимизации сложных запросов и получения точных аналитических выводов, которые позволяют принимать более обоснованные бизнес-решения. Ознакомьтесь с ними прямо сейчас, чтобы найти идеальный инструмент, который поможет вам раскрыть весь потенциал искусственного интеллекта!
14 инструментов
xix.ai
Образование и обучение
Лучшие помощники по домашним заданиям с ИИ, которые учат: изучайте концепции, а не просто ответы
2026: лучшие и самые популярные помощники по домашним заданиям с ИИ, которые обучают основным концепциям, а не просто дают готовые ответы. Мощные инструменты для студентов. Обязательный к пробованию тщательно отобранный список. Еженедельное обновление. Сравнение бесплатных и платных версий. Тестирование в реальных условиях. Точные рейтинги, которые помогут вам раскрыть весь свой учебный потенциал. Исследуйте сейчас, чтобы найти идеальный инструмент для более эффективного обучения.
10 инструментов
xix.ai

 Комментарии (0)
Хотя искусственный интеллект предоставляет удобства, распространяемая им дезинформация всё чаще нарушает правовые нормы. Недавно в Нанкине, провинция Цзянсу, было вынесено первое в Китае окончательное решение по делу о «клевете с использованием ИИ».
Исковое заявление было подано адвокатом из Цзянсу Ли Сяоляном, который обнаружил, что инструмент «интеллектуального ответа ИИ» компании Baidu сгенерировал ложные утверждения, включая вымышленное тюремное заключение сроком на три года. Как юридический специалист, он обязан поддерживать безупечную репутацию, и эти неточности нанесли ущерб его статусу и карьере.
В ответ на эту вредоносную дезинформацию Ли Сяолян подал в суд на компанию Beijing Baidu Netcom Science and Technology Co., Ltd., требуя правовой защиты от нарушения его прав.
Суд постановил, что системы искусственного интеллекта обязаны обеспечивать точность контента и избегать распространения ложной информации, наносящей ущерб репутации. Компания Baidu была признана виновной в нарушении прав Ли на репутацию посредством своих ответов ИИ и обязана понести юридическую ответственность.
Окончательное решение суда Нанкина подтвердило ответственность компании Baidu за клевету. Компании было предписано в течение десяти дней после вступления решения в силу опубликовать письменное извинение перед Ли Сяоляном для минимизации ущерба.
Это судебное решение устанавливает четкие правовые границы для контента, созданного искусственным интеллектом, напоминая технологическим компаниям, что алгоритмы подчиняются закону. Разработчики должны приоритетно уделять внимание проверке подлинности и соответствия выходных данных, одновременно развивая возможности моделей.








 Как исправить Core Web Vitals для улучшения позиций в поисковой выдаче?
Представляем Free Willy: Новая эра для языковых моделей с открытым исходным кодомСодержание:Woody's AI и Carper AI Lab: Стратегическое партнерствоКритическая роль обработки естественного языкаЗнакомство с Free Willy 1 и Free Willy 2Сравнение с к
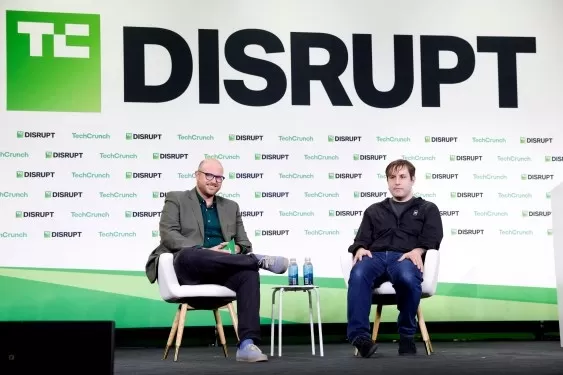 Завершилась конференция TechCrunch Disrupt 2026
Настал последний день TechCrunch Disrupt 2026, который станет кульминацией насыщенной недели. В третий день в выставочном центре Moscone West в Сан-Франциско, где собрались более 10 000 основателей ст
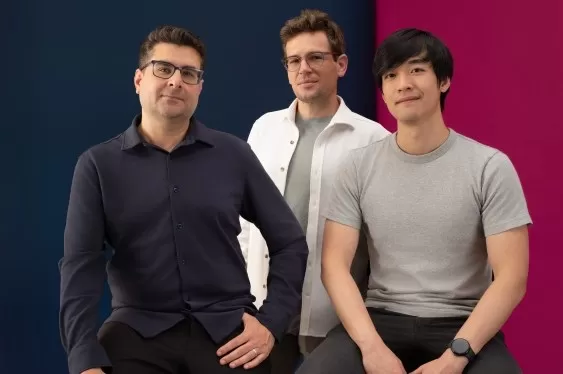 QueryStory призывает к осторожности в отношении контента, сгенерированного искусственным интеллектом
В 2009 году Шапор Нагибзаде, работая инженером по системному администрированию в Google, открыл для себя силу убедительного повествования. Во время операции «Аврора», когда хакеры, действующие по зака

2026: Новейшие и самые популярные инструменты для создания иллюстраций с помощью ИИ: в нашем тщательно подобранном списке представлены лучшие инструменты с мощными функциональными возможностями, позволяющие быстро создавать потрясающие редакционные сцены и привлекательные обложки. Каждый вариант прошел тщательные практические испытания; мы предлагаем сравнение бесплатных и платных версий, чтобы помочь вам найти идеальный вариант для вашего рабочего процесса. Попробуйте эти незаменимые решения уже сегодня, чтобы раскрыть потенциал искусственного интеллекта и повысить свою творческую продуктивность. Узнайте больше на сайте XIX.AI.
10 инструментов
xix.ai

2026 года: лучшие и самые популярные ИИ-репетиторы для подготовки к экзаменам представлены на XIX.AI! В нашем тщательно подобранном списке представлены мощные инструменты, которые кардинально изменят ваш подход к обучению: здесь вы найдете сравнение бесплатных и платных версий, тесты на практике и еженедельно обновляемые рейтинги. Они помогут повысить эффективность вашего письма, упростить изучение сложных тем и раскрыть ваш академический потенциал. Ознакомьтесь с ними прямо сейчас, чтобы найти идеальный инструмент для подготовки к экзаменам, и начните творить уже сегодня, чтобы раскрыть свои преимущества благодаря ИИ!
10 инструментов
xix.ai

В 2026 году на XIX.AI представлены новейшие, лучшие и наиболее рейтинговые инструменты ИИ для бюджетного планирования по личным финансам! Эта тщательно отобранная коллекция включает мощные, революционные решения, которые помогают проводить реальные тесты, понимать привычки расходов и создавать персонализированные планы для повышения продуктивности. Наслаждайтесь бесплатным сравнением с платными версиями вместе с подробными рейтингами. Инструменты, которые обязательно стоит попробовать, разработаны для упрощения управления деньгами и раскрытия вашего преимущества ИИ. Исследуйте сейчас!
11 инструментов
xix.ai

2026 год: лучшие и наиболее высоко оценённые помощники для отслеживания сна на основе ИИ, отобранные для максимального восстановления организма. В этом полностью обновлённом еженедельном руководстве представлены мощные инструменты с результатами реальных тестов, сравнением бесплатных и платных версий, а также подробными рейтингами, которые помогут вам найти оптимальное решение для улучшения качества сна и формирования лучших привычек перед сном. Ознакомьтесь с ним прямо сейчас на сайте XIX.AI, чтобы раскрыть потенциал ИИ в вашей жизни.
10 инструментов
xix.ai

2026: лучшие и самые популярные ИИ-помощники для работы с SQL в сфере аналитики продуктов и доходов! XIX.AI подготовила мощную, революционную подборку инструментов, которые обязательно стоит попробовать. Они проходят проверку в реальных условиях и включаются в еженедельно обновляемый рейтинг. Эти инструменты помогают пользователям значительно повысить продуктивность за счет ускорения анализа данных, оптимизации сложных запросов и получения точных аналитических выводов, которые позволяют принимать более обоснованные бизнес-решения. Ознакомьтесь с ними прямо сейчас, чтобы найти идеальный инструмент, который поможет вам раскрыть весь потенциал искусственного интеллекта!
14 инструментов
xix.ai

2026: лучшие и самые популярные помощники по домашним заданиям с ИИ, которые обучают основным концепциям, а не просто дают готовые ответы. Мощные инструменты для студентов. Обязательный к пробованию тщательно отобранный список. Еженедельное обновление. Сравнение бесплатных и платных версий. Тестирование в реальных условиях. Точные рейтинги, которые помогут вам раскрыть весь свой учебный потенциал. Исследуйте сейчас, чтобы найти идеальный инструмент для более эффективного обучения.
10 инструментов
xix.ai












