


 Дом
Vals, поддерживаемый Andreessen, нацелен на лидерство в области тестирования ИИ
Бенчмаркинг стал отраслевым стандартом того, как компании в сфере искусственного интеллекта проверяют возможности своих моделей, используют благоприятные метрики для выделения среди конкурентов и продвигают своё превосходство. Короче говоря, хорошие результаты бенчмаркинга почти всегда приводят к положительным публикациям в средствах массовой информации.
К сожалению, компании также нашли способы манипулировать устаревшими системами бенчмаркинга — многие из которых устарели и не предназначены для оценки возможностей современных моделей искусственного интеллекта.
Vals, стартап, основанный в 2024 году, стремится исправить эту flawed систему. Менее чем за два года компания утвердилась в качестве значимого игрока в технологическом секторе, привлек seed-раунд под руководством 8VC и Bloomberg Beta в прошлом году. Недавно, после периода быстрого расширения, она привлекла $40 миллионов в раунде Series A под руководством Andreessen Horowitz.
Rayan Krishnan, 25-летний сооснователь компании, ранее проходил стажировку в Palantir и, будучи студентом Стэнфорда, работал в Microsoft и в знаменитой лаборатории искусственного интеллекта университета. Krishnan объясняет, что Vals родился из его наблюдений за тем, что бенчмаркинг не успевает за быстрым развитием отрасли, которую он должен измерять.
«Мы видели, как на рынок быстро выходят новые, очень мощные модели, а академические бенчмарки [[не успевали]] за этим продвижением вперед», — отмечает Krishnan. Поскольку искусственный интеллект интегрируется во все аспекты общества, бенчмарки должны служить для проверки того, могут ли модели действительно выполнять то, что компании заявляют, что они могут делать, добавляет Krishnan.
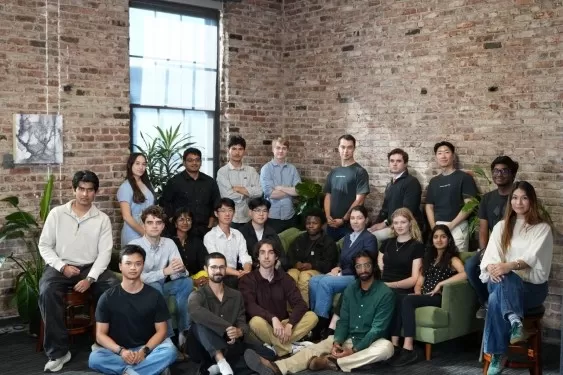
На прошлой неделе молодой основатель показал мне офис своей компании на двух этажах на улице Фолсом в Сан-Франциско — старое кирпичное здание, которое сто лет назад было большой пивоварней. Вместо производства пива это историческое здание теперь размещает различные стартапы, стремящиеся сформировать будущее технологической отрасли.
«Исторически, я думаю, оценка проводилась для оценки интеллекта очень абстрактным способом», — объясняет Krishnan. «Например, знают ли модели достаточно информации, чтобы сдать экзамен типа бар-экзамена?»
Здесь Vals стремится выделиться. В то время как многие системы бенчмаркинга предлагают общедоступные тесты (которые могут позволить компаниям тренировать свои модели на этих тестах, фактически жуя на экзаменах), Vals не раскрывает публично свои конкретные тестовые материалы. Вместо измерения общих знаний модели искусственного интеллекта, Vals также оценивает модели по их способности выполнять сложные задачи, связанные с конкретными отраслями, такими как право, финансы и программирование.
«То, что мы делаем, — это фактически посмотреть, каковы реальные последствия моделей», — говорит Krishnan. «Могут ли они выполнять работу, которая производит продукт того же качества, что и человек, в каждой области?»
Цель состоит в том, чтобы проверять не только положительные результаты, но и отрицательные, объясняет он. Надежда заключается в том, чтобы проанализировать, «если бы эти модели действовали свободно в мире, каковы были бы негативные последствия».
Возможности, которые измеряет Vals, расширяются. Помимо более традиционных отраслей, стартап продолжает исследовать уникальные домены. «У нас есть бенчмарк на рекурсивное самосовершенствование. Мы проводим некоторые работы в области психического здоровья, кибербезопасности, биобезопасности и даже права вооруженных конфликтов, чтобы модели понимали, как применять Женевскую конвенцию», — делится Krishnan.
Компании платят Vals за тестирование своих моделей, что может показаться контринтуитивным. Почему компания должна платить за то, чтобы узнать, что её модель работает плохо? Однако наличие эффективного измерения помогает компаниям устранять неполадки и улучшаться со временем. Krishnan сравнивает свою модель доходов с тем, как студент может заплатить College Board за сдачу SAT.
В свою очередь, эти оценки становятся ключевыми факторами принятия решений для компаний, стремящихся приобрести новые модели искусственного интеллекта.
Стартап недавно объявил, что его доход в настоящее время в восемь раз больше, чем был в прошлом году. Его штат также расширяется. Vals, который начал год всего с восемью людьми, уже утроился до команды из 25 человек. Krishnan заявил, что по мере роста стартапа план состоит в переезде в значительно больший офис и найме еще 10–15 человек. Компания также недавно запустила программу, ориентированную на предоставление оценок моделей федеральным агентствам.
Krishnan рассматривает систему бенчмаркинга своей компании как будущее того, как компании в сфере искусственного интеллекта думают о росте своего бизнеса и установлении общественного доверия.
«Компании в сфере искусственного интеллекта начинают выходить на публичный рынок. SpaceX вышла на публичный рынок. Anthropic запланирована на конец этого года. Я подозреваю, что OpenAI скоро выйдет на публичный рынок. Я думаю, что по мере того, как модели искусственного интеллекта станут основной частью экономики и будут более широко распространены, типы бенчмарков и оценок, которые мы проводим, будут определять их использование и станут центральной частью того, как эти компании подают публичные документы или говорят о перспективных инвестициях, которые они собираются сделать в искусственный интеллект», — сказал он.
Связанная статья
 Исполняющий обязанности генерального директора Apple Джон Тернус называет iPhone лучшим устройством с искусственным интеллектом
Надлежащий генеральный директор Apple Джон Тернус прояснил стратегию компании в области искусственного интеллекта во время мероприятия «Surprise and Shine», состоявшегося в среду, утверждая, что iPhone уже является ведущим устройством для ИИ и приори
Функция Claude’s Cowork теперь запоминает ваши предыдущие инструкции для чата
Обновление системы памяти Claude от Anthropic устраняет одно из главных препятствий при использовании ИИ-агентов: необходимость постоянно заново объяснять контекст, который ИИ уже помнит. Объединив архитектуры памяти стандартного чата и Claude Cowork
Gemini сталкивается с проблемами брендинга, как и вся индустрия ИИ в целом
Анонс Google в среду относительно новых функций голосового взаимодействия Gemini Live поднимает обоснованный вопрос: «Вам не нужно гадать, требует ли задача Spark, Ежедневную сводку или быстрый поиск в почтовом ящике». Хотя Google представляет это ка
Рекомендации по связанным специальным темам
Дизайн и искусство
 Лучшие инструменты для создания иллюстраций с помощью ИИ: быстрее создавайте редакционные сцены и обложки
2026: Новейшие и самые популярные инструменты для создания иллюстраций с помощью ИИ: в нашем тщательно подобранном списке представлены лучшие инструменты с мощными функциональными возможностями, позволяющие быстро создавать потрясающие редакционные сцены и привлекательные обложки. Каждый вариант прошел тщательные практические испытания; мы предлагаем сравнение бесплатных и платных версий, чтобы помочь вам найти идеальный вариант для вашего рабочего процесса. Попробуйте эти незаменимые решения уже сегодня, чтобы раскрыть потенциал искусственного интеллекта и повысить свою творческую продуктивность. Узнайте больше на сайте XIX.AI.
 10 инструментов
 xix.ai
Образование и обучение
Лучшие репетиторы по искусственному интеллекту для подготовки к экзаменам: практикуйтесь по математике, естественным наукам и английскому языку
2026 года: лучшие и самые популярные ИИ-репетиторы для подготовки к экзаменам представлены на XIX.AI! В нашем тщательно подобранном списке представлены мощные инструменты, которые кардинально изменят ваш подход к обучению: здесь вы найдете сравнение бесплатных и платных версий, тесты на практике и еженедельно обновляемые рейтинги. Они помогут повысить эффективность вашего письма, упростить изучение сложных тем и раскрыть ваш академический потенциал. Ознакомьтесь с ними прямо сейчас, чтобы найти идеальный инструмент для подготовки к экзаменам, и начните творить уже сегодня, чтобы раскрыть свои преимущества благодаря ИИ!
10 инструментов
xix.ai
Финансы
Инструменты планирования бюджета на основе ИИ для управления личными финансами
В 2026 году на XIX.AI представлены новейшие, лучшие и наиболее рейтинговые инструменты ИИ для бюджетного планирования по личным финансам! Эта тщательно отобранная коллекция включает мощные, революционные решения, которые помогают проводить реальные тесты, понимать привычки расходов и создавать персонализированные планы для повышения продуктивности. Наслаждайтесь бесплатным сравнением с платными версиями вместе с подробными рейтингами. Инструменты, которые обязательно стоит попробовать, разработаны для упрощения управления деньгами и раскрытия вашего преимущества ИИ. Исследуйте сейчас!
11 инструментов
xix.ai
Здоровье и благополучие
Помощники для отслеживания сна с ИИ: улучшите восстановление за счёт более правильных привычек перед сном
2026 год: лучшие и наиболее высоко оценённые помощники для отслеживания сна на основе ИИ, отобранные для максимального восстановления организма. В этом полностью обновлённом еженедельном руководстве представлены мощные инструменты с результатами реальных тестов, сравнением бесплатных и платных версий, а также подробными рейтингами, которые помогут вам найти оптимальное решение для улучшения качества сна и формирования лучших привычек перед сном. Ознакомьтесь с ним прямо сейчас на сайте XIX.AI, чтобы раскрыть потенциал ИИ в вашей жизни.
10 инструментов
xix.ai
Анализ данных
AI-копилоты SQL для аналитики продуктов и выручки
2026: лучшие и самые популярные ИИ-помощники для работы с SQL в сфере аналитики продуктов и доходов! XIX.AI подготовила мощную, революционную подборку инструментов, которые обязательно стоит попробовать. Они проходят проверку в реальных условиях и включаются в еженедельно обновляемый рейтинг. Эти инструменты помогают пользователям значительно повысить продуктивность за счет ускорения анализа данных, оптимизации сложных запросов и получения точных аналитических выводов, которые позволяют принимать более обоснованные бизнес-решения. Ознакомьтесь с ними прямо сейчас, чтобы найти идеальный инструмент, который поможет вам раскрыть весь потенциал искусственного интеллекта!
14 инструментов
xix.ai
Образование и обучение
Лучшие помощники по домашним заданиям с ИИ, которые учат: изучайте концепции, а не просто ответы
2026: лучшие и самые популярные помощники по домашним заданиям с ИИ, которые обучают основным концепциям, а не просто дают готовые ответы. Мощные инструменты для студентов. Обязательный к пробованию тщательно отобранный список. Еженедельное обновление. Сравнение бесплатных и платных версий. Тестирование в реальных условиях. Точные рейтинги, которые помогут вам раскрыть весь свой учебный потенциал. Исследуйте сейчас, чтобы найти идеальный инструмент для более эффективного обучения.
10 инструментов
xix.ai

 Комментарии (0)
Бенчмаркинг стал отраслевым стандартом того, как компании в сфере искусственного интеллекта проверяют возможности своих моделей, используют благоприятные метрики для выделения среди конкурентов и продвигают своё превосходство. Короче говоря, хорошие результаты бенчмаркинга почти всегда приводят к положительным публикациям в средствах массовой информации.
К сожалению, компании также нашли способы манипулировать устаревшими системами бенчмаркинга — многие из которых устарели и не предназначены для оценки возможностей современных моделей искусственного интеллекта.
Vals, стартап, основанный в 2024 году, стремится исправить эту flawed систему. Менее чем за два года компания утвердилась в качестве значимого игрока в технологическом секторе, привлек seed-раунд под руководством 8VC и Bloomberg Beta в прошлом году. Недавно, после периода быстрого расширения, она привлекла $40 миллионов в раунде Series A под руководством Andreessen Horowitz.
Rayan Krishnan, 25-летний сооснователь компании, ранее проходил стажировку в Palantir и, будучи студентом Стэнфорда, работал в Microsoft и в знаменитой лаборатории искусственного интеллекта университета. Krishnan объясняет, что Vals родился из его наблюдений за тем, что бенчмаркинг не успевает за быстрым развитием отрасли, которую он должен измерять.
«Мы видели, как на рынок быстро выходят новые, очень мощные модели, а академические бенчмарки [[не успевали]] за этим продвижением вперед», — отмечает Krishnan. Поскольку искусственный интеллект интегрируется во все аспекты общества, бенчмарки должны служить для проверки того, могут ли модели действительно выполнять то, что компании заявляют, что они могут делать, добавляет Krishnan.
На прошлой неделе молодой основатель показал мне офис своей компании на двух этажах на улице Фолсом в Сан-Франциско — старое кирпичное здание, которое сто лет назад было большой пивоварней. Вместо производства пива это историческое здание теперь размещает различные стартапы, стремящиеся сформировать будущее технологической отрасли.
«Исторически, я думаю, оценка проводилась для оценки интеллекта очень абстрактным способом», — объясняет Krishnan. «Например, знают ли модели достаточно информации, чтобы сдать экзамен типа бар-экзамена?»
Здесь Vals стремится выделиться. В то время как многие системы бенчмаркинга предлагают общедоступные тесты (которые могут позволить компаниям тренировать свои модели на этих тестах, фактически жуя на экзаменах), Vals не раскрывает публично свои конкретные тестовые материалы. Вместо измерения общих знаний модели искусственного интеллекта, Vals также оценивает модели по их способности выполнять сложные задачи, связанные с конкретными отраслями, такими как право, финансы и программирование.
«То, что мы делаем, — это фактически посмотреть, каковы реальные последствия моделей», — говорит Krishnan. «Могут ли они выполнять работу, которая производит продукт того же качества, что и человек, в каждой области?»
Цель состоит в том, чтобы проверять не только положительные результаты, но и отрицательные, объясняет он. Надежда заключается в том, чтобы проанализировать, «если бы эти модели действовали свободно в мире, каковы были бы негативные последствия».
Возможности, которые измеряет Vals, расширяются. Помимо более традиционных отраслей, стартап продолжает исследовать уникальные домены. «У нас есть бенчмарк на рекурсивное самосовершенствование. Мы проводим некоторые работы в области психического здоровья, кибербезопасности, биобезопасности и даже права вооруженных конфликтов, чтобы модели понимали, как применять Женевскую конвенцию», — делится Krishnan.
Компании платят Vals за тестирование своих моделей, что может показаться контринтуитивным. Почему компания должна платить за то, чтобы узнать, что её модель работает плохо? Однако наличие эффективного измерения помогает компаниям устранять неполадки и улучшаться со временем. Krishnan сравнивает свою модель доходов с тем, как студент может заплатить College Board за сдачу SAT.
В свою очередь, эти оценки становятся ключевыми факторами принятия решений для компаний, стремящихся приобрести новые модели искусственного интеллекта.
Стартап недавно объявил, что его доход в настоящее время в восемь раз больше, чем был в прошлом году. Его штат также расширяется. Vals, который начал год всего с восемью людьми, уже утроился до команды из 25 человек. Krishnan заявил, что по мере роста стартапа план состоит в переезде в значительно больший офис и найме еще 10–15 человек. Компания также недавно запустила программу, ориентированную на предоставление оценок моделей федеральным агентствам.
Krishnan рассматривает систему бенчмаркинга своей компании как будущее того, как компании в сфере искусственного интеллекта думают о росте своего бизнеса и установлении общественного доверия.
«Компании в сфере искусственного интеллекта начинают выходить на публичный рынок. SpaceX вышла на публичный рынок. Anthropic запланирована на конец этого года. Я подозреваю, что OpenAI скоро выйдет на публичный рынок. Я думаю, что по мере того, как модели искусственного интеллекта станут основной частью экономики и будут более широко распространены, типы бенчмарков и оценок, которые мы проводим, будут определять их использование и станут центральной частью того, как эти компании подают публичные документы или говорят о перспективных инвестициях, которые они собираются сделать в искусственный интеллект», — сказал он.








 Исполняющий обязанности генерального директора Apple Джон Тернус называет iPhone лучшим устройством с искусственным интеллектом
Надлежащий генеральный директор Apple Джон Тернус прояснил стратегию компании в области искусственного интеллекта во время мероприятия «Surprise and Shine», состоявшегося в среду, утверждая, что iPhone уже является ведущим устройством для ИИ и приори
 Функция Claude’s Cowork теперь запоминает ваши предыдущие инструкции для чата
Обновление системы памяти Claude от Anthropic устраняет одно из главных препятствий при использовании ИИ-агентов: необходимость постоянно заново объяснять контекст, который ИИ уже помнит. Объединив архитектуры памяти стандартного чата и Claude Cowork
 Gemini сталкивается с проблемами брендинга, как и вся индустрия ИИ в целом
Анонс Google в среду относительно новых функций голосового взаимодействия Gemini Live поднимает обоснованный вопрос: «Вам не нужно гадать, требует ли задача Spark, Ежедневную сводку или быстрый поиск в почтовом ящике». Хотя Google представляет это ка

2026: Новейшие и самые популярные инструменты для создания иллюстраций с помощью ИИ: в нашем тщательно подобранном списке представлены лучшие инструменты с мощными функциональными возможностями, позволяющие быстро создавать потрясающие редакционные сцены и привлекательные обложки. Каждый вариант прошел тщательные практические испытания; мы предлагаем сравнение бесплатных и платных версий, чтобы помочь вам найти идеальный вариант для вашего рабочего процесса. Попробуйте эти незаменимые решения уже сегодня, чтобы раскрыть потенциал искусственного интеллекта и повысить свою творческую продуктивность. Узнайте больше на сайте XIX.AI.
10 инструментов
xix.ai

2026 года: лучшие и самые популярные ИИ-репетиторы для подготовки к экзаменам представлены на XIX.AI! В нашем тщательно подобранном списке представлены мощные инструменты, которые кардинально изменят ваш подход к обучению: здесь вы найдете сравнение бесплатных и платных версий, тесты на практике и еженедельно обновляемые рейтинги. Они помогут повысить эффективность вашего письма, упростить изучение сложных тем и раскрыть ваш академический потенциал. Ознакомьтесь с ними прямо сейчас, чтобы найти идеальный инструмент для подготовки к экзаменам, и начните творить уже сегодня, чтобы раскрыть свои преимущества благодаря ИИ!
10 инструментов
xix.ai

В 2026 году на XIX.AI представлены новейшие, лучшие и наиболее рейтинговые инструменты ИИ для бюджетного планирования по личным финансам! Эта тщательно отобранная коллекция включает мощные, революционные решения, которые помогают проводить реальные тесты, понимать привычки расходов и создавать персонализированные планы для повышения продуктивности. Наслаждайтесь бесплатным сравнением с платными версиями вместе с подробными рейтингами. Инструменты, которые обязательно стоит попробовать, разработаны для упрощения управления деньгами и раскрытия вашего преимущества ИИ. Исследуйте сейчас!
11 инструментов
xix.ai

2026 год: лучшие и наиболее высоко оценённые помощники для отслеживания сна на основе ИИ, отобранные для максимального восстановления организма. В этом полностью обновлённом еженедельном руководстве представлены мощные инструменты с результатами реальных тестов, сравнением бесплатных и платных версий, а также подробными рейтингами, которые помогут вам найти оптимальное решение для улучшения качества сна и формирования лучших привычек перед сном. Ознакомьтесь с ним прямо сейчас на сайте XIX.AI, чтобы раскрыть потенциал ИИ в вашей жизни.
10 инструментов
xix.ai

2026: лучшие и самые популярные ИИ-помощники для работы с SQL в сфере аналитики продуктов и доходов! XIX.AI подготовила мощную, революционную подборку инструментов, которые обязательно стоит попробовать. Они проходят проверку в реальных условиях и включаются в еженедельно обновляемый рейтинг. Эти инструменты помогают пользователям значительно повысить продуктивность за счет ускорения анализа данных, оптимизации сложных запросов и получения точных аналитических выводов, которые позволяют принимать более обоснованные бизнес-решения. Ознакомьтесь с ними прямо сейчас, чтобы найти идеальный инструмент, который поможет вам раскрыть весь потенциал искусственного интеллекта!
14 инструментов
xix.ai

2026: лучшие и самые популярные помощники по домашним заданиям с ИИ, которые обучают основным концепциям, а не просто дают готовые ответы. Мощные инструменты для студентов. Обязательный к пробованию тщательно отобранный список. Еженедельное обновление. Сравнение бесплатных и платных версий. Тестирование в реальных условиях. Точные рейтинги, которые помогут вам раскрыть весь свой учебный потенциал. Исследуйте сейчас, чтобы найти идеальный инструмент для более эффективного обучения.
10 инструментов
xix.ai












