


 Lar
A Vals, apoiada por Andreessen, visa liderar o setor de avaliação de benchmarks de IA
O benchmarking tornou-se o padrão da indústria para como as empresas de IA validam as capacidades de seus modelos, alavancam métricas favoráveis para se diferenciar dos concorrentes e comercializam sua superioridade. Em resumo, bons resultados em benchmarks quase sempre se traduzem em relações públicas positivas.
Infelizmente, as empresas também descobriram maneiras de manipular os sistemas de benchmarking legados — muitos dos quais estão desatualizados e não foram projetados para avaliar as capacidades dos modelos modernos de IA.
A Vals, uma startup fundada em 2024, visa corrigir esse sistema falho. Em menos de dois anos, a empresa consolidou-se como uma participante significativa no setor de tecnologia, garantindo uma rodada de investimento inicial (seed round) liderada pela 8VC e pela Bloomberg Beta no ano passado. Mais recentemente, após um período de rápida expansão, ela captou US$ 40 milhões em uma rodada Série A liderada pela Andreessen Horowitz.
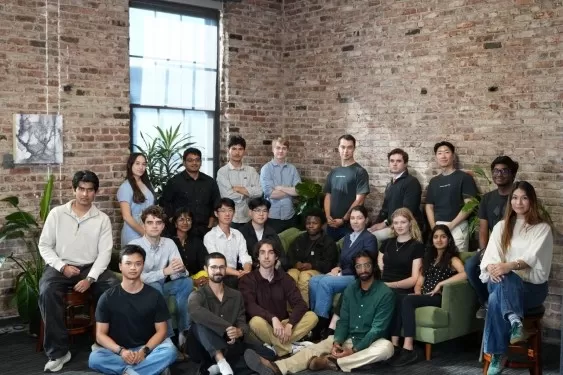
Rayan Krishnan, co-fundador de 25 anos da empresa, anteriormente estagiou na Palantir e, como graduando na Stanford, trabalhou para a Microsoft e para o renomado laboratório de inteligência artificial da universidade. Krishnan explica que a Vals nasceu de suas observações de que o benchmarking estava falhando em acompanhar os rápidos avanços da indústria que se destinava a medir.
“Estávamos vendo vários novos modelos muito capazes chegarem rapidamente ao mercado, e os benchmarks acadêmicos [não] estavam acompanhando esse avanço de fronteira”, observa Krishnan. Com a IA sendo integrada a todos os aspectos da sociedade, os benchmarks deveriam servir para verificar se os modelos realmente conseguem realizar o que as empresas afirmam que podem fazer, acrescenta Krishnan.
Na semana passada, o jovem fundador me deu um tour pelo escritório de dois andares de sua empresa na Rua Folsom, em São Francisco — um antigo prédio de tijolos que, há um século, abrigava uma grande cervejaria. Em vez de produzir cerveja, essa estrutura histórica agora abriga várias startups que visam moldar o futuro da indústria de tecnologia.
“Historicamente, acho que a avaliação era feita para avaliar a inteligência de maneira muito abstrata”, explica Krishnan. “Tipo, os modelos sabem informações suficientes para conseguir passar em um tipo de exame da ordem dos advogados?”
Aqui, a Vals busca se diferenciar. Enquanto muitos sistemas de benchmarking oferecem testes publicamente disponíveis (o que pode permitir que as empresas treinem seus modelos contra esses testes, efetivamente colando em suas provas), a Vals não divulga publicamente seus materiais de teste específicos. Em vez de medir o conhecimento geral de um modelo de IA, a Vals também avalia os modelos em sua capacidade de concluir tarefas complexas associadas a setores específicos, como direito, finanças e programação.
“O que estamos fazendo é realmente olhar para quais são os impactos reais dos modelos”, diz Krishnan. “Eles podem fazer um trabalho que produza um produto da mesma qualidade de um humano em todos os domínios?”
O objetivo é verificar não apenas os resultados positivos, mas também os negativos, explica ele. A esperança é analisar como, “se esses modelos operassem livremente no mundo, quais seriam as implicações negativas.”
As capacidades medidas pela Vals estão se expandindo. Além de setores mais tradicionais, a startup continua explorando domínios únicos. “Temos um benchmark sobre melhoria recursiva por autoaperfeiçoamento. Estamos fazendo algum trabalho em saúde mental, cibersegurança, biosegurança e até mesmo na lei do conflito armado para modelos entenderem como aplicar a Convenção de Genebra”, compartilha Krishnan.
As empresas pagam à Vals para testar seus modelos, um conceito que pode parecer contra-intuitivo. Por que uma empresa pagaria para descobrir que seu modelo não está performando bem? No entanto, ter uma medição eficaz ajuda as empresas a solucionar problemas e melhorar ao longo do tempo. Krishnan compara seu modelo de receita à forma como um estudante pode pagar ao College Board para fazer o SAT.
Por sua vez, essas avaliações estão se tornando fatores-chave de tomada de decisão para empresas que buscam adquirir novos modelos de IA.
A startup revelou recentemente que sua receita atual é oito vezes maior do que era no ano passado. Sua equipe também está se expandindo. A Vals, que começou o ano com apenas oito pessoas, já triplicou para uma equipe de 25. Krishnan afirmou que, à medida que a startup cresce, o plano é se mudar para um escritório significativamente maior e contratar mais 10 a 15 pessoas. A empresa também lançou recentemente um programa focado em fornecer avaliações de modelos para agências federais.
Krishnan vê o sistema de benchmarking de sua empresa como o futuro de como as empresas de IA pensam sobre o crescimento de seus negócios e o estabelecimento de confiança pública.
“As empresas de IA estão começando a abrir capital. A SpaceX abriu capital. A Anthropic está programada para o final deste ano. Suspeito que a OpenAI se torne pública em breve. Acho que, à medida que os modelos de IA se tornam uma parte central da economia e são difundidos mais amplamente, os tipos de benchmarks e avaliações que fazemos vão impulsionar seu uso e ser uma parte central de como essas empresas submetem relatórios públicos ou falam sobre os investimentos prospectivos que farão em IA”, disse ele.
Artigo relacionado
 O executivo da Apple, John Ternus, afirma que o iPhone é o melhor dispositivo de IA
O futuro CEO da Apple, John Ternus, esclareceu a estratégia de inteligência artificial da empresa durante o evento Surprise and Shine desta quarta-feira, afirmando que o iPhone já é o dispositivo de IA de ponta e priorizando a privacidade dos dados d
O recurso de cowork do Claude agora recupera suas instruções anteriores de chat
A atualização do sistema de memória do Claude, pela Anthropic, elimina um grande ponto de atrito no uso de agentes de IA: a necessidade repetitiva de reexplicar o contexto que a IA já retém. Ao fundir as arquiteturas de memória do chat padrão e do Cl
O Gemini enfrenta desafios de marca, assim como a indústria de IA em geral
O anúncio da Google na quarta-feira sobre os novos recursos de voz do Gemini Live faz um ponto válido: “Você não deveria ter que adivinhar se uma tarefa requer o Spark, o Resumo Diário ou uma rápida busca na caixa de entrada.” Embora a Google apresen
Recomendações de tópicos especiais relacionados
Design e Arte
 As melhores ferramentas de ilustração com IA: crie cenas editoriais e capas de forma mais rápida
As melhores ferramentas de ilustração com IA de 2026: nossa lista selecionada apresenta as melhores ferramentas, com design robusto, para criar rapidamente cenas editoriais impressionantes e capas atraentes. Cada opção passou por rigorosos testes práticos, oferecendo uma comparação entre versões gratuitas e pagas para ajudar você a encontrar a opção perfeita para o seu fluxo de trabalho. Experimente hoje mesmo essas soluções imperdíveis para aproveitar ao máximo as vantagens da IA e impulsionar sua produtividade criativa. Explore agora no XIX.AI.
 10 ferramentas
 xix.ai
Educação e Aprendizagem
Os melhores professores particulares especializados em IA para preparação para exames: pratique matemática, ciências e inglês
Os melhores tutores de IA para preparação para exames de 2026, com as melhores avaliações, estão aqui no XIX.AI! Nossa lista cuidadosamente selecionada apresenta ferramentas poderosas e revolucionárias que oferecem comparação entre versões gratuitas e pagas, testes práticos e rankings atualizados semanalmente. Elas ajudam a aumentar sua eficiência na redação, simplificar o aprendizado de tópicos complexos e liberar seu potencial acadêmico. Explore agora para descobrir sua ferramenta perfeita de preparação para exames e comece a criar hoje mesmo para aproveitar toda a vantagem da IA!
10 ferramentas
xix.ai
Financiar
Ferramentas de planejamento orçamentário com IA para gestão financeira pessoal
As melhores e mais bem avaliadas ferramentas de planejamento orçamentário com IA para gestão financeira pessoal de 2026 estão aqui no XIX.AI! Esta seleção especial apresenta soluções poderosas e revolucionárias que ajudam você a realizar testes na prática, entender hábitos de consumo e criar planos personalizados para aumentar a produtividade. Confira uma comparação entre versões gratuitas e pagas, além de rankings detalhados. Ferramentas imperdíveis, projetadas para simplificar a gestão financeira e explorar o potencial da IA. Explore agora!
11 ferramentas
xix.ai
Saúde e Bem-Estar
Assistentes de rastreamento do sono com IA: melhore sua recuperação adotando hábitos mais adequados antes de dormir
2026 – Os melhores assistentes de rastreamento do sono com inteligência artificial mais bem avaliados, selecionados para proporcionar uma recuperação máxima. Este guia semanal completamente atualizado apresenta ferramentas poderosas que incluem testes reais, comparações entre versões gratuitas e pagas, além de classificações detalhadas, visando ajudá-lo a encontrar a solução ideal para melhorar a qualidade do sono e fomentar hábitos noturnos mais saudáveis. Explore agora em XIX.AI e aproveite todas as vantagens oferecidas pela inteligência artificial.
10 ferramentas
xix.ai
Análise de dados
Copilotos de IA em SQL para análise de produtos e receitas
2026: Os melhores e mais bem avaliados copilotos de IA para SQL em análise de produtos e receitas! A XIX.AI selecionou um conjunto poderoso e revolucionário de ferramentas imperdíveis, que passam por testes práticos por meio de rankings atualizados semanalmente. Essas ferramentas ajudam os usuários a aumentar significativamente a produtividade, acelerando a análise de dados, simplificando consultas complexas e gerando insights precisos para impulsionar decisões de negócios mais inteligentes. Explore agora e descubra a ferramenta perfeita para aproveitar ao máximo o potencial da IA!
14 ferramentas
xix.ai
Educação e Aprendizagem
Os melhores auxiliares de tarefas escolares com IA que ensinam: aprenda conceitos, não apenas respostas
2026: Os melhores e mais bem avaliados auxiliares de tarefas com IA que ensinam conceitos fundamentais, não apenas respostas. Ferramentas poderosas para estudantes. Lista selecionada que você não pode deixar de conferir. Atualizada semanalmente. Comparação entre versões gratuitas e pagas. Testes em situações reais. Rankings precisos para ajudar você a atingir todo o seu potencial de aprendizado. Explore agora e descubra a ferramenta perfeita para estudar de forma mais inteligente.
10 ferramentas
xix.ai

 Comentários (0)
O benchmarking tornou-se o padrão da indústria para como as empresas de IA validam as capacidades de seus modelos, alavancam métricas favoráveis para se diferenciar dos concorrentes e comercializam sua superioridade. Em resumo, bons resultados em benchmarks quase sempre se traduzem em relações públicas positivas.
Infelizmente, as empresas também descobriram maneiras de manipular os sistemas de benchmarking legados — muitos dos quais estão desatualizados e não foram projetados para avaliar as capacidades dos modelos modernos de IA.
A Vals, uma startup fundada em 2024, visa corrigir esse sistema falho. Em menos de dois anos, a empresa consolidou-se como uma participante significativa no setor de tecnologia, garantindo uma rodada de investimento inicial (seed round) liderada pela 8VC e pela Bloomberg Beta no ano passado. Mais recentemente, após um período de rápida expansão, ela captou US$ 40 milhões em uma rodada Série A liderada pela Andreessen Horowitz.
Rayan Krishnan, co-fundador de 25 anos da empresa, anteriormente estagiou na Palantir e, como graduando na Stanford, trabalhou para a Microsoft e para o renomado laboratório de inteligência artificial da universidade. Krishnan explica que a Vals nasceu de suas observações de que o benchmarking estava falhando em acompanhar os rápidos avanços da indústria que se destinava a medir.
“Estávamos vendo vários novos modelos muito capazes chegarem rapidamente ao mercado, e os benchmarks acadêmicos [não] estavam acompanhando esse avanço de fronteira”, observa Krishnan. Com a IA sendo integrada a todos os aspectos da sociedade, os benchmarks deveriam servir para verificar se os modelos realmente conseguem realizar o que as empresas afirmam que podem fazer, acrescenta Krishnan.
Na semana passada, o jovem fundador me deu um tour pelo escritório de dois andares de sua empresa na Rua Folsom, em São Francisco — um antigo prédio de tijolos que, há um século, abrigava uma grande cervejaria. Em vez de produzir cerveja, essa estrutura histórica agora abriga várias startups que visam moldar o futuro da indústria de tecnologia.
“Historicamente, acho que a avaliação era feita para avaliar a inteligência de maneira muito abstrata”, explica Krishnan. “Tipo, os modelos sabem informações suficientes para conseguir passar em um tipo de exame da ordem dos advogados?”
Aqui, a Vals busca se diferenciar. Enquanto muitos sistemas de benchmarking oferecem testes publicamente disponíveis (o que pode permitir que as empresas treinem seus modelos contra esses testes, efetivamente colando em suas provas), a Vals não divulga publicamente seus materiais de teste específicos. Em vez de medir o conhecimento geral de um modelo de IA, a Vals também avalia os modelos em sua capacidade de concluir tarefas complexas associadas a setores específicos, como direito, finanças e programação.
“O que estamos fazendo é realmente olhar para quais são os impactos reais dos modelos”, diz Krishnan. “Eles podem fazer um trabalho que produza um produto da mesma qualidade de um humano em todos os domínios?”
O objetivo é verificar não apenas os resultados positivos, mas também os negativos, explica ele. A esperança é analisar como, “se esses modelos operassem livremente no mundo, quais seriam as implicações negativas.”
As capacidades medidas pela Vals estão se expandindo. Além de setores mais tradicionais, a startup continua explorando domínios únicos. “Temos um benchmark sobre melhoria recursiva por autoaperfeiçoamento. Estamos fazendo algum trabalho em saúde mental, cibersegurança, biosegurança e até mesmo na lei do conflito armado para modelos entenderem como aplicar a Convenção de Genebra”, compartilha Krishnan.
As empresas pagam à Vals para testar seus modelos, um conceito que pode parecer contra-intuitivo. Por que uma empresa pagaria para descobrir que seu modelo não está performando bem? No entanto, ter uma medição eficaz ajuda as empresas a solucionar problemas e melhorar ao longo do tempo. Krishnan compara seu modelo de receita à forma como um estudante pode pagar ao College Board para fazer o SAT.
Por sua vez, essas avaliações estão se tornando fatores-chave de tomada de decisão para empresas que buscam adquirir novos modelos de IA.
A startup revelou recentemente que sua receita atual é oito vezes maior do que era no ano passado. Sua equipe também está se expandindo. A Vals, que começou o ano com apenas oito pessoas, já triplicou para uma equipe de 25. Krishnan afirmou que, à medida que a startup cresce, o plano é se mudar para um escritório significativamente maior e contratar mais 10 a 15 pessoas. A empresa também lançou recentemente um programa focado em fornecer avaliações de modelos para agências federais.
Krishnan vê o sistema de benchmarking de sua empresa como o futuro de como as empresas de IA pensam sobre o crescimento de seus negócios e o estabelecimento de confiança pública.
“As empresas de IA estão começando a abrir capital. A SpaceX abriu capital. A Anthropic está programada para o final deste ano. Suspeito que a OpenAI se torne pública em breve. Acho que, à medida que os modelos de IA se tornam uma parte central da economia e são difundidos mais amplamente, os tipos de benchmarks e avaliações que fazemos vão impulsionar seu uso e ser uma parte central de como essas empresas submetem relatórios públicos ou falam sobre os investimentos prospectivos que farão em IA”, disse ele.








 O executivo da Apple, John Ternus, afirma que o iPhone é o melhor dispositivo de IA
O futuro CEO da Apple, John Ternus, esclareceu a estratégia de inteligência artificial da empresa durante o evento Surprise and Shine desta quarta-feira, afirmando que o iPhone já é o dispositivo de IA de ponta e priorizando a privacidade dos dados d
 O recurso de cowork do Claude agora recupera suas instruções anteriores de chat
A atualização do sistema de memória do Claude, pela Anthropic, elimina um grande ponto de atrito no uso de agentes de IA: a necessidade repetitiva de reexplicar o contexto que a IA já retém. Ao fundir as arquiteturas de memória do chat padrão e do Cl
 O Gemini enfrenta desafios de marca, assim como a indústria de IA em geral
O anúncio da Google na quarta-feira sobre os novos recursos de voz do Gemini Live faz um ponto válido: “Você não deveria ter que adivinhar se uma tarefa requer o Spark, o Resumo Diário ou uma rápida busca na caixa de entrada.” Embora a Google apresen

As melhores ferramentas de ilustração com IA de 2026: nossa lista selecionada apresenta as melhores ferramentas, com design robusto, para criar rapidamente cenas editoriais impressionantes e capas atraentes. Cada opção passou por rigorosos testes práticos, oferecendo uma comparação entre versões gratuitas e pagas para ajudar você a encontrar a opção perfeita para o seu fluxo de trabalho. Experimente hoje mesmo essas soluções imperdíveis para aproveitar ao máximo as vantagens da IA e impulsionar sua produtividade criativa. Explore agora no XIX.AI.
10 ferramentas
xix.ai

Os melhores tutores de IA para preparação para exames de 2026, com as melhores avaliações, estão aqui no XIX.AI! Nossa lista cuidadosamente selecionada apresenta ferramentas poderosas e revolucionárias que oferecem comparação entre versões gratuitas e pagas, testes práticos e rankings atualizados semanalmente. Elas ajudam a aumentar sua eficiência na redação, simplificar o aprendizado de tópicos complexos e liberar seu potencial acadêmico. Explore agora para descobrir sua ferramenta perfeita de preparação para exames e comece a criar hoje mesmo para aproveitar toda a vantagem da IA!
10 ferramentas
xix.ai

As melhores e mais bem avaliadas ferramentas de planejamento orçamentário com IA para gestão financeira pessoal de 2026 estão aqui no XIX.AI! Esta seleção especial apresenta soluções poderosas e revolucionárias que ajudam você a realizar testes na prática, entender hábitos de consumo e criar planos personalizados para aumentar a produtividade. Confira uma comparação entre versões gratuitas e pagas, além de rankings detalhados. Ferramentas imperdíveis, projetadas para simplificar a gestão financeira e explorar o potencial da IA. Explore agora!
11 ferramentas
xix.ai

2026 – Os melhores assistentes de rastreamento do sono com inteligência artificial mais bem avaliados, selecionados para proporcionar uma recuperação máxima. Este guia semanal completamente atualizado apresenta ferramentas poderosas que incluem testes reais, comparações entre versões gratuitas e pagas, além de classificações detalhadas, visando ajudá-lo a encontrar a solução ideal para melhorar a qualidade do sono e fomentar hábitos noturnos mais saudáveis. Explore agora em XIX.AI e aproveite todas as vantagens oferecidas pela inteligência artificial.
10 ferramentas
xix.ai

2026: Os melhores e mais bem avaliados copilotos de IA para SQL em análise de produtos e receitas! A XIX.AI selecionou um conjunto poderoso e revolucionário de ferramentas imperdíveis, que passam por testes práticos por meio de rankings atualizados semanalmente. Essas ferramentas ajudam os usuários a aumentar significativamente a produtividade, acelerando a análise de dados, simplificando consultas complexas e gerando insights precisos para impulsionar decisões de negócios mais inteligentes. Explore agora e descubra a ferramenta perfeita para aproveitar ao máximo o potencial da IA!
14 ferramentas
xix.ai

2026: Os melhores e mais bem avaliados auxiliares de tarefas com IA que ensinam conceitos fundamentais, não apenas respostas. Ferramentas poderosas para estudantes. Lista selecionada que você não pode deixar de conferir. Atualizada semanalmente. Comparação entre versões gratuitas e pagas. Testes em situações reais. Rankings precisos para ajudar você a atingir todo o seu potencial de aprendizado. Explore agora e descubra a ferramenta perfeita para estudar de forma mais inteligente.
10 ferramentas
xix.ai












