


 Дом
Плагин AI от Sakana AI упрощает обработку документов для крупных моделей
Проблемы крупных языковых моделей с обработкой длинных текстов, часто называемые «проблемой памяти», вскоре могут остаться в прошлом. Недавно токийский стартап Sakana AI, занимающийся искусственным интеллектом, представил две революционные технологии: Text-to-LoRA (T2L) и Doc-to-LoRA (D2L). Используя инновационную архитектуру «суперсети», эти технологии позволяют крупным моделям «поглощать» объемные документы или осваивать новые задачи менее чем за секунду, и все это без повторного обучения.
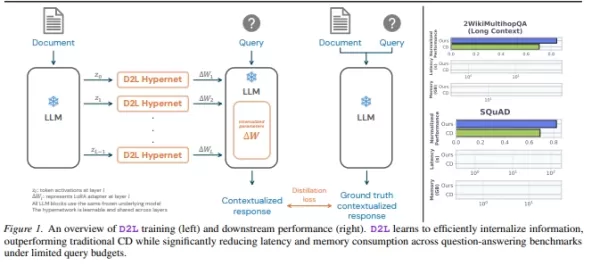
Разработчики ИИ долгое время сталкивались с трудным выбором: впихивать длинные документы в окно чата — что замедляет ответы и потребляет много памяти — или платить высокую цену за тонкую настройку модели. Sakana AI предлагает третий вариант. За одноразовую плату за предварительное обучение она генерирует крошечные весовые плагины (LoRA) для недорогой и эффективной адаптации модели.
Doc-to-LoRA: потребность в памяти снижается с 12 ГБ до всего 50 МБ
Это самая впечатляющая технология в последней версии. Обработка документа из 128 000 токенов (примерно 100 000 слов) традиционными методами требует более 12 ГБ видеопамяти для хранения информации. С помощью D2L модель может напрямую «переварить» эту информацию в плагин размером менее 50 МБ.
Невероятная скорость: старым технологиям требуется от 40 до 100 секунд на обработку документа, тогда как D2L справляется с этим менее чем за 1 секунду.
Расширение границ: это позволяет моделям обрабатывать текст, который в четыре раза длиннее их исходного контекстного окна, достигая почти идеальной точности в тестах на поиск «иголки в стоге сена».
Text-to-LoRA: адаптация ИИ к повседневному языку
Text-to-LoRA делает модели более отзывчивыми. Пользователи просто описывают задачу на естественном языке — например, «помоги мне решить сложную задачу математического олимпиады» — и система автоматически генерирует специальный плагин для повышения производительности. Эксперименты показывают, что адаптеры, созданные таким образом, могут превосходить по производительности специализированные модели, обученные с нуля на задачах по математике и логическому мышлению.
Мощная кросс-модальная технология: позволяющая текстовым моделям «видеть» изображения
Исследователи обнаружили неожиданный бонус: D2L демонстрирует сильные кросс-модальные способности. Путем отображения визуальной информации в параметры чисто текстовой модели, модель, которая никогда ранее не обрабатывала изображения, может классифицировать их с точностью **75,03%**.
Достижения Sakana AI значительно снижают барьер для частных лиц и компаний при настройке частных моделей ИИ. Они также прокладывают новый путь к разработке более легкого и интеллектуального общего искусственного интеллекта (AGI).
Статья: https://arxiv.org/pdf/2602.15902
Связанная статья
 Партнер Леди Гаги поддерживает биотехнологическую компанию, использующую живую кожу для обучения ИИ в целях исследований и разработок в сфере красоты
Работая вдали от ярких прожекторов Кремниевой долины, биотехнологический стартап Outer Biosciences переосмысливает основы косметологии и медицинских исследований. Компания, соучредителем которой являе
Spotify будет маркировать профили, созданные с помощью ИИ, и исключать соответствующую музыку из рекомендаций
Во вторник Spotify объявила, что начнёт помечать исполнителей, созданных с помощью ИИ, метками «AI Persona» в профилях и исключать их треки из редакционных и алгоритмических рекомендаций.С середины се
Массачусетс вводит новые требования к чистой энергии для центров обработки данных
Массачусетс присоединился к растущему списку штатов, требующих от центров обработки данных обеспечения собственного энергоснабжения, но с существенным уточнением. Новое государственное постановление обязывает разработчиков, строящих объекты мощностью
Рекомендации по связанным специальным темам
Дизайн и искусство
 Лучшие инструменты для создания иллюстраций с помощью ИИ: быстрее создавайте редакционные сцены и обложки
2026: Новейшие и самые популярные инструменты для создания иллюстраций с помощью ИИ: в нашем тщательно подобранном списке представлены лучшие инструменты с мощными функциональными возможностями, позволяющие быстро создавать потрясающие редакционные сцены и привлекательные обложки. Каждый вариант прошел тщательные практические испытания; мы предлагаем сравнение бесплатных и платных версий, чтобы помочь вам найти идеальный вариант для вашего рабочего процесса. Попробуйте эти незаменимые решения уже сегодня, чтобы раскрыть потенциал искусственного интеллекта и повысить свою творческую продуктивность. Узнайте больше на сайте XIX.AI.
 10 инструментов
 xix.ai
Образование и обучение
Лучшие репетиторы по искусственному интеллекту для подготовки к экзаменам: практикуйтесь по математике, естественным наукам и английскому языку
2026 года: лучшие и самые популярные ИИ-репетиторы для подготовки к экзаменам представлены на XIX.AI! В нашем тщательно подобранном списке представлены мощные инструменты, которые кардинально изменят ваш подход к обучению: здесь вы найдете сравнение бесплатных и платных версий, тесты на практике и еженедельно обновляемые рейтинги. Они помогут повысить эффективность вашего письма, упростить изучение сложных тем и раскрыть ваш академический потенциал. Ознакомьтесь с ними прямо сейчас, чтобы найти идеальный инструмент для подготовки к экзаменам, и начните творить уже сегодня, чтобы раскрыть свои преимущества благодаря ИИ!
10 инструментов
xix.ai
Финансы
Инструменты планирования бюджета на основе ИИ для управления личными финансами
В 2026 году на XIX.AI представлены новейшие, лучшие и наиболее рейтинговые инструменты ИИ для бюджетного планирования по личным финансам! Эта тщательно отобранная коллекция включает мощные, революционные решения, которые помогают проводить реальные тесты, понимать привычки расходов и создавать персонализированные планы для повышения продуктивности. Наслаждайтесь бесплатным сравнением с платными версиями вместе с подробными рейтингами. Инструменты, которые обязательно стоит попробовать, разработаны для упрощения управления деньгами и раскрытия вашего преимущества ИИ. Исследуйте сейчас!
11 инструментов
xix.ai
Здоровье и благополучие
Помощники для отслеживания сна с ИИ: улучшите восстановление за счёт более правильных привычек перед сном
2026 год: лучшие и наиболее высоко оценённые помощники для отслеживания сна на основе ИИ, отобранные для максимального восстановления организма. В этом полностью обновлённом еженедельном руководстве представлены мощные инструменты с результатами реальных тестов, сравнением бесплатных и платных версий, а также подробными рейтингами, которые помогут вам найти оптимальное решение для улучшения качества сна и формирования лучших привычек перед сном. Ознакомьтесь с ним прямо сейчас на сайте XIX.AI, чтобы раскрыть потенциал ИИ в вашей жизни.
10 инструментов
xix.ai
Анализ данных
AI-копилоты SQL для аналитики продуктов и выручки
2026: лучшие и самые популярные ИИ-помощники для работы с SQL в сфере аналитики продуктов и доходов! XIX.AI подготовила мощную, революционную подборку инструментов, которые обязательно стоит попробовать. Они проходят проверку в реальных условиях и включаются в еженедельно обновляемый рейтинг. Эти инструменты помогают пользователям значительно повысить продуктивность за счет ускорения анализа данных, оптимизации сложных запросов и получения точных аналитических выводов, которые позволяют принимать более обоснованные бизнес-решения. Ознакомьтесь с ними прямо сейчас, чтобы найти идеальный инструмент, который поможет вам раскрыть весь потенциал искусственного интеллекта!
14 инструментов
xix.ai
Образование и обучение
Лучшие помощники по домашним заданиям с ИИ, которые учат: изучайте концепции, а не просто ответы
2026: лучшие и самые популярные помощники по домашним заданиям с ИИ, которые обучают основным концепциям, а не просто дают готовые ответы. Мощные инструменты для студентов. Обязательный к пробованию тщательно отобранный список. Еженедельное обновление. Сравнение бесплатных и платных версий. Тестирование в реальных условиях. Точные рейтинги, которые помогут вам раскрыть весь свой учебный потенциал. Исследуйте сейчас, чтобы найти идеальный инструмент для более эффективного обучения.
10 инструментов
xix.ai

 Комментарии (0)
Проблемы крупных языковых моделей с обработкой длинных текстов, часто называемые «проблемой памяти», вскоре могут остаться в прошлом. Недавно токийский стартап Sakana AI, занимающийся искусственным интеллектом, представил две революционные технологии: Text-to-LoRA (T2L) и Doc-to-LoRA (D2L). Используя инновационную архитектуру «суперсети», эти технологии позволяют крупным моделям «поглощать» объемные документы или осваивать новые задачи менее чем за секунду, и все это без повторного обучения.
Разработчики ИИ долгое время сталкивались с трудным выбором: впихивать длинные документы в окно чата — что замедляет ответы и потребляет много памяти — или платить высокую цену за тонкую настройку модели. Sakana AI предлагает третий вариант. За одноразовую плату за предварительное обучение она генерирует крошечные весовые плагины (LoRA) для недорогой и эффективной адаптации модели.
Doc-to-LoRA: потребность в памяти снижается с 12 ГБ до всего 50 МБ
Это самая впечатляющая технология в последней версии. Обработка документа из 128 000 токенов (примерно 100 000 слов) традиционными методами требует более 12 ГБ видеопамяти для хранения информации. С помощью D2L модель может напрямую «переварить» эту информацию в плагин размером менее 50 МБ.
Невероятная скорость: старым технологиям требуется от 40 до 100 секунд на обработку документа, тогда как D2L справляется с этим менее чем за 1 секунду.
Расширение границ: это позволяет моделям обрабатывать текст, который в четыре раза длиннее их исходного контекстного окна, достигая почти идеальной точности в тестах на поиск «иголки в стоге сена».
Text-to-LoRA: адаптация ИИ к повседневному языку
Text-to-LoRA делает модели более отзывчивыми. Пользователи просто описывают задачу на естественном языке — например, «помоги мне решить сложную задачу математического олимпиады» — и система автоматически генерирует специальный плагин для повышения производительности. Эксперименты показывают, что адаптеры, созданные таким образом, могут превосходить по производительности специализированные модели, обученные с нуля на задачах по математике и логическому мышлению.
Мощная кросс-модальная технология: позволяющая текстовым моделям «видеть» изображения
Исследователи обнаружили неожиданный бонус: D2L демонстрирует сильные кросс-модальные способности. Путем отображения визуальной информации в параметры чисто текстовой модели, модель, которая никогда ранее не обрабатывала изображения, может классифицировать их с точностью **75,03%**.
Достижения Sakana AI значительно снижают барьер для частных лиц и компаний при настройке частных моделей ИИ. Они также прокладывают новый путь к разработке более легкого и интеллектуального общего искусственного интеллекта (AGI).
Статья: https://arxiv.org/pdf/2602.15902








 Партнер Леди Гаги поддерживает биотехнологическую компанию, использующую живую кожу для обучения ИИ в целях исследований и разработок в сфере красоты
Работая вдали от ярких прожекторов Кремниевой долины, биотехнологический стартап Outer Biosciences переосмысливает основы косметологии и медицинских исследований. Компания, соучредителем которой являе
 Spotify будет маркировать профили, созданные с помощью ИИ, и исключать соответствующую музыку из рекомендаций
Во вторник Spotify объявила, что начнёт помечать исполнителей, созданных с помощью ИИ, метками «AI Persona» в профилях и исключать их треки из редакционных и алгоритмических рекомендаций.С середины се
 Массачусетс вводит новые требования к чистой энергии для центров обработки данных
Массачусетс присоединился к растущему списку штатов, требующих от центров обработки данных обеспечения собственного энергоснабжения, но с существенным уточнением. Новое государственное постановление обязывает разработчиков, строящих объекты мощностью

2026: Новейшие и самые популярные инструменты для создания иллюстраций с помощью ИИ: в нашем тщательно подобранном списке представлены лучшие инструменты с мощными функциональными возможностями, позволяющие быстро создавать потрясающие редакционные сцены и привлекательные обложки. Каждый вариант прошел тщательные практические испытания; мы предлагаем сравнение бесплатных и платных версий, чтобы помочь вам найти идеальный вариант для вашего рабочего процесса. Попробуйте эти незаменимые решения уже сегодня, чтобы раскрыть потенциал искусственного интеллекта и повысить свою творческую продуктивность. Узнайте больше на сайте XIX.AI.
10 инструментов
xix.ai

2026 года: лучшие и самые популярные ИИ-репетиторы для подготовки к экзаменам представлены на XIX.AI! В нашем тщательно подобранном списке представлены мощные инструменты, которые кардинально изменят ваш подход к обучению: здесь вы найдете сравнение бесплатных и платных версий, тесты на практике и еженедельно обновляемые рейтинги. Они помогут повысить эффективность вашего письма, упростить изучение сложных тем и раскрыть ваш академический потенциал. Ознакомьтесь с ними прямо сейчас, чтобы найти идеальный инструмент для подготовки к экзаменам, и начните творить уже сегодня, чтобы раскрыть свои преимущества благодаря ИИ!
10 инструментов
xix.ai

В 2026 году на XIX.AI представлены новейшие, лучшие и наиболее рейтинговые инструменты ИИ для бюджетного планирования по личным финансам! Эта тщательно отобранная коллекция включает мощные, революционные решения, которые помогают проводить реальные тесты, понимать привычки расходов и создавать персонализированные планы для повышения продуктивности. Наслаждайтесь бесплатным сравнением с платными версиями вместе с подробными рейтингами. Инструменты, которые обязательно стоит попробовать, разработаны для упрощения управления деньгами и раскрытия вашего преимущества ИИ. Исследуйте сейчас!
11 инструментов
xix.ai

2026 год: лучшие и наиболее высоко оценённые помощники для отслеживания сна на основе ИИ, отобранные для максимального восстановления организма. В этом полностью обновлённом еженедельном руководстве представлены мощные инструменты с результатами реальных тестов, сравнением бесплатных и платных версий, а также подробными рейтингами, которые помогут вам найти оптимальное решение для улучшения качества сна и формирования лучших привычек перед сном. Ознакомьтесь с ним прямо сейчас на сайте XIX.AI, чтобы раскрыть потенциал ИИ в вашей жизни.
10 инструментов
xix.ai

2026: лучшие и самые популярные ИИ-помощники для работы с SQL в сфере аналитики продуктов и доходов! XIX.AI подготовила мощную, революционную подборку инструментов, которые обязательно стоит попробовать. Они проходят проверку в реальных условиях и включаются в еженедельно обновляемый рейтинг. Эти инструменты помогают пользователям значительно повысить продуктивность за счет ускорения анализа данных, оптимизации сложных запросов и получения точных аналитических выводов, которые позволяют принимать более обоснованные бизнес-решения. Ознакомьтесь с ними прямо сейчас, чтобы найти идеальный инструмент, который поможет вам раскрыть весь потенциал искусственного интеллекта!
14 инструментов
xix.ai

2026: лучшие и самые популярные помощники по домашним заданиям с ИИ, которые обучают основным концепциям, а не просто дают готовые ответы. Мощные инструменты для студентов. Обязательный к пробованию тщательно отобранный список. Еженедельное обновление. Сравнение бесплатных и платных версий. Тестирование в реальных условиях. Точные рейтинги, которые помогут вам раскрыть весь свой учебный потенциал. Исследуйте сейчас, чтобы найти идеальный инструмент для более эффективного обучения.
10 инструментов
xix.ai












