


 Hogar
El complemento de IA de Sakana AI simplifica el procesamiento de documentos para modelos de gran tamaño
Las dificultades que tienen los modelos de lenguaje a gran escala para procesar textos largos, lo que a menudo se denomina «ansiedad de memoria», podrían ser pronto cosa del pasado. Recientemente, la startup de IA con sede en Tokio Sakana AI presentó dos tecnologías revolucionarias: Text-to-LoRA (T2L) y Doc-to-LoRA (D2L). Gracias a una innovadora arquitectura de «superred», estas tecnologías permiten a los modelos grandes «absorber» documentos masivos o aprender nuevas tareas en menos de un segundo, todo ello sin necesidad de volver a entrenarlos.
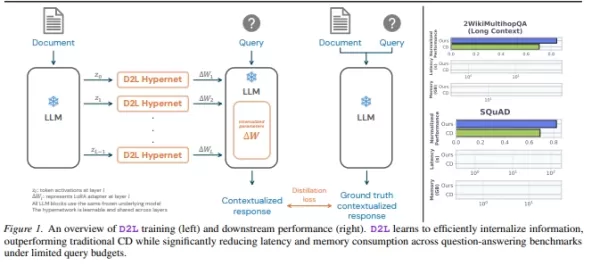
Los desarrolladores de IA se han enfrentado durante mucho tiempo a una difícil disyuntiva: meter documentos extensos en una ventana de chat —lo que ralentiza las respuestas y consume mucha memoria— o pagar el elevado coste que supone el ajuste fino de un modelo. Sakana AI introduce una tercera opción. Mediante un pago único por el preentrenamiento, genera plugins de peso minúsculo (LoRA) para lograr una adaptación del modelo eficiente y de bajo coste.
Doc-to-LoRA: las necesidades de memoria se reducen de 12 GB a solo 50 MB
Esta es la tecnología más impresionante de la última versión. Procesar un documento de 128 000 tokens (aproximadamente 100 000 palabras) con métodos tradicionales requiere más de 12 GB de VRAM para almacenar la información. Con D2L, el modelo puede «digerir» directamente esta información en un plugin de menos de 50 MB.
Velocidad extraordinaria: la tecnología tradicional tarda entre 40 y 100 segundos en procesar un documento, mientras que D2L lo hace en menos de 1 segundo.
Ampliando los límites: permite a los modelos manejar textos hasta cuatro veces más largos que su ventana de contexto original, logrando una precisión casi perfecta en pruebas de recuperación del tipo «aguja en un pajar».
Text-to-LoRA: personaliza la IA con lenguaje cotidiano
Text-to-LoRA hace que los modelos sean más receptivos. Los usuarios simplemente describen una tarea en lenguaje natural —por ejemplo, «ayúdame a resolver un problema complejo de una competición de matemáticas»— y el sistema genera automáticamente un complemento específico para mejorar el rendimiento. Los experimentos revelan que los adaptadores creados de esta manera pueden superar a los modelos específicos entrenados desde cero en tareas de matemáticas y razonamiento lógico.
Potente tecnología multimodal: permite a los modelos de texto «ver» imágenes
Los investigadores descubrieron una ventaja inesperada: D2L muestra una gran capacidad multimodal. Al mapear la información visual en los parámetros de un modelo de texto puro, un modelo que nunca antes había procesado imágenes puede clasificarlas con una precisión del **75,03 %**.
Los logros de Sakana AI reducen significativamente las barreras para que particulares y empresas personalicen modelos de IA privados. También allanan un nuevo camino hacia el desarrollo de una inteligencia artificial general (AGI) más ligera e inteligente.
Artículo: https://arxiv.org/pdf/2602.15902
Artículo relacionado
 Vals, respaldado por Andreessen, apunta al liderazgo en evaluación de benchmarks de IA
El benchmarking se ha convertido en el estándar de la industria para que las empresas de inteligencia artificial validen las capacidades de sus modelos, aprovechen métricas favorables para diferenciarse de la competencia y comercialicen su superiorid
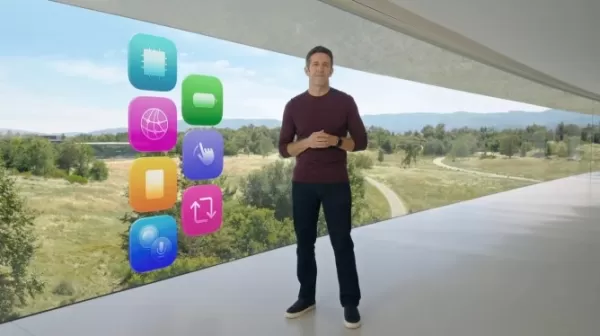
El ejecutivo de Apple, John Ternus, afirma que el iPhone es el mejor dispositivo con inteligencia artificial
El próximo director ejecutivo de Apple, John Ternus, aclaró la estrategia de inteligencia artificial de la compañía durante el evento Sorpresa y Brillo del miércoles, afirmando que el iPhone ya es el dispositivo de IA principal y priorizando la priva
Qwen-Audio-3.0-TTS: El modelo de síntesis de voz a gran escala de Qwen reduce la demora del primer paquete a 300 ms
La competencia en tecnología de voz entre los principales desarrolladores de inteligencia artificial se ha intensificado con una nueva incorporación. El 20 de julio, Qwen lanzó su último modelo de síntesis de audio, Qwen-Audio-3.0-TTS, desplazando el
Recomendaciones de temas especiales relacionados
Diseño y Arte
 Las mejores herramientas de ilustración con IA: crea escenas editoriales y portadas más rápido
Las mejores herramientas de ilustración con IA de 2026: nuestra lista seleccionada incluye las mejores herramientas, diseñadas con gran potencia, para crear rápidamente impresionantes escenas editoriales y llamativas portadas. Cada opción ha sido sometida a rigurosas pruebas en condiciones reales y ofrece una comparación entre las versiones gratuitas y de pago para ayudarte a encontrar la que mejor se adapte a tu flujo de trabajo. Prueba hoy mismo estas soluciones imprescindibles para sacar el máximo partido a la IA y potenciar tu productividad creativa. Descúbrelas ahora en XIX.AI.
 10 herramientas
 xix.ai
Educación y aprendizaje
Los mejores profesores particulares de IA para la preparación de exámenes: practica matemáticas, ciencias e inglés
¡Ya están aquí, en XIX.AI, los mejores tutores de IA para la preparación de exámenes de 2026, con las mejores valoraciones! Nuestra lista seleccionada incluye potentes herramientas revolucionarias que ofrecen comparativas entre versiones gratuitas y de pago, pruebas reales y clasificaciones actualizadas semanalmente. Te ayudan a mejorar tu eficiencia a la hora de escribir, a simplificar el aprendizaje de temas complejos y a desarrollar todo tu potencial académico. ¡Explora ahora mismo para descubrir tu herramienta perfecta de preparación de exámenes y empieza a crear hoy mismo para sacar partido a tu ventaja con la IA!
10 herramientas
xix.ai
Finanzas
Herramientas de planificación presupuestaria con IA para la gestión personal del dinero
2026 Últimas Mejores Herramientas de Planificación Presupuestaria con IA Mejor Valoradas para la Gestión Personal del Dinero están aquí en XIX.AI. Esta colección seleccionada presenta soluciones poderosas y transformadoras que te ayudan a realizar pruebas en el mundo real, comprender tus hábitos de gasto y crear planes personalizados para aumentar la productividad. Disfruta de una comparación entre versiones gratuitas y de pago junto con clasificaciones detalladas. Herramientas imprescindibles diseñadas para simplificar la gestión del dinero y desbloquear tu ventaja con IA. ¡Explóralas ahora!
11 herramientas
xix.ai
Salud y bienestar
Asistentes de seguimiento del sueño basados en IA: mejora tu recuperación con mejores hábitos a la hora de acostarte
Los mejores asistentes de seguimiento del sueño con IA de 2026, seleccionados para una recuperación óptima. Esta guía semanal totalmente actualizada incluye potentes herramientas que ofrecen pruebas en condiciones reales, comparativas entre opciones gratuitas y de pago, y clasificaciones detalladas para ayudarte a encontrar la solución imprescindible que mejora la calidad del sueño y fomenta mejores hábitos a la hora de acostarse. Descúbrelo ahora en XIX.AI y aprovecha todas las ventajas de la IA.
10 herramientas
xix.ai
Análisis de datos
Copilotos de IA y SQL para el análisis de productos e ingresos
¡Los mejores copilotos de IA para SQL mejor valorados de 2026 para el análisis de productos e ingresos! XIX.AI ha seleccionado una potente colección de herramientas revolucionarias que no te puedes perder y que se someten a pruebas en el mundo real a través de clasificaciones que se actualizan semanalmente. Estas herramientas ayudan a los usuarios a aumentar significativamente su productividad al acelerar el análisis de datos, simplificar consultas complejas y generar información precisa para tomar decisiones empresariales más inteligentes. ¡Explora ahora mismo y descubre la herramienta perfecta para sacar el máximo partido a tu ventaja en IA!
14 herramientas
xix.ai
Educación y aprendizaje
Las mejores herramientas de IA para los deberes que realmente enseñan: aprende conceptos, no solo respuestas
2026: los mejores y más valorados asistentes de deberes con IA que enseñan conceptos básicos, no solo respuestas. Potentes herramientas para estudiantes. Una selección imprescindible que debes probar. Actualización semanal. Comparativa entre opciones gratuitas y de pago. Pruebas en el mundo real. Clasificaciones precisas para ayudarte a desarrollar todo tu potencial de aprendizaje. Explora ahora y descubre la herramienta perfecta para estudiar de forma más inteligente.
10 herramientas
xix.ai

 comentario (0)
0/500
Las dificultades que tienen los modelos de lenguaje a gran escala para procesar textos largos, lo que a menudo se denomina «ansiedad de memoria», podrían ser pronto cosa del pasado. Recientemente, la startup de IA con sede en Tokio Sakana AI presentó dos tecnologías revolucionarias: Text-to-LoRA (T2L) y Doc-to-LoRA (D2L). Gracias a una innovadora arquitectura de «superred», estas tecnologías permiten a los modelos grandes «absorber» documentos masivos o aprender nuevas tareas en menos de un segundo, todo ello sin necesidad de volver a entrenarlos.
Los desarrolladores de IA se han enfrentado durante mucho tiempo a una difícil disyuntiva: meter documentos extensos en una ventana de chat —lo que ralentiza las respuestas y consume mucha memoria— o pagar el elevado coste que supone el ajuste fino de un modelo. Sakana AI introduce una tercera opción. Mediante un pago único por el preentrenamiento, genera plugins de peso minúsculo (LoRA) para lograr una adaptación del modelo eficiente y de bajo coste.
Doc-to-LoRA: las necesidades de memoria se reducen de 12 GB a solo 50 MB
Esta es la tecnología más impresionante de la última versión. Procesar un documento de 128 000 tokens (aproximadamente 100 000 palabras) con métodos tradicionales requiere más de 12 GB de VRAM para almacenar la información. Con D2L, el modelo puede «digerir» directamente esta información en un plugin de menos de 50 MB.
Velocidad extraordinaria: la tecnología tradicional tarda entre 40 y 100 segundos en procesar un documento, mientras que D2L lo hace en menos de 1 segundo.
Ampliando los límites: permite a los modelos manejar textos hasta cuatro veces más largos que su ventana de contexto original, logrando una precisión casi perfecta en pruebas de recuperación del tipo «aguja en un pajar».
Text-to-LoRA: personaliza la IA con lenguaje cotidiano
Text-to-LoRA hace que los modelos sean más receptivos. Los usuarios simplemente describen una tarea en lenguaje natural —por ejemplo, «ayúdame a resolver un problema complejo de una competición de matemáticas»— y el sistema genera automáticamente un complemento específico para mejorar el rendimiento. Los experimentos revelan que los adaptadores creados de esta manera pueden superar a los modelos específicos entrenados desde cero en tareas de matemáticas y razonamiento lógico.
Potente tecnología multimodal: permite a los modelos de texto «ver» imágenes
Los investigadores descubrieron una ventaja inesperada: D2L muestra una gran capacidad multimodal. Al mapear la información visual en los parámetros de un modelo de texto puro, un modelo que nunca antes había procesado imágenes puede clasificarlas con una precisión del **75,03 %**.
Los logros de Sakana AI reducen significativamente las barreras para que particulares y empresas personalicen modelos de IA privados. También allanan un nuevo camino hacia el desarrollo de una inteligencia artificial general (AGI) más ligera e inteligente.
Artículo: https://arxiv.org/pdf/2602.15902








 Vals, respaldado por Andreessen, apunta al liderazgo en evaluación de benchmarks de IA
El benchmarking se ha convertido en el estándar de la industria para que las empresas de inteligencia artificial validen las capacidades de sus modelos, aprovechen métricas favorables para diferenciarse de la competencia y comercialicen su superiorid
 El ejecutivo de Apple, John Ternus, afirma que el iPhone es el mejor dispositivo con inteligencia artificial
El próximo director ejecutivo de Apple, John Ternus, aclaró la estrategia de inteligencia artificial de la compañía durante el evento Sorpresa y Brillo del miércoles, afirmando que el iPhone ya es el dispositivo de IA principal y priorizando la priva
 Qwen-Audio-3.0-TTS: El modelo de síntesis de voz a gran escala de Qwen reduce la demora del primer paquete a 300 ms
La competencia en tecnología de voz entre los principales desarrolladores de inteligencia artificial se ha intensificado con una nueva incorporación. El 20 de julio, Qwen lanzó su último modelo de síntesis de audio, Qwen-Audio-3.0-TTS, desplazando el

Las mejores herramientas de ilustración con IA de 2026: nuestra lista seleccionada incluye las mejores herramientas, diseñadas con gran potencia, para crear rápidamente impresionantes escenas editoriales y llamativas portadas. Cada opción ha sido sometida a rigurosas pruebas en condiciones reales y ofrece una comparación entre las versiones gratuitas y de pago para ayudarte a encontrar la que mejor se adapte a tu flujo de trabajo. Prueba hoy mismo estas soluciones imprescindibles para sacar el máximo partido a la IA y potenciar tu productividad creativa. Descúbrelas ahora en XIX.AI.
10 herramientas
xix.ai

¡Ya están aquí, en XIX.AI, los mejores tutores de IA para la preparación de exámenes de 2026, con las mejores valoraciones! Nuestra lista seleccionada incluye potentes herramientas revolucionarias que ofrecen comparativas entre versiones gratuitas y de pago, pruebas reales y clasificaciones actualizadas semanalmente. Te ayudan a mejorar tu eficiencia a la hora de escribir, a simplificar el aprendizaje de temas complejos y a desarrollar todo tu potencial académico. ¡Explora ahora mismo para descubrir tu herramienta perfecta de preparación de exámenes y empieza a crear hoy mismo para sacar partido a tu ventaja con la IA!
10 herramientas
xix.ai

2026 Últimas Mejores Herramientas de Planificación Presupuestaria con IA Mejor Valoradas para la Gestión Personal del Dinero están aquí en XIX.AI. Esta colección seleccionada presenta soluciones poderosas y transformadoras que te ayudan a realizar pruebas en el mundo real, comprender tus hábitos de gasto y crear planes personalizados para aumentar la productividad. Disfruta de una comparación entre versiones gratuitas y de pago junto con clasificaciones detalladas. Herramientas imprescindibles diseñadas para simplificar la gestión del dinero y desbloquear tu ventaja con IA. ¡Explóralas ahora!
11 herramientas
xix.ai

Los mejores asistentes de seguimiento del sueño con IA de 2026, seleccionados para una recuperación óptima. Esta guía semanal totalmente actualizada incluye potentes herramientas que ofrecen pruebas en condiciones reales, comparativas entre opciones gratuitas y de pago, y clasificaciones detalladas para ayudarte a encontrar la solución imprescindible que mejora la calidad del sueño y fomenta mejores hábitos a la hora de acostarse. Descúbrelo ahora en XIX.AI y aprovecha todas las ventajas de la IA.
10 herramientas
xix.ai

¡Los mejores copilotos de IA para SQL mejor valorados de 2026 para el análisis de productos e ingresos! XIX.AI ha seleccionado una potente colección de herramientas revolucionarias que no te puedes perder y que se someten a pruebas en el mundo real a través de clasificaciones que se actualizan semanalmente. Estas herramientas ayudan a los usuarios a aumentar significativamente su productividad al acelerar el análisis de datos, simplificar consultas complejas y generar información precisa para tomar decisiones empresariales más inteligentes. ¡Explora ahora mismo y descubre la herramienta perfecta para sacar el máximo partido a tu ventaja en IA!
14 herramientas
xix.ai

2026: los mejores y más valorados asistentes de deberes con IA que enseñan conceptos básicos, no solo respuestas. Potentes herramientas para estudiantes. Una selección imprescindible que debes probar. Actualización semanal. Comparativa entre opciones gratuitas y de pago. Pruebas en el mundo real. Clasificaciones precisas para ayudarte a desarrollar todo tu potencial de aprendizaje. Explora ahora y descubre la herramienta perfecta para estudiar de forma más inteligente.
10 herramientas
xix.ai












