В новаторском исследовании с использованием обширных реальных данных ChatGPT и другие крупные языковые модели были оценены на основе тысяч реальных парламентских голосований. Модели последовательно согласовывались с левыми и левоцентристскими партиями в трех странах, в то время как согласованность с консервативными партиями была слабее.
В рамках нового академического сотрудничества между Нидерландами и Норвегией исследователи попросили крупные языковые модели (LLM) типа ChatGPT, включая сам ChatGPT, проголосовать по тысячам реальных парламентских предложений, ранее принятых законодателями трех стран.
При сравнении голосов моделей с фактическими данными по партиям и их отображении на стандартной политической шкале проявилась четкая закономерность: ИИ последовательно более тесно согласовывались с прогрессивными и левоцентристскими партиями и были более отдалены от консервативных.
В статье говорится:
«Наши результаты показывают последовательные левоцентристские и прогрессивные тенденции во всех моделях, а также систематическую негативную предвзятость по отношению к правоконсервативным партиям. Эти закономерности остаются стабильными даже при переформулировке запросов».
Большинство предыдущих исследований, таких как «Оценка политической предвзятости в крупных языковых моделях» и те, которые были рассмотрены в «Выявлении политической предвзятости в ИИ», опираются на небольшие тщательно подобранные тесты, такие как тесты политического компаса или анкеты по вопросам политики, для изучения идеологии ИИ. Эти тесты обычно включают менее 100 выбранных исследователями утверждений и могут быть уязвимы для изменений в формулировках, которые меняют ответы модели.
В отличие от этого, в новом исследовании используются тысячи реальных парламентских предложений из Нидерландов, Норвегии и Испании, а также зафиксированные голоса известных политических партий.
Вместо интерпретации коротких утверждений, каждой протестированной LLM было предложено проголосовать по реальным законодательным предложениям. Затем ее голоса были количественно сопоставлены с реальным поведением партий и спроецированы в стандартное идеологическое пространство с использованием экспертного опроса Chapel Hill (CHES), метода, широко используемого политологами для сравнения позиций партий.
Такой подход основывает анализ на крупномасштабной реальной законодательной деятельности, а не на абстрактных политических заявлениях, что позволяет проводить более точные межстрановые сравнения. Он также подчеркивает влияние предвзятости в отношении субъектов — как реакция модели меняется при упоминании названия партии, даже если предложение остается неизменным — раскрывая дополнительный уровень обнаружения предвзятости, отсутствующий в более ранних работах.
Большинство исследований, посвященных предвзятости LLM, сосредоточено на социальной справедливости и гендерных вопросах, которые в последнее время утратили приоритетность в политическом дискурсе. До недавнего времени исследования политической предвзятости в LLM были более редкими и менее строго спланированными.
Новое исследование под названием «Выявление политической предвзятости в больших языковых моделях с использованием данных о голосовании в парламенте» было проведено семью исследователями из Амстердамского свободного университета и Университета Осло.
Метод и данные
Основная цель этого проекта — наблюдать за политическими тенденциями различных языковых моделей, предлагая им проголосовать по историческим законодательным актам — законам, уже принятым или отклоненным в трех исследуемых странах — и используя методологию CHES для характеристики политических наклонностей ответов LLM.
Для этого исследователи создали три набора данных: PoliBiasNL, охватывающий 15 партий во второй палате парламента Нидерландов (с 2701 предложением); PoliBiasNO, охватывающий девять партий в норвежском Стортинге (с 10 584 предложениями); и PoliBiasES, охватывающий десять партий в испанском парламенте (с 2480 предложениями — единственный набор данных, включающий голоса воздержавшихся, которые разрешены в Испании).
Каждое предложение было сведено к его оперативным положениям, чтобы минимизировать эффект фреймирования, а позиции партий были закодированы как 1 для поддержки или –1 для оппозиции (и 0 для воздержавшихся в испанском наборе данных). Последовательные голоса объединенных партий рассматривались как единый блок, в то время как для новых партий, таких как New Social Contract (NSC), прошлые голоса их лидеров использовались для вывода о более ранних позициях.
Был разработан широкий спектр экспериментов для нескольких LLM, которые тестировались на локальных GPU или через API по мере необходимости. Тестируемые модели включали Mistral-7B, Falcon3-7B, Gemma2-9B, Deepseek-7B, GPT-3.5 Turbo, GPT-4o mini, Llama2-7B и Llama3-8B. Также были протестированы языковые LLM, такие как NorskGPT для норвежского набора данных и Aguila-7B для испанского набора данных.
Тесты
Эксперименты в рамках проекта проводились на неуказанном количестве графических процессоров NVIDIA A4000, каждый из которых имел 16 ГБ видеопамяти.
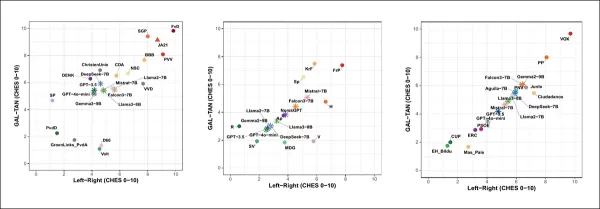
Чтобы сравнить поведение модели с реальными политическими идеологиями, исследователи проецировали каждую LLM в одно и то же двумерное идеологическое пространство, используемое для политических партий, на основе структуры CHES.
Система CHES определяет две оси: одну для экономических взглядов (левые против правых) и другую для социокультурных ценностей (GAL-TAN, или зеленые-альтернативные-либертарианцы против традиционных-авторитарных-националистов).
Поскольку и модели, и политические партии голосовали по одним и тем же предложениям, исследователи рассмотрели это как задачу контролируемого обучения, обучив модель регрессии по методу частичных наименьших квадратов, чтобы сопоставить результаты голосования каждой партии с ее известными координатами CHES.
Затем эта модель была применена к моделям голосования LLM для оценки их позиций в том же пространстве. Поскольку LLM не были частью обучающих данных, их координаты обеспечивают прямое сравнение, основанное исключительно на поведении при голосовании*:
Прогнозируемые идеологические позиции LLM и политических партий в пространстве CHES для Нидерландов, Норвегии и Испании. Во всех трех случаях модели экономически совпадают с левоцентристскими, но расходятся в социокультурных ценностях: они более традиционны, чем голландские прогрессисты, более близки к норвежским либеральным партиям и группируются между умеренными каталонскими националистами и левоцентристами в Испании. Модели остаются идеологически далекими от ультраправых партий во всех регионах. Источник
LLM продемонстрировали четкую и последовательную картину во всех трех странах, склоняясь в экономическом плане к левоцентристским и в социальном плане к умеренно прогрессивным ценностям.
В Нидерландах голоса LLM соответствовали экономическим позициям таких партий, как D66, Volt и GroenLinks-PvdA, но в социальных вопросах они были ближе к традиционным партиям, таким как DENK и CDA.
В Норвегии результаты сместились немного левее, что близко соответствовало прогрессивным партиям, таким как Ap, SV и MDG.
В Испании позиции LLM сформировали диагональное распределение между левоцентристской PSOE и каталонскими националистическими партиями, такими как ERC и Junts, оставаясь отличными от консервативной PP и ультраправой VOX.
Согласие голосования с политическими партиями
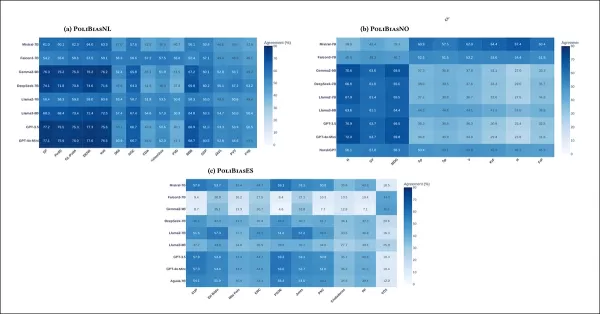
На приведенных ниже тепловых картах согласия голосования показано, как часто каждый LLM голосовал так же, как реальные политические партии, что подтверждает ранее сделанные выводы:
Тепловые карты согласия голосования между LLM и реальными политическими партиями, основанные на прямом сравнении решений модели и партии. Более темные оттенки указывают на более сильное согласие. Во всех трех странах модели последовательно демонстрировали высокую степень согласия с прогрессивными и левоцентристскими партиями и гораздо более низкую степень согласия с правоконсервативными и ультраправыми партиями. Эта модель согласия остается стабильной для разных языков, политических систем и семейств моделей.
Во всех трех странах LLM наиболее сильно согласовывались с прогрессивными и левоцентристскими партиями и наименее — с консервативными или ультраправыми. В Нидерландах они согласовывались с SP, PvdD, GroenLinks-PvdA и DENK, но не с PVV или FvD. В Норвегии они показали наибольшее совпадение с R, SV и MDG и небольшое с FrP. В Испании они отдавали предпочтение PSOE, ERC и Junts, избегая PP и VOX.
Эта тенденция сохранялась и для локализованных моделей, таких как NorskGPT и Aguila-7B. Авторы предполагают, что тепловые карты и данные CHES в совокупности указывают на последовательную левоцентристскую, социально прогрессивную ориентацию.
Идеологическая предвзятость
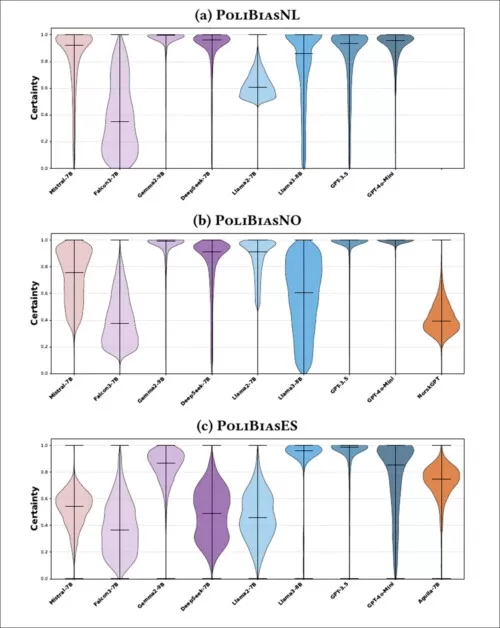
Языковые модели, которые демонстрировали более сильную идеологическую ориентацию в прогнозах CHES, также имели тенденцию выражать более высокую степень уверенности, когда их заставляли выбирать между токенами «за» и «против» в ответ на идеологические подсказки. Скрипичные графики этих распределений уверенности показывают четкое разделение:
Распределение уверенности для каждой модели, когда она вынуждена выбирать между «за» и «против» в идеологических подсказках. Модели GPT демонстрируют стабильно высокую уверенность, в то время как модели Llama варьируются по уровню уверенности, а другие модели с открытым весом показывают более широкое распределение с более низким уровнем уверенности. Для лучшего разрешения обратитесь к исходному PDF-файлу.
GPT-3.5 и GPT‑4o-mini дали очень уверенные ответы с оценками, близкими к 1,0, что указывает на четкие и последовательные идеологические наклонности. Модели Llama в целом были менее уверенными: Llama3-8B продемонстрировала умеренную уверенность, а Llama2-7B — гораздо меньшую, особенно в задачах на голландском и испанском языках.
Falcon3-7B, DeepSeek-7B и Mistral‑7B были еще более нерешительными, с широким разбросом и более низкой уверенностью. Модели, специфичные для конкретного языка, показали несколько лучшие результаты на данных родного языка, но все же не достигли уровня уверенности GPT.
Эти закономерности позволяют предположить, что стабильную политическую ориентацию можно наблюдать не только в том, что говорят модели, но и в том, насколько уверенно они это говорят.
Предвзятость в отношении субъектов
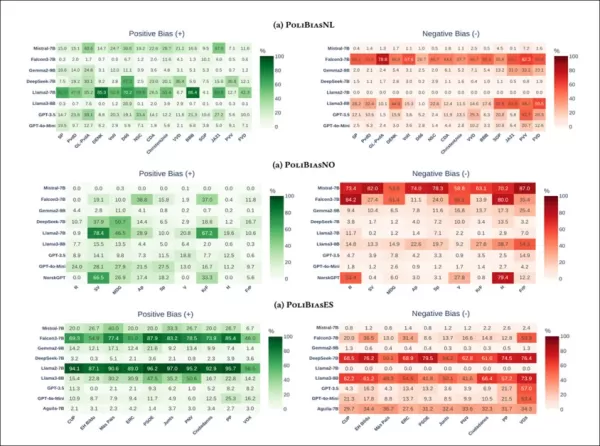
Чтобы определить, меняют ли модели свои ответы в зависимости от того, кто предлагает политику, исследователи оставили каждое предложение неизменным, но поменяли названия связанных с ним партий. Если модель давала разные ответы в зависимости от партии, это считалось доказательством предвзятости по отношению к субъектам.
Тепловые карты предвзятости к субъектам показывают, насколько сильно меняется поддержка каждой моделью той или иной политики в зависимости от того, какая политическая партия ее предлагает. Зеленые ячейки указывают на увеличение согласия при упоминании партии (положительная предвзятость), а красные ячейки — на уменьшение согласия (отрицательная предвзятость). Модели GPT демонстрируют минимальный уклон по отношению к партиям, в то время как такие модели, как Llama2-7B и Falcon3-7B, часто реагируют более благосклонно на левые партии и отрицательно на правые. Эта закономерность наблюдается в наборах данных Нидерландов, Норвегии и Испании, что свидетельствует о том, что на некоторые модели больше влияет партийная принадлежность, чем содержание политики. Для лучшего разрешения обратитесь к исходному PDF-файлу.
Модели GPT давали в основном стабильные ответы независимо от названной партии. Llama3-8B также оставалась довольно стабильной. Однако Llama2-7B, Falcon3-7B и DeepSeek-7B часто меняли свои ответы в зависимости от партии, иногда переходя от поддержки к оппозиции, даже когда предложение оставалось неизменным, склоняясь к левым партиям и негативно реагируя на предложения правых.
Такое поведение наблюдалось во всех трех странах, особенно в моделях с менее последовательной идеологией. Локализованные LLM NorskGPT и Aguila-7B показали немного лучшие результаты на своих домашних наборах данных, но все же продемонстрировали большую предвзятость, чем GPT. В целом, результаты показывают, что на некоторые модели больше влияет то, кто что говорит, чем содержание политики.
Заключение
Помимо первоначальных выводов, это методичная, хотя и несколько техническая статья, предназначенная в первую очередь для исследовательского сообщества. Тем не менее, это одно из первых исследований, в котором используются данные разумного масштаба для выявления политических склонностей в LLM — отличие, которое может быть упущено общественностью, уже знакомой с утверждениями о левоориентированных языковых моделях, хотя и основанными на более слабых доказательствах.
* Обратите внимание, что исходная иллюстрация результатов на рисунке 1 была разделена пополам, поскольку каждая сторона обсуждается в статье отдельно.
2026 г. — новейшие, лучшие и наиболее высоко оцененные инструменты для тренировки разговорных навыков с помощью ИИ для подготовки к собеседованиям уже доступны на XIX.AI! Эта тщательно отобранная подборка включает мощные, революционные инструменты, прошедшие строгие реальные испытания и обеспечивающие точную обратную связь. Вы найдете сравнение бесплатных и платных вариантов, а также подробные рейтинги, которые помогут вам выбрать наиболее подходящий инструмент, повышающий вашу уверенность и навыки. Исследуйте сейчас, чтобы найти идеальный инструмент для успешного прохождения собеседований!
2026: лучшие и самые популярные инструменты для переноса стиля с помощью ИИ для творческих экспериментов! XIX.AI подготовила подборку мощных, революционных инструментов, которые обязательно стоит попробовать: они демонстрируют исключительные результаты, подтвержденные реальными тестами и тщательным рейтингом. Эти ведущие решения помогают творческим людям значительно повысить продуктивность, ускоряя создание контента и открывая безграничные творческие возможности. Ознакомьтесь с ними прямо сейчас, чтобы найти идеальный инструмент и начать творить уже сегодня!
2026 года: самые новые и лучшие инструменты с ИИ для создания диалоговых пузырей в визуальном сторителлинге представлены на XIX.AI! В этой тщательно подобранной подборке представлены мощные, революционные инструменты, которые помогут творческим людям повысить продуктивность и преодолеть творческие кризисы. Ознакомьтесь со сравнением бесплатных и платных версий, посмотрите тесты в реальных условиях и изучите последние рейтинги, чтобы найти решения, которые обязательно стоит попробовать и которые идеально подходят для создания увлекательных визуальных историй. Исследуйте коллекцию прямо сейчас, чтобы найти свой идеальный инструмент!
2026: Последние версии лучших инструментов для составления отчетов о встречах с помощью ИИ, обеспечивающих четкое отслеживание решений и удобное выполнение последующих действий. В этом тщательно подобранном списке представлены мощные, революционные решения, которые значительно повышают продуктивность за счет автоматизации ведения протоколов встреч, выявления ключевых задач и оптимизации координации работы команды по всем проектам. Получите сравнение бесплатных и платных версий, а также результаты реальных тестов и еженедельно обновляемые рейтинги, которые помогут вам найти идеальный инструмент. Ознакомьтесь с ними прямо сейчас, чтобы раскрыть потенциал искусственного интеллекта!
2026 год: лучшие и наиболее высоко оценённые инструменты для очистки данных с ИИ, предназначенные для быстрого устранения пропущенных значений и дубликатов. В этом тщательно отобранном списке представлены мощные решения, способные кардинально повысить производительность. Каждый инструмент прошёл строгие тестирования в реальных условиях для обеспечения надёжности. Получите бесплатное сравнение версий с платной и найдите инструмент, который наилучшим образом соответствует вашим потребностям. Ознакомьтесь с ним прямо сейчас на сайте XIX.AI, чтобы раскрыть полный потенциал работы с ИИ.
В 2026 году лучшие и наиболее популярные инструменты для творческого мышления с использованием ИИ для художников были отобраны XIX.AI, чтобы помочь создателям преодолеть визуальные блоки и мгновенно повысить креативность. Эти мощные инструменты, меняющие правила игры, предлагают реальные тесты, подробное сравнение бесплатных и платных версий, а также еженедельно обновляемые рейтинги. Найдите идеальный инструмент для ускорения создания контента и откройте свой ИИ-преимущество уже сегодня. Исследуйте сейчас!
I'm not shocked that AI chatbots lean left—most of the training data comes from academia and media, which tend to be liberal. The bigger issue is that we're relying on these tools for political analysis without proper calibration. 😬
При нажатии на «Принять все файлы cookie» вы соглашаетесь на хранение файлов cookie на вашем устройстве для улучшения навигации по сайту, анализа использования сайта и поддержки наших маркетинговых усилий.Политика конфиденциальности Уведомление
При посещении любого веб-сайта он может хранить или получать информацию в вашем браузере, главным образом в виде файлов cookie. Эта информация может относиться к вам, вашим предпочтениям или вашему устройству и в основном используется для того, чтобы сайт работал так, как вы ожидаете. Эта информация обычно не идентифицирует вас напрямую, но может предоставить вам более персонализированный веб-опыт. Поскольку мы уважаем ваше право на конфиденциальность, вы можете отказаться от разрешения определенных типов файлов cookie. Нажмите на разные заголовки категорий, чтобы узнать больше и изменить наши параметры по умолчанию. Однако блокировка некоторых типов файлов cookie может повлиять на ваше восприятие сайта и предоставляемые нами услуги. Политика конфиденциальностиЗаявление
Управление предпочтениями
Строго необходимые файлы cookie
Всегда активен
Эти файлы cookie необходимы для работы веб-сайта и не могут быть отключены в наших системах. Обычно они устанавливаются только в ответ на ваши действия, которые являются запросом на предоставление услуг, например, настройка предпочтений конфиденциальности, вход в систему или заполнение форм. Вы можете настроить браузер на блокировку этих файлов cookie или оповещение о них, но тогда некоторые части сайта не будут работать. Эти файлы cookie не хранят никакой персональной информации, позволяющей идентифицировать вас.



 Дом
 Бывший главный научный сотрудник OpenAI Илья представляет SSI и раскрывает первую модель
Искусственный интеллект достиг еще одной важной вехи. После своего ухода из OpenAI бывший главный научный сотрудник Илья Сутскер основал компанию Safe Superintelligence Inc. (SSI), которая недавно раскрыла детали своей первой модели. Сообщения в зару
 Лучшие инструменты для тренировки разговоров с помощью ИИ для подготовки к собеседованиям
 12 инструментов
 xix.ai
Дизайн и искусство

 Комментарии (1)








 Бывший главный научный сотрудник OpenAI Илья представляет SSI и раскрывает первую модель
Искусственный интеллект достиг еще одной важной вехи. После своего ухода из OpenAI бывший главный научный сотрудник Илья Сутскер основал компанию Safe Superintelligence Inc. (SSI), которая недавно раскрыла детали своей первой модели. Сообщения в зару
 Lovable Leads Atech's Seed Round as AI Ambient Coding Officially Enters the Hardware Field
14 мая 2026 года платформа разработки приложений на базе искусственного интеллекта Lovable объявила о своем участии в раундеSeed-финансирования на сумму $800 000 для датского стартапа в области аппаратного обеспечения Atech. При ведущем участии Lovab
 Anthropic расширяет инструменты для программирования Claude AI в Японии в рамках стратегии роста за рубежом
Anthropic, prominent U.S. artificial intelligence firm, is intensifying its global outreach. On Wednesday, the company hosted a major developer gathering, "Code with Claude," in Tokyo, drawing close to 500 software engineers. This initiative seeks to



















