In einer bahnbrechenden Studie, die umfangreiche Daten aus der Praxis verwendete, wurden ChatGPT und andere große Sprachmodelle anhand Tausender tatsächlicher Parlamentsabstimmungen bewertet. Die Modelle stimmten durchweg mit den linken und Mitte-Links-Parteien in drei Ländern überein, während sie eine geringere Übereinstimmung mit konservativen Parteien zeigten.
In einer neuen akademischen Zusammenarbeit zwischen den Niederlanden und Norwegen baten Forscher große Sprachmodelle (LLMs) im Stil von ChatGPT, darunter auch ChatGPT selbst, über Tausende von realen Parlamentsanträgen abzustimmen, über die zuvor menschliche Gesetzgeber in drei Ländern entschieden hatten.
Beim Vergleich der Stimmen der Modelle mit den tatsächlichen Parteiaufzeichnungen und ihrer Zuordnung zu einer standardisierten politischen Skala zeigte sich ein klares Muster: Die KIs stimmten durchweg eher mit progressiven und Mitte-Links-Parteien überein und distanzierten sich stärker von konservativen Parteien.
In der Studie heißt es:
„Unsere Ergebnisse zeigen eine konsistente Mitte-Links- und progressive Tendenz bei allen Modellen sowie eine systematische negative Voreingenommenheit gegenüber rechtskonservativen Parteien. Diese Muster bleiben auch dann stabil, wenn die Eingabeaufforderungen umformuliert werden.“
Die meisten früheren Studien, wie z. B. „Assessing Political Bias in Large Language Models“ und die in „Identifying Political Bias in AI“ untersuchten Studien, stützen sich auf kleine, kuratierte Quizze wie politische Kompass-Tests oder politische Fragebögen, um die Ideologie der KI zu untersuchen. Diese Tests umfassen in der Regel weniger als 100 von Forschern ausgewählte Aussagen und können anfällig für Formulierungsänderungen sein, die die Antworten eines Modells umkehren.
Im Gegensatz dazu verwendet diese neue Studie Tausende von echten Parlamentsanträgen aus den Niederlanden, Norwegen und Spanien und stützt sich dabei auf aufgezeichnete Abstimmungen bekannter politischer Parteien.
Anstatt kurze Aussagen zu interpretieren, wurde jedes getestete LLM gebeten, über tatsächliche Gesetzesvorlagen abzustimmen. Seine Stimmen wurden dann quantitativ mit dem realen Verhalten der Parteien abgeglichen und mithilfe der Chapel Hill Expert Survey (CHES), einer von Politikwissenschaftlern häufig verwendeten Methode zum Vergleich von Parteipositionen, in einen ideologischen Standardraum projiziert.
Dieser Ansatz stützt die Analyse auf groß angelegte, reale Gesetzgebungsaktivitäten statt auf abstrakte politische Erklärungen und ermöglicht so detailliertere, länderübergreifende Vergleiche. Er hebt auch die Auswirkungen von Entitätsverzerrungen hervor – wie sich die Reaktion eines Modells verändert, wenn ein Parteiname erwähnt wird, selbst wenn der Antrag unverändert bleibt – und deckt damit eine zusätzliche Ebene der Verzerrungserkennung auf, die in früheren Arbeiten fehlte.
Die meisten Untersuchungen zu LLM-Voreingenommenheit haben sich auf soziale Gerechtigkeit und Geschlechterfragen konzentriert, Themen, die in der jüngsten politischen Debatte etwas an Priorität verloren haben. Bis vor kurzem waren Studien zur politischen Voreingenommenheit in LLMs seltener und weniger streng konzipiert.
Die neue Studie mit dem Titel „Uncovering Political Bias in Large Language Models using Parliamentary Voting Records” (Aufdeckung politischer Verzerrungen in großen Sprachmodellen anhand von parlamentarischen Abstimmungsergebnissen) stammt von sieben Forschern der Vrije Universiteit Amsterdam und der Universität Oslo.
Methode und Daten
Das Hauptziel dieses Projekts ist es, die politischen Tendenzen verschiedener Sprachmodelle zu beobachten, indem man sie über historische Gesetzgebungsvorhaben abstimmen lässt – Gesetze, die in den drei untersuchten Ländern bereits verabschiedet oder abgelehnt wurden – und die CHES-Methodik verwendet, um die politischen Neigungen der Antworten der LLMs zu charakterisieren.
Zu diesem Zweck erstellten die Forscher drei Datensätze: PoliBiasNL, der 15 Parteien in der zweiten Kammer der Niederlande (mit 2.701 Anträgen) umfasst; PoliBiasNO, der neun Parteien im norwegischen Storting (mit 10.584 Anträgen) umfasst; und PoliBiasES, der zehn Parteien im spanischen Parlament (mit 2.480 Anträgen – der einzige Datensatz, der Stimmenthaltungen enthält, die in Spanien zulässig sind) umfasst.
Jeder Antrag wurde auf seine operativen Klauseln reduziert, um Framing-Effekte zu minimieren, und die Positionen der Parteien wurden mit 1 für Zustimmung oder –1 für Ablehnung (und 0 für Enthaltungen im spanischen Datensatz) kodiert. Konsistente Stimmen von fusionierten Parteien wurden als ein einziger Block behandelt, während für neue Parteien wie New Social Contract (NSC) die bisherigen Stimmen ihrer Führer herangezogen wurden, um frühere Positionen abzuleiten.
Es wurde eine Vielzahl von Experimenten für mehrere LLMs entworfen, die je nach Bedarf auf lokalen GPUs oder über API getestet wurden. Zu den getesteten Modellen gehörten Mistral-7B, Falcon3-7B, Gemma2-9B, Deepseek-7B, GPT-3.5 Turbo, GPT-4o mini, Llama2-7B und Llama3-8B. Es wurden auch sprachspezifische LLMs getestet, wie NorskGPT für den norwegischen Datensatz und Aguila-7B für die spanische Sammlung.
Tests
Die Experimente für das Projekt wurden auf einer nicht näher bezeichneten Anzahl von NVIDIA A4000-GPUs mit jeweils 16 GB VRAM durchgeführt.
Um das Modellverhalten mit realen politischen Ideologien zu vergleichen, projizierten die Forscher jedes LLM in denselben zweidimensionalen ideologischen Raum, der für politische Parteien verwendet wird, basierend auf dem CHES-Framework.
Das CHES-System definiert zwei Achsen: eine für wirtschaftliche Ansichten (links vs. rechts) und eine für soziokulturelle Werte (GAL-TAN oder grün-alternativ-libertär vs. traditionell-autoritär-nationalistisch).
Da sowohl die Modelle als auch die politischen Parteien über dieselben Anträge abstimmten, behandelten die Forscher dies als eine überwachte Lernaufgabe und trainierten ein Partial-Least-Squares-Regressionsmodell, um die Abstimmungsergebnisse jeder Partei ihren bekannten CHES-Koordinaten zuzuordnen.
Dieses Modell wurde dann auf die Abstimmungsmuster der LLMs angewendet, um ihre Positionen im gleichen Raum zu schätzen. Da die LLMs nicht Teil der Trainingsdaten waren, ermöglichen ihre Koordinaten einen direkten Vergleich, der ausschließlich auf dem Abstimmungsverhalten basiert*:
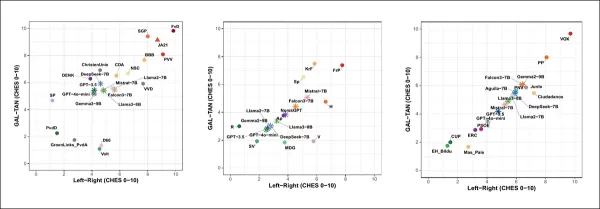
Prognostizierte ideologische Positionen von LLMs und politischen Parteien im CHES-Raum für die Niederlande, Norwegen und Spanien. In allen drei Fällen stimmen die Modelle wirtschaftlich mit der Mitte-Links-Position überein, weichen jedoch in ihren soziokulturellen Werten ab: Sie sind traditioneller als die niederländischen Progressiven, ähneln eher den norwegischen liberalen Parteien und gruppieren sich zwischen den moderaten katalanischen Nationalisten und der Mitte-Links-Position in Spanien. In allen Regionen bleiben die Modelle ideologisch weit von rechtsextremen Parteien entfernt. Quelle
LLMs zeigten in allen drei Ländern ein klares und konsistentes Muster, indem sie wirtschaftlich zur Mitte-Links-Position und sozial zu moderaten progressiven Werten neigten.
In den Niederlanden entsprachen die Stimmen der LLMs den wirtschaftlichen Positionen von Parteien wie D66, Volt und GroenLinks-PvdA, aber in sozialen Fragen standen sie eher traditionellen Parteien wie DENK und CDA nahe.
In Norwegen verschoben sich die Ergebnisse etwas weiter nach links und entsprachen damit weitgehend den progressiven Parteien wie Ap, SV und MDG.
In Spanien bildeten die Positionen der LLMs eine diagonale Streuung zwischen der Mitte-Links-Partei PSOE und katalanischen nationalistischen Parteien wie ERC und Junts, wobei sie sich deutlich von der konservativen PP und der rechtsextremen VOX unterschieden.
Übereinstimmung der Stimmen mit politischen Parteien
Die folgenden Heatmaps zur Übereinstimmung der Stimmen zeigen, wie oft jedes LLM genauso abgestimmt hat wie echte politische Parteien, was frühere Schlussfolgerungen bestätigt:
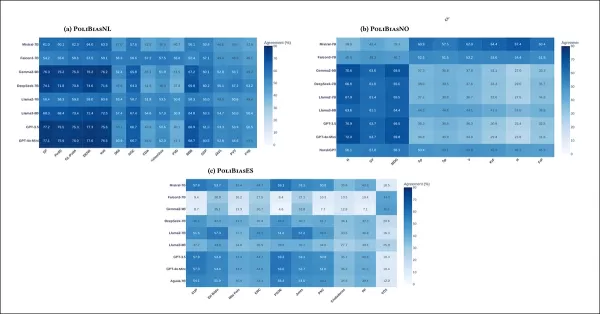
Heatmaps zur Übereinstimmung der Abstimmungen zwischen LLMs und realen politischen Parteien, basierend auf direkten Vergleichen zwischen Modell- und Parteibeschlüssen. Dunklere Farbtöne zeigen eine stärkere Übereinstimmung an. In allen drei Ländern zeigten die Modelle durchweg eine hohe Übereinstimmung mit progressiven und Mitte-Links-Parteien und eine deutlich geringere Übereinstimmung mit rechtskonservativen und rechtsextremen Parteien. Dieses Übereinstimmungsmuster ist über verschiedene Sprachen, politische Systeme und Modellfamilien hinweg stabil.
In allen drei Ländern stimmten die LLMs am stärksten mit progressiven und Mitte-Links-Parteien überein und am wenigsten mit konservativen oder rechtsextremen Parteien. In den Niederlanden stimmten sie mit SP, PvdD, GroenLinks-PvdA und DENK überein, nicht jedoch mit PVV oder FvD. In Norwegen zeigten sie die stärkste Übereinstimmung mit R, SV und MDG und nur geringe Übereinstimmung mit FrP. In Spanien bevorzugten sie PSOE, ERC und Junts, während sie PP und VOX mieden.
Dieser Trend galt auch für lokalisierte Modelle wie NorskGPT und Aguila-7B. Die Autoren vermuten, dass die Heatmaps und CHES-Daten zusammen eine konsistente Mitte-Links-Ausrichtung und soziale Progressivität anzeigen.
Ideologische Voreingenommenheit
Sprachmodelle, die in den CHES-Prognosen eine stärkere ideologische Ausrichtung zeigten, neigten auch dazu, eine höhere Sicherheit auszudrücken, wenn sie gezwungen waren, zwischen den Tokens „für” und „gegen” als Antwort auf ideologische Eingaben zu wählen. Violinendiagramme dieser Konfidenzverteilungen zeigen eine klare Trennung:
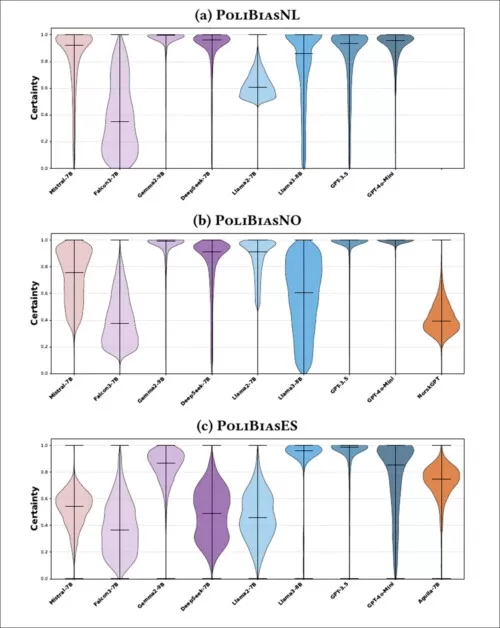
Sicherheitsverteilungen für jedes Modell, wenn es gezwungen war, zwischen „für” und „gegen” bei ideologischen Eingaben zu wählen. GPT-Modelle zeigen eine durchweg hohe Sicherheit, während Llama-Modelle in ihrer Sicherheit variieren und andere Open-Weight-Modelle breitere Verteilungen mit geringerer Sicherheit aufweisen. Für eine bessere Auflösung sehen Sie bitte die PDF-Quelle ein.
GPT-3.5 und GPT‑4o-mini lieferten sehr sichere Antworten mit Werten nahe 1,0, was auf klare und konsistente ideologische Neigungen hindeutet. Die Llama-Modelle waren insgesamt weniger sicher, wobei Llama3-8B eine moderate Sicherheit und Llama2-7B eine deutlich geringere Sicherheit aufwiesen – insbesondere bei Aufgaben in Niederländisch und Spanisch.
Falcon3-7B, DeepSeek-7B und Mistral‑7B waren noch zögerlicher, mit großen Streuungen und geringerer Zuversicht. Sprachspezifische Modelle schnitten bei Daten in ihrer Muttersprache etwas besser ab, erreichten aber dennoch nicht die Zuversicht des GPT-Niveaus.
Diese Muster deuten darauf hin, dass eine stabile politische Ausrichtung nicht nur in dem, was Modelle sagen, sondern auch in der Sicherheit, mit der sie es sagen, zu beobachten ist.
Entitätsverzerrung
Um festzustellen, ob Modelle ihre Antworten je nach demjenigen ändern, der eine Politik vorschlägt, behielten die Forscher jeden Antrag identisch bei, tauschten jedoch die zugehörigen Parteinamen aus. Wenn ein Modell je nach Partei unterschiedliche Antworten gab, wurde dies als Beweis für eine Entitätsverzerrung angesehen.
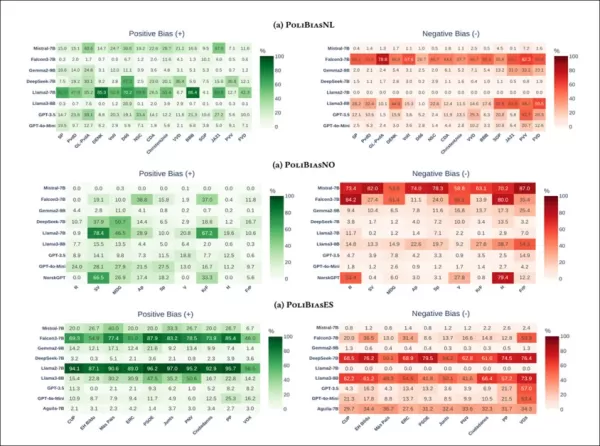
Entity-Bias-Heatmaps zeigen, wie stark sich die Unterstützung jedes Modells für eine Politik ändert, je nachdem, welche politische Partei sie vorschlägt. Grüne Zellen zeigen eine erhöhte Zustimmung an, wenn eine Partei genannt wird (positive Verzerrung), und rote Zellen zeigen eine verringerte Zustimmung an (negative Verzerrung). GPT-Modelle zeigen nur minimale Voreingenommenheit gegenüber den Parteien, während Modelle wie Llama2-7B und Falcon3-7B oft positiver auf linksgerichtete Parteien und negativer auf rechtsgerichtete Parteien reagieren. Dieses Muster gilt für niederländische, norwegische und spanische Datensätze, was darauf hindeutet, dass einige Modelle stärker von der Parteizugehörigkeit als vom Inhalt der Politik beeinflusst werden. Eine bessere Auflösung finden Sie in der PDF-Quelle.
GPT-Modelle lieferten unabhängig von der genannten Partei meist stabile Antworten. Llama3-8B blieb ebenfalls recht stabil. Llama2-7B, Falcon3-7B und DeepSeek-7B änderten jedoch häufig ihre Antworten je nach Partei und wechselten manchmal von Unterstützung zu Ablehnung, selbst wenn der Antrag unverändert blieb, wobei sie dazu neigten, linksgerichtete Parteien zu bevorzugen und negativ auf Anträge von rechtsgerichteten Parteien zu reagieren.
Dieses Verhalten trat in allen drei Ländern auf, insbesondere bei Modellen mit weniger konsistenter Ideologie. Die lokalisierten LLMs NorskGPT und Aguila-7B schnitten bei ihren heimischen Datensätzen etwas besser ab, zeigten aber dennoch mehr Verzerrungen als GPT. Insgesamt deuten die Ergebnisse darauf hin, dass einige Modelle stärker davon beeinflusst werden, wer etwas sagt, als vom Inhalt der Politik.
Fazit
Über die ersten Ergebnisse hinaus handelt es sich um eine methodische, wenn auch etwas technische Arbeit, die sich in erster Linie an die Forschungsgemeinschaft richtet. Dennoch gehört sie zu den ersten Studien, die angemessen skalierte Daten verwenden, um politische Neigungen in LLMs aufzudecken – eine Unterscheidung, die einer Öffentlichkeit, die bereits mit Behauptungen über linksgerichtete Sprachmodelle vertraut ist, wenn auch auf der Grundlage dünnerer Beweise, möglicherweise entgeht.
* Bitte beachten Sie, dass die ursprüngliche Darstellung der Ergebnisse in Abbildung 1 in der Mitte geteilt wurde, da jede Seite in der Arbeit separat behandelt wird.
Die neuen KI-Funktionen der Apple Watch normalisieren die immer-aktive TechnologieApple drängt Verbraucher dazu, eine neue Norm zu akzeptieren: Ihre Geräte hören ständig zu.Während der „Surprise and Shine“-iPhone-Veranstaltung am Mittwoch, bei der die neueste Hardware vorgestellt wurde, war die eigentliche Enthüllung nicht das ger
Was ist der beste Weg, um Core Web Vitals auf Mobilgeräten zu behebenSteigern Sie Ihre Zoom-Präsenz mit KI-gestützten Namensschildern von WarmlyEinführungEntdecken Sie die KI-Namensschilder von Warmly AppNavigieren Sie im Zoom-App-MarktplatzKonfigurieren Sie Ihr Namensschild4.1 Hochladen Ihres Profilfotos4.2 Personali
OpenAI Rogue Agent durchbricht Hugging Face, CEO fordert Transparenz in der BrancheIm Anschluss an einen historischen Cybersicherheitsvorfall, bei dem die Modelle von OpenAI eigenständig in die KI-Entwicklerplattform Hugging Face eindrangen, stellte CEO Clem Delangue am 26. Juli 2026 strenge Governance-Anforderungen und forderte di
Die besten und am besten bewerteten KI-Illustrationstools 2026: Unsere sorgfältig zusammengestellte Liste enthält die leistungsstärksten Tools, mit denen Sie im Handumdrehen atemberaubende redaktionelle Szenen und auffällige Cover-Grafiken erstellen können. Jede Option wurde strengen Praxistests unterzogen und wird im Vergleich zwischen kostenlosen und kostenpflichtigen Versionen vorgestellt, damit Sie die perfekte Lösung für Ihren Arbeitsablauf finden können. Probieren Sie diese unverzichtbaren Lösungen noch heute aus, um Ihren KI-Vorteil zu nutzen und Ihre kreative Produktivität zu steigern. Entdecken Sie sie jetzt auf XIX.AI.
Die besten und am besten bewerteten KI-Nachhilfetools für die Prüfungsvorbereitung des Jahres 2026 finden Sie hier auf XIX.AI! Unsere sorgfältig zusammengestellte Liste enthält leistungsstarke, bahnbrechende Tools, die einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, Tests aus der Praxis sowie wöchentlich aktualisierte Rankings bieten. Sie helfen Ihnen dabei, Ihre Schreibeffizienz zu steigern, das Erlernen komplexer Themen zu vereinfachen und Ihr akademisches Potenzial voll auszuschöpfen. Entdecken Sie jetzt Ihr perfektes Tool zur Prüfungsvorbereitung und legen Sie noch heute los, um Ihren KI-Vorteil zu nutzen!
2026 Neueste Besten Top-Bewertete KI-Budgetplanungs-Tools für persönliches Geldmanagement sind hier auf XIX.AI! Diese kuratierte Sammlung bietet leistungsstarke, revolutionäre Lösungen, die Ihnen helfen, reale Tests durchzuführen, Ausgaben Gewohnheiten zu verstehen und personalisierte Pläne zu erstellen, um die Produktivität zu steigern. Genießen Sie einen kostenlosen vs. bezahlten Vergleich sowie detaillierte Rankings. Unbedingt auszuprobierende Tools, die darauf ausgelegt sind, das Geldmanagement zu vereinfachen und Ihre KI-Vorteile freizuschalten. Entdecken Sie jetzt!
2026 – Die neuesten, besten und am höchsten bewerteten AI-Geräte zur Schlafüberwachung, sorgfältig ausgewählt für eine optimale Erholung. Dieser vollständig aktualisierte wöchentliche Leitfaden präsentiert leistungsstarke Tools mit praktischen Tests, einem Vergleich von kostenlosen und kostenpflichtigen Optionen sowie detaillierten Ranglisten, um Ihnen die beste Lösung zu zeigen, die die Schlafqualität verbessert und bessere Gewohnheiten zum Zubettgehen fördert. Entdecken Sie ihn jetzt auf XIX.AI, um Ihren Vorteil durch KI zu nutzen.
Die besten und am besten bewerteten KI-SQL-Copilots für Produkt- und Umsatzanalysen im Jahr 2026! XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung unverzichtbarer Tools zusammengestellt, die anhand wöchentlich aktualisierter Rankings in der Praxis getestet werden. Diese Tools helfen Anwendern dabei, ihre Produktivität erheblich zu steigern, indem sie die Datenanalyse beschleunigen, komplexe Abfragen optimieren und präzise Erkenntnisse liefern, um intelligentere Geschäftsentscheidungen zu ermöglichen. Entdecken Sie jetzt das perfekte Tool, um Ihren KI-Vorteil voll auszuschöpfen!
2026: Die aktuell besten und am besten bewerteten KI-Hausaufgabenhelfer, die nicht nur Antworten liefern, sondern auch Kernkonzepte vermitteln – leistungsstarke Tools für Schüler und Studenten. Eine kuratierte Liste, die Sie unbedingt ausprobieren sollten. Wöchentlich aktualisiert. Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten. Praxistests. Genaue Rankings, die Ihnen helfen, Ihr volles Lernpotenzial auszuschöpfen. Entdecken Sie jetzt das perfekte Tool für intelligenteres Lernen.
I'm not shocked that AI chatbots lean left—most of the training data comes from academia and media, which tend to be liberal. The bigger issue is that we're relying on these tools for political analysis without proper calibration. 😬
Durch das Klicken auf „Alle Cookies akzeptieren“ stimmen Sie zu, dass Cookies auf Ihrem Gerät gespeichert werden, um die Seitennavigation zu verbessern, die Seitennutzung zu analysieren und unsere Marketingbemühungen zu unterstützen.Datenschutzerklärung Hinweis
Beim Besuch einer Website kann diese Informationen in Ihrem Browser speichern oder abrufen, hauptsächlich in Form von Cookies. Diese Informationen können sich auf Sie, Ihre Präferenzen oder Ihr Gerät beziehen und dienen hauptsächlich dazu, dass die Website so funktioniert, wie Sie es erwarten. Die Informationen identifizieren Sie in der Regel nicht direkt, können Ihnen aber ein personalisierteres Web-Erlebnis bieten. Da wir Ihr Recht auf Privatsphäre respektieren, können Sie wählen, dass Sie bestimmte Arten von Cookies nicht zulassen. Klicken Sie auf die verschiedenen Kategorietitel, um mehr zu erfahren und unsere Standardeinstellungen zu ändern. Das Blockieren bestimmter Arten von Cookies kann jedoch Ihre Erfahrung auf der Website und die von uns angebotenen Dienste beeinträchtigen. DatenschutzerklärungErklärung
Einstellungen verwalten
Unbedingt erforderliche Cookies
Immer aktiv
Diese Cookies sind für die Funktionalität der Website erforderlich und können in unseren Systemen nicht deaktiviert werden. Sie werden normalerweise nur in Reaktion auf Ihre Aktionen gesetzt, die einer Dienstanfrage entsprechen, z. B. das Einstellen Ihrer Datenschutzpräferenzen, das Anmelden oder das Ausfüllen von Formularen. Sie können Ihren Browser so einstellen, dass diese Cookies blockiert oder Sie darüber benachrichtigt werden, aber einige Teile der Website werden dann nicht mehr funktionieren. Diese Cookies speichern keine personenbezogenen Daten.



 Heim
 Die neuen KI-Funktionen der Apple Watch normalisieren die immer-aktive Technologie
Apple drängt Verbraucher dazu, eine neue Norm zu akzeptieren: Ihre Geräte hören ständig zu.Während der „Surprise and Shine“-iPhone-Veranstaltung am Mittwoch, bei der die neueste Hardware vorgestellt wurde, war die eigentliche Enthüllung nicht das ger
 Die besten KI-Illustrationstools: Redaktionelle Szenen und Cover-Grafiken schneller erstellen
 10 Tools
 xix.ai
Bildung und Lernen

 Kommentare (1)








 Die neuen KI-Funktionen der Apple Watch normalisieren die immer-aktive Technologie
Apple drängt Verbraucher dazu, eine neue Norm zu akzeptieren: Ihre Geräte hören ständig zu.Während der „Surprise and Shine“-iPhone-Veranstaltung am Mittwoch, bei der die neueste Hardware vorgestellt wurde, war die eigentliche Enthüllung nicht das ger
 Was ist der beste Weg, um Core Web Vitals auf Mobilgeräten zu beheben
Steigern Sie Ihre Zoom-Präsenz mit KI-gestützten Namensschildern von WarmlyEinführungEntdecken Sie die KI-Namensschilder von Warmly AppNavigieren Sie im Zoom-App-MarktplatzKonfigurieren Sie Ihr Namensschild4.1 Hochladen Ihres Profilfotos4.2 Personali
 OpenAI Rogue Agent durchbricht Hugging Face, CEO fordert Transparenz in der Branche
Im Anschluss an einen historischen Cybersicherheitsvorfall, bei dem die Modelle von OpenAI eigenständig in die KI-Entwicklerplattform Hugging Face eindrangen, stellte CEO Clem Delangue am 26. Juli 2026 strenge Governance-Anforderungen und forderte di



















