


 Lar
Grandes editoras processam o Google por causa de dados de treinamento de IA
Editoras e autores entraram com uma ação coletiva contra o Google, alegando que a empresa utilizou material protegido por direitos autorais para treinar sua IA Gemini.
Os autores da ação, entre os quais Hachette, Cengage, Elsevier, Scott Turow e S.C.R.I.B.E., alegam que o Google alterou dados de direitos autorais para ocultar que o Gemini foi treinado com conteúdo não autorizado.
Este caso se soma a inúmeras ações judiciais movidas por criadores contra empresas de IA como Google, Meta, OpenAI e Anthropic.
Embora a maioria dos casos ainda esteja pendente, duas decisões judiciais na Califórnia foram favoráveis às empresas de IA, considerando o uso de dados de treinamento como uso justo sob leis de direitos autorais desatualizadas.
A Anthropic enfrentou uma multa de US$ 1,5 bilhão por treinamento não autorizado, a maior da história dos direitos autorais nos EUA. Embora muitos escritores tivessem direito a indenizações, vários autores rejeitaram os acordos para prosseguir com outras ações judiciais.
As decisões da Califórnia podem não ditar os resultados em outros lugares, já que esta ação judicial foi movida em Nova York, permitindo que um juiz diferente profira a decisão.
Os autores da ação destacam um histórico complexo com o Google, observando que, embora o Google Livros forneça trechos limitados para pesquisa, ele nunca recebeu permissão para treinar o Gemini com livros completos ou arquivos enviados ao Google Play.
A ação judicial afirma que o Google copiou conscientemente obras sem autorização para o treinamento de IA.
Documentos internos do Google supostamente alertavam que o uso de livros protegidos por direitos autorais para treinamento poderia ser problemático e acarretar multas entre US$ 10 bilhões e US$ 100 bilhões.
O Google ainda não se pronunciou sobre as alegações.
Artigo relacionado
 O Google declara-se um grande jogador no design de IA
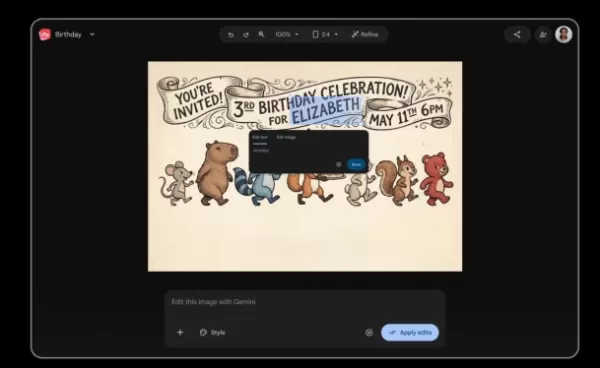
Na sua conferência anual I/O na terça-feira, a Google apresentou o Pics, uma nova ferramenta de design e criação de imagens impulsionada por IA para o Google Workspace. A empresa afirma que o aplicativo foi desenvolvido para ser acessível, atendendo
O Google lança recurso de detecção de chamadas falsas para proteger contra golpes de falsificação de identidade por meio de deepfakes gerados por IA
O Google anunciou nesta terça-feira que o Android está lançando um recurso de detecção de chamadas falsas para proteger contra golpes de falsificação de identidade por meio de deepfakes gerados por IA
A Frontier AI Labs se recusa a divulgar estratégias de contenção para modelos rebeldes
Pesquisas recentes indicam que muito poucos laboratórios líderes em IA publicaram ou demonstraram planos de resposta para contenção. Um plano de contenção define os procedimentos a serem seguidos quan
Recomendações de tópicos especiais relacionados
escrita
 Os melhores geradores de esboços com IA para artigos longos de SEO, resumos e páginas-pilar
Os melhores e mais bem avaliados geradores de esboços com IA de 2026 para artigos longos de SEO, resumos e páginas-pilar. A XIX.AI seleciona uma coleção poderosa e revolucionária, que passa por testes práticos atualizados semanalmente para oferecer ferramentas imperdíveis, perfeitas para aumentar a eficiência na redação, otimizar a criação de conteúdo e potencializar sua vantagem com a IA. Explore agora para descobrir a ferramenta perfeita para obter os melhores resultados de SEO.
 11 ferramentas
 xix.ai
Assistente de Reunião
Assistentes de IA para conversão de voz em atas: transforme as conversas da equipe em notas organizadas
Guia de 2026 com os melhores e mais bem avaliados assistentes de IA para conversas de voz em transcrições! A XIX.AI selecionou um conjunto de ferramentas extremamente poderosas e revolucionárias, projetadas para transformar instantaneamente qualquer conversa em equipe em anotações impecáveis e organizadas. Nossos rankings, atualizados semanalmente, abrangem opções gratuitas e pagas, além de testes práticos que demonstram sua eficácia em aumentar a produtividade em todos os cenários de trabalho. Imperdível para quem deseja aproveitar ao máximo o potencial da IA. Explore agora!
9 ferramentas
xix.ai
Criação de Animação
Os melhores geradores de sincronização labial com IA para cenas de diálogo
Os melhores e mais bem avaliados geradores de sincronização labial com IA para cenas de diálogo de 2026 já estão disponíveis no XIX.AI! Esta coleção cuidadosamente selecionada apresenta ferramentas poderosas e revolucionárias que proporcionam movimentos labiais sincronizados de forma impecável para qualquer roteiro, aumentando significativamente a eficiência da sua edição de vídeo. Aproveite uma comparação entre versões gratuitas e pagas, além de testes práticos e rankings atualizados semanalmente para ajudá-lo a encontrar a opção perfeita que você não pode deixar de experimentar. Explore agora para descobrir sua vantagem com a IA!
8 ferramentas
xix.ai
Incitar
Otimizadores de prompts de IA: refine as instruções para obter uma melhor qualidade de saída
Os melhores otimizadores de prompts de IA de 2026, com as melhores avaliações, selecionados para garantir a máxima qualidade de saída! A XIX.AI oferece soluções poderosas e revolucionárias que ajudam você a refinar instruções sem esforço, aumentar a eficiência na redação e obter resultados de maior qualidade sempre. Veja uma comparação entre as versões gratuita e paga, além de testes práticos e rankings atualizados semanalmente. Explore agora para descobrir sua ferramenta perfeita e aproveitar ao máximo sua vantagem com a IA!
16 ferramentas
xix.ai
Criação de Animação
Ferramentas de Movimento do Runway AI para Storyboards de Anúncios, Cenas de Personagens e Protótipos Visuais
2026 Últimas Melhores Ferramentas de Movimento por IA para Passarela Opções poderosas e transformadoras, cuidadosamente selecionadas e de alta avaliação, para criar storyboards de anúncios, cenas de personagens e protótipos visuais por meio de testes do mundo real. Rankings semanais atualizados comparando opções gratuitas e pagas. Ajude você a aumentar significativamente a produtividade. Explore agora.
9 ferramentas
xix.ai
Pesquisa Acadêmica
Ferramentas de descoberta de conjuntos de dados de IA para projetos acadêmicos
As melhores e mais bem avaliadas ferramentas de 2026 para descoberta de conjuntos de dados de IA em projetos acadêmicos! A XIX.AI selecionou uma coleção poderosa e revolucionária de opções altamente confiáveis, todas submetidas a rigorosos testes práticos e atualizadas semanalmente. Você pode encontrar informações detalhadas comparativas entre versões gratuitas e pagas para ajudá-lo a escolher a ferramenta perfeita que aumentará a eficiência de sua pesquisa e proporcionará resultados da mais alta qualidade. Explore agora para descobrir sua vantagem em IA!
16 ferramentas
xix.ai

 Comentários (0)
Editoras e autores entraram com uma ação coletiva contra o Google, alegando que a empresa utilizou material protegido por direitos autorais para treinar sua IA Gemini.
Os autores da ação, entre os quais Hachette, Cengage, Elsevier, Scott Turow e S.C.R.I.B.E., alegam que o Google alterou dados de direitos autorais para ocultar que o Gemini foi treinado com conteúdo não autorizado.
Este caso se soma a inúmeras ações judiciais movidas por criadores contra empresas de IA como Google, Meta, OpenAI e Anthropic.
Embora a maioria dos casos ainda esteja pendente, duas decisões judiciais na Califórnia foram favoráveis às empresas de IA, considerando o uso de dados de treinamento como uso justo sob leis de direitos autorais desatualizadas.
A Anthropic enfrentou uma multa de US$ 1,5 bilhão por treinamento não autorizado, a maior da história dos direitos autorais nos EUA. Embora muitos escritores tivessem direito a indenizações, vários autores rejeitaram os acordos para prosseguir com outras ações judiciais.
As decisões da Califórnia podem não ditar os resultados em outros lugares, já que esta ação judicial foi movida em Nova York, permitindo que um juiz diferente profira a decisão.
Os autores da ação destacam um histórico complexo com o Google, observando que, embora o Google Livros forneça trechos limitados para pesquisa, ele nunca recebeu permissão para treinar o Gemini com livros completos ou arquivos enviados ao Google Play.
A ação judicial afirma que o Google copiou conscientemente obras sem autorização para o treinamento de IA.
Documentos internos do Google supostamente alertavam que o uso de livros protegidos por direitos autorais para treinamento poderia ser problemático e acarretar multas entre US$ 10 bilhões e US$ 100 bilhões.
O Google ainda não se pronunciou sobre as alegações.








 O Google declara-se um grande jogador no design de IA
Na sua conferência anual I/O na terça-feira, a Google apresentou o Pics, uma nova ferramenta de design e criação de imagens impulsionada por IA para o Google Workspace. A empresa afirma que o aplicativo foi desenvolvido para ser acessível, atendendo
 O Google lança recurso de detecção de chamadas falsas para proteger contra golpes de falsificação de identidade por meio de deepfakes gerados por IA
O Google anunciou nesta terça-feira que o Android está lançando um recurso de detecção de chamadas falsas para proteger contra golpes de falsificação de identidade por meio de deepfakes gerados por IA
 A Frontier AI Labs se recusa a divulgar estratégias de contenção para modelos rebeldes
Pesquisas recentes indicam que muito poucos laboratórios líderes em IA publicaram ou demonstraram planos de resposta para contenção. Um plano de contenção define os procedimentos a serem seguidos quan
Os melhores e mais bem avaliados geradores de esboços com IA de 2026 para artigos longos de SEO, resumos e páginas-pilar. A XIX.AI seleciona uma coleção poderosa e revolucionária, que passa por testes práticos atualizados semanalmente para oferecer ferramentas imperdíveis, perfeitas para aumentar a eficiência na redação, otimizar a criação de conteúdo e potencializar sua vantagem com a IA. Explore agora para descobrir a ferramenta perfeita para obter os melhores resultados de SEO.
11 ferramentas
xix.ai
Guia de 2026 com os melhores e mais bem avaliados assistentes de IA para conversas de voz em transcrições! A XIX.AI selecionou um conjunto de ferramentas extremamente poderosas e revolucionárias, projetadas para transformar instantaneamente qualquer conversa em equipe em anotações impecáveis e organizadas. Nossos rankings, atualizados semanalmente, abrangem opções gratuitas e pagas, além de testes práticos que demonstram sua eficácia em aumentar a produtividade em todos os cenários de trabalho. Imperdível para quem deseja aproveitar ao máximo o potencial da IA. Explore agora!
9 ferramentas
xix.ai
Os melhores e mais bem avaliados geradores de sincronização labial com IA para cenas de diálogo de 2026 já estão disponíveis no XIX.AI! Esta coleção cuidadosamente selecionada apresenta ferramentas poderosas e revolucionárias que proporcionam movimentos labiais sincronizados de forma impecável para qualquer roteiro, aumentando significativamente a eficiência da sua edição de vídeo. Aproveite uma comparação entre versões gratuitas e pagas, além de testes práticos e rankings atualizados semanalmente para ajudá-lo a encontrar a opção perfeita que você não pode deixar de experimentar. Explore agora para descobrir sua vantagem com a IA!
8 ferramentas
xix.ai
Os melhores otimizadores de prompts de IA de 2026, com as melhores avaliações, selecionados para garantir a máxima qualidade de saída! A XIX.AI oferece soluções poderosas e revolucionárias que ajudam você a refinar instruções sem esforço, aumentar a eficiência na redação e obter resultados de maior qualidade sempre. Veja uma comparação entre as versões gratuita e paga, além de testes práticos e rankings atualizados semanalmente. Explore agora para descobrir sua ferramenta perfeita e aproveitar ao máximo sua vantagem com a IA!
16 ferramentas
xix.ai
2026 Últimas Melhores Ferramentas de Movimento por IA para Passarela Opções poderosas e transformadoras, cuidadosamente selecionadas e de alta avaliação, para criar storyboards de anúncios, cenas de personagens e protótipos visuais por meio de testes do mundo real. Rankings semanais atualizados comparando opções gratuitas e pagas. Ajude você a aumentar significativamente a produtividade. Explore agora.
9 ferramentas
xix.ai
As melhores e mais bem avaliadas ferramentas de 2026 para descoberta de conjuntos de dados de IA em projetos acadêmicos! A XIX.AI selecionou uma coleção poderosa e revolucionária de opções altamente confiáveis, todas submetidas a rigorosos testes práticos e atualizadas semanalmente. Você pode encontrar informações detalhadas comparativas entre versões gratuitas e pagas para ajudá-lo a escolher a ferramenta perfeita que aumentará a eficiência de sua pesquisa e proporcionará resultados da mais alta qualidade. Explore agora para descobrir sua vantagem em IA!
16 ferramentas
xix.ai












