


 Lar
Lançamento do modelo preliminar do LFM2.5 DSpark: velocidade de inferência aumentada em 3,18 vezes
A Liquid AI e a Hugging Face lançaram oficialmente os checkpoints preliminares do modelo DSpark para a série LFM2.5, abrangendo o LFM2.5-1.2B-Instruct, o LFM2.5-2.6B e o LFM2.5-8B-A1B. Essa inovação introduz um novo caminho de decodificação especulativa que aumenta significativamente a taxa de processamento de inferência, ao mesmo tempo em que preserva a qualidade da saída.
Principais ganhos de desempenho e aplicações no mundo real
Testes no mundo real demonstram a impressionante aceleração do DSpark. Em GPUs, a taxa de processamento aumenta em até 3,18 vezes, enquanto dispositivos de borda apresentam melhorias de até 2,87 vezes.
Na inferência de agentes de borda, o LFM2.5-2.6B reduz a latência das chamadas de função em uma média de 57%. Testado em um MacBook Pro M4 Max, ele atinge velocidades de até 139 tokens por segundo, diminuindo a barreira para a implantação de agentes locais e proporcionando uma experiência do usuário que rivaliza com modelos proprietários na nuvem.
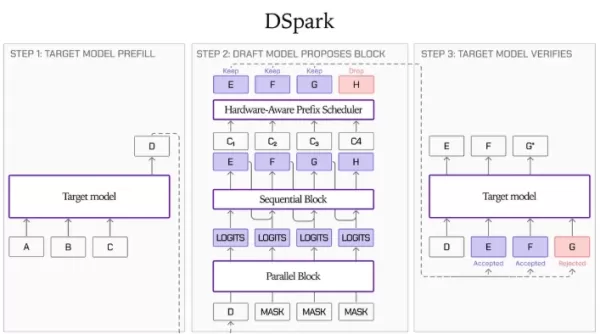
Entendendo a arquitetura e o mecanismo do DSpark
A inferência tradicional de LLM é limitada pela largura de banda da memória, já que a maior parte do tempo é gasta na transmissão de pesos da DRAM para a SRAM. A decodificação especulativa resolve isso usando um modelo preliminar leve para gerar tokens candidatos, que são então validados em uma única passagem de avanço pelo modelo de destino, distribuindo efetivamente os custos de carregamento de pesos.
O DSpark integra métodos existentes por meio de três componentes principais:
Rede de Backbone Paralela: semelhante ao DFlash, ela gera estados ocultos para todos os tokens preliminares em uma única passagem direta com base nas características de contexto do modelo-alvo.Cabeça Sequencial (Cabeça de Markov): Ao simular cadeias de Markov entre tokens adjacentes, ela reforça as dependências e melhora a taxa de aceitação para posições subsequentes.Validador de Agendamento de Confiança: Ele prevê a probabilidade de sobrevivência de cada token, descartando automaticamente sufixos de baixa confiança quando os custos de validação superam a economia.Para o treinamento, o modelo preliminar utiliza uma combinação diversificada de conjuntos de dados, incluindo SFT, bate-papo, código e chamadas de função. Após rigorosos estudos de ablação, a versão inicial apresenta uma arquitetura baseada exclusivamente em atenção, com 5 camadas e 9 blocos, mantendo os parâmetros em torno de 300 milhões.
Garantia de Qualidade e Integração ao Ecossistema
Devido à decodificação especulativa, a decodificação gananciosa aceita apenas tokens preliminares que correspondam perfeitamente à distribuição do modelo-alvo. Os tokens rejeitados são substituídos pela saída do modelo-alvo, garantindo que a sequência gerada corresponda à estrutura de decodificação gananciosa de referência, sem perda de precisão nos benchmarks.
No lançamento, o DSpark alcançou compatibilidade com as principais estruturas de inferência:
SGLang: Oferece suporte à execução em aceleradores por meio de integração dedicada e configurações de inicialização.llama.cpp: Oferece suporte oficial à compilação, permitindo que os usuários carreguem os pesos GGUF correspondentes e os arquivos do modelo preliminar por meio da linha de comando.
Artigo relacionado
 Por que a Abnormal AI fez uma parceria com a OpenAI no Daybreak
Michael Aiello, chefe de produtos de segurança cibernética da OpenAI | Crédito: Michael Aiello/LinkedInA Abnormal AI passa a integrar o programa Daybreak da OpenAI, e Mike Aiello afirma que a parceria
A Claw, da AI Agent Elements, conclui o desenvolvimento de um material supercondutor
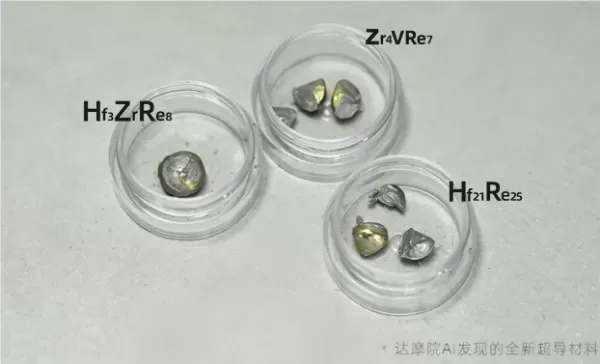
À medida que a inteligência artificial amplia os limites da exploração científica, um marco significativo foi alcançado. Em 3 de julho, a Alibaba DAMO Academy, em parceria com a Universidade Renmin da
Como verificar a classificação de SEO no Google Japão e Yahoo Japão de forma eficaz
Transforme uma Foto de Retrato em um Esboço de Harry PotterSumário:IntroduçãoConvertendo uma Fotografia em um EsboçoUsando o Filtro MínimoUma Técnica Diferente para Converter RetratosComeçandoBaixe a Imagem NecessáriaPrepare as CamadasDessat
Recomendações de tópicos especiais relacionados
código
 Ferramentas de Depuração do ChatGPT para Erros do Python, Logs da API e Triagem de Rastreamento de Pilha
As melhores ferramentas de depuração do ChatGPT de 2026 para erros do Python, registros da API e triagem de rastreamento de pilha estão disponíveis no XIX.AI. Esta lista curada de soluções mais bem avaliadas oferece uma comparação entre gratuito e pago, testes do mundo real e classificações detalhadas para ajudá-lo a encontrar a ferramenta mais poderosa que pode aumentar significativamente sua produtividade e ajudá-lo a resolver problemas técnicos complexos mais rapidamente. Explore agora para descobrir sua solução perfeita!
 9 ferramentas
 xix.ai
Conversão de texto para fala
Ferramentas de Narração por IA para Vídeos de Demonstração de Produtos
2026 Últimas Melhores Ferramentas de Narração por IA Mais Bem Avaliadas para Vídeos de Demonstração de Produtos estão aqui na XIX.AI! Esta lista selecionada apresenta opções poderosas e transformadoras que ajudam você a criar conteúdo de áudio de qualidade profissional rapidamente, aumentando significativamente sua eficiência na demonstração. Realizamos testes do mundo real e fornecemos uma comparação entre gratuito e pago, bem como classificações atualizadas semanalmente, para ajudá-lo a encontrar a opção perfeita. Explore agora para desbloquear sua vantagem com IA!
10 ferramentas
xix.ai
Negócios
Ferramentas de plano de negócios em IA para validação de startups
As melhores e mais recentes ferramentas de plano de negócios com IA para validação de startups em 2026! A XIX.AI selecionou uma lista das ferramentas mais bem avaliadas e revolucionárias, que passam por testes práticos para oferecer resultados precisos. Você encontrará uma comparação entre versões gratuitas e pagas, classificações detalhadas e informações fáceis de entender para ajudá-lo a escolher a solução perfeita e aumentar a taxa de sucesso da sua startup. Explore agora para descobrir sua vantagem em IA!
9 ferramentas
xix.ai
chatbot
Aplicativos de Chat com IA para Interpretação de Papéis e Prática de Conversação
2026 Últimas Melhores Aplicativos de Chat com IA para Interpretação de Papéis e Prática de Conversa! A XIX.AI seleciona uma lista de ferramentas poderosas altamente recomendadas, que passam por rigorosos testes no mundo real para oferecer resultados excepcionais. Você encontrará uma comparação detalhada entre as versões gratuita e paga, classificações abrangentes e insights sobre como esses aplicativos podem melhorar suas habilidades linguísticas e sua confiança na comunicação de forma eficaz. Explore agora para descobrir a ferramenta perfeita para sua prática!
10 ferramentas
xix.ai
projeto
As melhores ferramentas de wireframe com IA para equipes de produto
As melhores e mais bem avaliadas ferramentas de wireframe com IA para equipes de produto em 2026! Esta lista selecionada apresenta soluções poderosas e revolucionárias que aumentam significativamente a produtividade por meio de testes práticos e classificações rigorosas. Ela inclui uma comparação detalhada entre versões gratuitas e pagas para ajudar você a encontrar a opção ideal. A XIX.AI oferece insights de especialistas para orientar sua decisão. Explore agora para descobrir sua ferramenta ideal e aproveitar ao máximo as vantagens da IA no desenvolvimento de produtos!
8 ferramentas
xix.ai
Desenvolvimento de software
As melhores ferramentas de IA para DevOps no monitoramento de implantações
As melhores e mais bem avaliadas ferramentas de DevOps com IA para monitoramento de implantação de 2026 estão apresentadas aqui em nossa lista cuidadosamente selecionada. Essas ferramentas poderosas ajudam as equipes a aumentar significativamente a produtividade por meio de testes reais e classificações rigorosas. Confira uma comparação entre as versões gratuitas e pagas para encontrar a opção perfeita que atenda às suas necessidades. Explore agora para aproveitar ao máximo o poder da IA!
11 ferramentas
xix.ai

 Comentários (0)
A Liquid AI e a Hugging Face lançaram oficialmente os checkpoints preliminares do modelo DSpark para a série LFM2.5, abrangendo o LFM2.5-1.2B-Instruct, o LFM2.5-2.6B e o LFM2.5-8B-A1B. Essa inovação introduz um novo caminho de decodificação especulativa que aumenta significativamente a taxa de processamento de inferência, ao mesmo tempo em que preserva a qualidade da saída.
Principais ganhos de desempenho e aplicações no mundo real
Testes no mundo real demonstram a impressionante aceleração do DSpark. Em GPUs, a taxa de processamento aumenta em até 3,18 vezes, enquanto dispositivos de borda apresentam melhorias de até 2,87 vezes.
Na inferência de agentes de borda, o LFM2.5-2.6B reduz a latência das chamadas de função em uma média de 57%. Testado em um MacBook Pro M4 Max, ele atinge velocidades de até 139 tokens por segundo, diminuindo a barreira para a implantação de agentes locais e proporcionando uma experiência do usuário que rivaliza com modelos proprietários na nuvem.
Entendendo a arquitetura e o mecanismo do DSpark
A inferência tradicional de LLM é limitada pela largura de banda da memória, já que a maior parte do tempo é gasta na transmissão de pesos da DRAM para a SRAM. A decodificação especulativa resolve isso usando um modelo preliminar leve para gerar tokens candidatos, que são então validados em uma única passagem de avanço pelo modelo de destino, distribuindo efetivamente os custos de carregamento de pesos.
O DSpark integra métodos existentes por meio de três componentes principais:
Rede de Backbone Paralela: semelhante ao DFlash, ela gera estados ocultos para todos os tokens preliminares em uma única passagem direta com base nas características de contexto do modelo-alvo.Cabeça Sequencial (Cabeça de Markov): Ao simular cadeias de Markov entre tokens adjacentes, ela reforça as dependências e melhora a taxa de aceitação para posições subsequentes.Validador de Agendamento de Confiança: Ele prevê a probabilidade de sobrevivência de cada token, descartando automaticamente sufixos de baixa confiança quando os custos de validação superam a economia.Para o treinamento, o modelo preliminar utiliza uma combinação diversificada de conjuntos de dados, incluindo SFT, bate-papo, código e chamadas de função. Após rigorosos estudos de ablação, a versão inicial apresenta uma arquitetura baseada exclusivamente em atenção, com 5 camadas e 9 blocos, mantendo os parâmetros em torno de 300 milhões.
Garantia de Qualidade e Integração ao Ecossistema
Devido à decodificação especulativa, a decodificação gananciosa aceita apenas tokens preliminares que correspondam perfeitamente à distribuição do modelo-alvo. Os tokens rejeitados são substituídos pela saída do modelo-alvo, garantindo que a sequência gerada corresponda à estrutura de decodificação gananciosa de referência, sem perda de precisão nos benchmarks.
No lançamento, o DSpark alcançou compatibilidade com as principais estruturas de inferência:
SGLang: Oferece suporte à execução em aceleradores por meio de integração dedicada e configurações de inicialização.llama.cpp: Oferece suporte oficial à compilação, permitindo que os usuários carreguem os pesos GGUF correspondentes e os arquivos do modelo preliminar por meio da linha de comando.








 Por que a Abnormal AI fez uma parceria com a OpenAI no Daybreak
Michael Aiello, chefe de produtos de segurança cibernética da OpenAI | Crédito: Michael Aiello/LinkedInA Abnormal AI passa a integrar o programa Daybreak da OpenAI, e Mike Aiello afirma que a parceria
 A Claw, da AI Agent Elements, conclui o desenvolvimento de um material supercondutor
À medida que a inteligência artificial amplia os limites da exploração científica, um marco significativo foi alcançado. Em 3 de julho, a Alibaba DAMO Academy, em parceria com a Universidade Renmin da
 Como verificar a classificação de SEO no Google Japão e Yahoo Japão de forma eficaz
Transforme uma Foto de Retrato em um Esboço de Harry PotterSumário:IntroduçãoConvertendo uma Fotografia em um EsboçoUsando o Filtro MínimoUma Técnica Diferente para Converter RetratosComeçandoBaixe a Imagem NecessáriaPrepare as CamadasDessat
As melhores ferramentas de depuração do ChatGPT de 2026 para erros do Python, registros da API e triagem de rastreamento de pilha estão disponíveis no XIX.AI. Esta lista curada de soluções mais bem avaliadas oferece uma comparação entre gratuito e pago, testes do mundo real e classificações detalhadas para ajudá-lo a encontrar a ferramenta mais poderosa que pode aumentar significativamente sua produtividade e ajudá-lo a resolver problemas técnicos complexos mais rapidamente. Explore agora para descobrir sua solução perfeita!
9 ferramentas
xix.ai
2026 Últimas Melhores Ferramentas de Narração por IA Mais Bem Avaliadas para Vídeos de Demonstração de Produtos estão aqui na XIX.AI! Esta lista selecionada apresenta opções poderosas e transformadoras que ajudam você a criar conteúdo de áudio de qualidade profissional rapidamente, aumentando significativamente sua eficiência na demonstração. Realizamos testes do mundo real e fornecemos uma comparação entre gratuito e pago, bem como classificações atualizadas semanalmente, para ajudá-lo a encontrar a opção perfeita. Explore agora para desbloquear sua vantagem com IA!
10 ferramentas
xix.ai

As melhores e mais recentes ferramentas de plano de negócios com IA para validação de startups em 2026! A XIX.AI selecionou uma lista das ferramentas mais bem avaliadas e revolucionárias, que passam por testes práticos para oferecer resultados precisos. Você encontrará uma comparação entre versões gratuitas e pagas, classificações detalhadas e informações fáceis de entender para ajudá-lo a escolher a solução perfeita e aumentar a taxa de sucesso da sua startup. Explore agora para descobrir sua vantagem em IA!
9 ferramentas
xix.ai

2026 Últimas Melhores Aplicativos de Chat com IA para Interpretação de Papéis e Prática de Conversa! A XIX.AI seleciona uma lista de ferramentas poderosas altamente recomendadas, que passam por rigorosos testes no mundo real para oferecer resultados excepcionais. Você encontrará uma comparação detalhada entre as versões gratuita e paga, classificações abrangentes e insights sobre como esses aplicativos podem melhorar suas habilidades linguísticas e sua confiança na comunicação de forma eficaz. Explore agora para descobrir a ferramenta perfeita para sua prática!
10 ferramentas
xix.ai

As melhores e mais bem avaliadas ferramentas de wireframe com IA para equipes de produto em 2026! Esta lista selecionada apresenta soluções poderosas e revolucionárias que aumentam significativamente a produtividade por meio de testes práticos e classificações rigorosas. Ela inclui uma comparação detalhada entre versões gratuitas e pagas para ajudar você a encontrar a opção ideal. A XIX.AI oferece insights de especialistas para orientar sua decisão. Explore agora para descobrir sua ferramenta ideal e aproveitar ao máximo as vantagens da IA no desenvolvimento de produtos!
8 ferramentas
xix.ai
As melhores e mais bem avaliadas ferramentas de DevOps com IA para monitoramento de implantação de 2026 estão apresentadas aqui em nossa lista cuidadosamente selecionada. Essas ferramentas poderosas ajudam as equipes a aumentar significativamente a produtividade por meio de testes reais e classificações rigorosas. Confira uma comparação entre as versões gratuitas e pagas para encontrar a opção perfeita que atenda às suas necessidades. Explore agora para aproveitar ao máximo o poder da IA!
11 ferramentas
xix.ai












