


 Hogar
Se publica el modelo preliminar LFM2.5 DSpark: la velocidad de inferencia se ha multiplicado por 3,18
Liquid AI y Hugging Face han publicado oficialmente los puntos de control preliminares del modelo DSpark para la serie LFM2.5, que abarca los modelos LFM2.5-1.2B-Instruct, LFM2.5-2.6B y LFM2.5-8B-A1B. Esta innovación introduce una nueva ruta de decodificación especulativa que aumenta significativamente el rendimiento de la inferencia al tiempo que preserva la calidad de la salida.
Principales mejoras de rendimiento y aplicaciones en el mundo real
Las pruebas en el mundo real demuestran la impresionante aceleración de DSpark. En las GPU, el rendimiento se multiplica por 3,18, mientras que en los dispositivos periféricos se observan mejoras de hasta 2,87 veces.
En la inferencia de agentes periféricos, LFM2.5-2.6B reduce la latencia de las llamadas a funciones en un 57 % de media. Probado en un MacBook Pro M4 Max, alcanza velocidades de hasta 139 tokens por segundo, lo que reduce las barreras para el despliegue de agentes locales y ofrece una experiencia de usuario que rivaliza con los modelos en la nube propietarios.
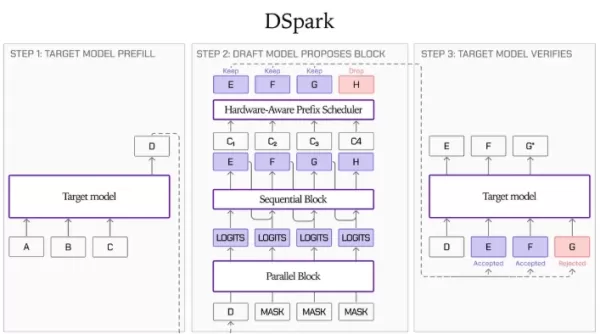
Comprender la arquitectura y el mecanismo de DSpark
La inferencia tradicional de los LLM se ve limitada por el ancho de banda de la memoria, ya que la mayor parte del tiempo se dedica a transferir los pesos de la DRAM a la SRAM. La decodificación especulativa resuelve este problema utilizando un modelo preliminar ligero para generar tokens candidatos, que luego son validados en una única pasada hacia adelante por el modelo de destino, distribuyendo de forma eficaz los costes de carga de los pesos.
DSpark integra los métodos existentes a través de tres componentes principales:
Red de columna vertebral paralela: al igual que DFlash, genera estados ocultos para todos los tokens preliminares en una sola pasada hacia adelante basándose en las características de contexto del modelo de destino.Cabeza secuencial (cabeza de Markov): Al simular cadenas de Markov entre tokens adyacentes, potencia las dependencias y mejora la tasa de aceptación para las posiciones posteriores.Validador de programación por confianza: predice la probabilidad de supervivencia de cada token, descartando automáticamente los sufijos de baja confianza cuando los costes de validación superan los ahorros.Para el entrenamiento, el modelo preliminar utiliza una combinación diversa de conjuntos de datos que incluyen SFT, chat, código y llamadas a funciones. Tras rigurosos estudios de ablación, la versión inicial presenta una arquitectura basada exclusivamente en atención con 5 capas y 9 bloques, manteniendo los parámetros en torno a los 300 millones.
Garantía de calidad e integración en el ecosistema
Debido a la decodificación especulativa, la decodificación codiciosa solo acepta tokens preliminares que coincidan perfectamente con la distribución del modelo de destino. Los tokens rechazados se sustituyen por la salida del modelo de destino, lo que garantiza que la secuencia generada coincida con la estructura de decodificación codiciosa de referencia sin pérdida de precisión en las pruebas comparativas.
En el momento de su lanzamiento, DSpark logró la compatibilidad con los principales marcos de inferencia:
SGLang: admite la ejecución en aceleradores mediante configuraciones de integración y de inicio específicas.llama.cpp: ofrece soporte oficial para la compilación, lo que permite a los usuarios cargar los pesos GGUF correspondientes y los archivos de modelos preliminares a través de la línea de comandos.
Artículo relacionado
 ¿Por qué Abnormal AI se asoció con OpenAI en «Daybreak»?
Michael Aiello, responsable de productos de ciberseguridad en OpenAI | Crédito: Michael Aiello/LinkedInAbnormal AI se une al programa Daybreak de OpenAI; según Mike Aiello, esta colaboración acelerará
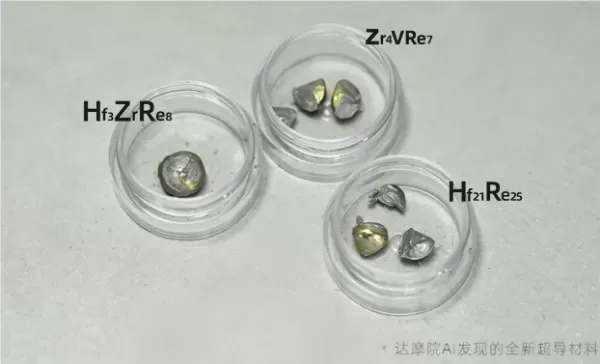
Claw, de AI Agent Elements, finaliza el desarrollo de un material superconductor
A medida que la inteligencia artificial amplía los límites de la exploración científica, se ha alcanzado un hito significativo. El 3 de julio, la Alibaba DAMO Academy, en colaboración con la Universid
Cómo verificar el posicionamiento SEO en Google Japón y Yahoo Japón de manera efectiva
Convierte una foto de retrato en un boceto de Harry PotterTabla de contenidos:IntroducciónConversión de una fotografía en un bocetoUso del filtro MínimoUna técnica diferente para convertir retratosPrimeros pasosDescarga la imagen requeridaPrep
Recomendaciones de temas especiales relacionados
código
 Herramientas de depuración de ChatGPT para errores de Python, registros de API y triaje de trazas de pila
2026 Últimas mejores herramientas de depuración de ChatGPT para errores de Python, registros de API y triaje de trazas de pila están aquí en XIX.AI. Esta lista curada de soluciones mejor valoradas ofrece una comparación entre versión gratuita y de pago, pruebas en el mundo real y clasificaciones detalladas para ayudarte a encontrar la herramienta más potente que puede aumentar significativamente tu productividad y ayudarte a resolver problemas técnicos complejos más rápido. ¡Explora ahora para descubrir tu solución perfecta!
 9 herramientas
 xix.ai
Texto a voz
Herramientas de voz artificial para vídeos de demostración de productos
2026 Últimas Mejores Herramientas de Voz IA Mejor Valoradas para Videos de Demostración de Productos están aquí en XIX.AI. Esta lista curada presenta opciones poderosas y transformadoras que te ayudan a crear contenido de audio de calidad profesional rápidamente, mejorando significativamente tu eficiencia en las demostraciones. Realizamos pruebas en el mundo real y proporcionamos una comparación entre versión gratuita y de pago, junto con clasificaciones actualizadas semanalmente para ayudarte a encontrar la opción perfecta. Explora ahora para desbloquear tu ventaja con IA.
10 herramientas
xix.ai
Negocio
Herramientas de IA para la elaboración de planes de negocio destinadas a la validación de startups
¡Las mejores herramientas de 2026 para elaborar planes de negocio basados en IA y validar tu startup! XIX.AI ha elaborado una lista de las herramientas más valoradas, potentes y revolucionarias, que se someten a pruebas en el mundo real para ofrecer resultados precisos. Encontrarás una comparación entre opciones gratuitas y de pago, clasificaciones detalladas e información clara y fácil de entender que te ayudará a elegir la solución perfecta y a aumentar las posibilidades de éxito de tu startup. ¡Échale un vistazo ahora y descubre tu ventaja competitiva en IA!
9 herramientas
xix.ai
chatbot
Aplicaciones de chat con IA para juegos de rol y práctica de conversación
¡Las mejores aplicaciones de chat con IA de 2026 para juegos de rol y práctica de conversación! XIX.AI selecciona una lista de herramientas recomendadas y poderosas que deben probarse, sometidas a rigurosas pruebas en el mundo real para ofrecer resultados excepcionales. Encontrarás una comparación detallada entre versiones gratuitas y de pago, clasificaciones completas e información sobre cómo estas aplicaciones pueden mejorar tus habilidades lingüísticas y tu confianza en la comunicación. ¡Explora ahora para descubrir la herramienta perfecta para tu práctica!
10 herramientas
xix.ai
diseño
Las mejores herramientas de IA para crear esquemas funcionales destinadas a equipos de producto
¡Las mejores herramientas de wireframes con IA mejor valoradas de 2026 para equipos de producto! Esta lista seleccionada presenta soluciones potentes y revolucionarias que aumentan significativamente la productividad gracias a pruebas en el mundo real y a rigurosas clasificaciones. Incluye una comparación detallada entre las versiones gratuitas y de pago para ayudarte a encontrar la opción perfecta. XIX.AI ofrece consejos de expertos para orientar tu decisión. ¡Explora ahora para descubrir tu herramienta perfecta y sacar el máximo partido a la IA en el desarrollo de productos!
8 herramientas
xix.ai
Desarrollo de software
Mejores herramientas de IA para DevOps en el monitoreo de despliegues
Aquí se presentan las mejores herramientas de DevOps con IA de 2026, más valoradas y de última generación, en nuestra lista cuidadosamente seleccionada. Estas potentes herramientas ayudan a los equipos a aumentar significativamente la productividad mediante pruebas en el mundo real y clasificaciones rigurosas. Obtén una comparación gratuita entre versiones gratuitas y de pago para encontrar la opción perfecta que se adapte a tus necesidades. Explora ahora para desbloquear tu ventaja con IA.
11 herramientas
xix.ai

 comentario (0)
0/500
Liquid AI y Hugging Face han publicado oficialmente los puntos de control preliminares del modelo DSpark para la serie LFM2.5, que abarca los modelos LFM2.5-1.2B-Instruct, LFM2.5-2.6B y LFM2.5-8B-A1B. Esta innovación introduce una nueva ruta de decodificación especulativa que aumenta significativamente el rendimiento de la inferencia al tiempo que preserva la calidad de la salida.
Principales mejoras de rendimiento y aplicaciones en el mundo real
Las pruebas en el mundo real demuestran la impresionante aceleración de DSpark. En las GPU, el rendimiento se multiplica por 3,18, mientras que en los dispositivos periféricos se observan mejoras de hasta 2,87 veces.
En la inferencia de agentes periféricos, LFM2.5-2.6B reduce la latencia de las llamadas a funciones en un 57 % de media. Probado en un MacBook Pro M4 Max, alcanza velocidades de hasta 139 tokens por segundo, lo que reduce las barreras para el despliegue de agentes locales y ofrece una experiencia de usuario que rivaliza con los modelos en la nube propietarios.
Comprender la arquitectura y el mecanismo de DSpark
La inferencia tradicional de los LLM se ve limitada por el ancho de banda de la memoria, ya que la mayor parte del tiempo se dedica a transferir los pesos de la DRAM a la SRAM. La decodificación especulativa resuelve este problema utilizando un modelo preliminar ligero para generar tokens candidatos, que luego son validados en una única pasada hacia adelante por el modelo de destino, distribuyendo de forma eficaz los costes de carga de los pesos.
DSpark integra los métodos existentes a través de tres componentes principales:
Red de columna vertebral paralela: al igual que DFlash, genera estados ocultos para todos los tokens preliminares en una sola pasada hacia adelante basándose en las características de contexto del modelo de destino.Cabeza secuencial (cabeza de Markov): Al simular cadenas de Markov entre tokens adyacentes, potencia las dependencias y mejora la tasa de aceptación para las posiciones posteriores.Validador de programación por confianza: predice la probabilidad de supervivencia de cada token, descartando automáticamente los sufijos de baja confianza cuando los costes de validación superan los ahorros.Para el entrenamiento, el modelo preliminar utiliza una combinación diversa de conjuntos de datos que incluyen SFT, chat, código y llamadas a funciones. Tras rigurosos estudios de ablación, la versión inicial presenta una arquitectura basada exclusivamente en atención con 5 capas y 9 bloques, manteniendo los parámetros en torno a los 300 millones.
Garantía de calidad e integración en el ecosistema
Debido a la decodificación especulativa, la decodificación codiciosa solo acepta tokens preliminares que coincidan perfectamente con la distribución del modelo de destino. Los tokens rechazados se sustituyen por la salida del modelo de destino, lo que garantiza que la secuencia generada coincida con la estructura de decodificación codiciosa de referencia sin pérdida de precisión en las pruebas comparativas.
En el momento de su lanzamiento, DSpark logró la compatibilidad con los principales marcos de inferencia:
SGLang: admite la ejecución en aceleradores mediante configuraciones de integración y de inicio específicas.llama.cpp: ofrece soporte oficial para la compilación, lo que permite a los usuarios cargar los pesos GGUF correspondientes y los archivos de modelos preliminares a través de la línea de comandos.








 ¿Por qué Abnormal AI se asoció con OpenAI en «Daybreak»?
Michael Aiello, responsable de productos de ciberseguridad en OpenAI | Crédito: Michael Aiello/LinkedInAbnormal AI se une al programa Daybreak de OpenAI; según Mike Aiello, esta colaboración acelerará
 Claw, de AI Agent Elements, finaliza el desarrollo de un material superconductor
A medida que la inteligencia artificial amplía los límites de la exploración científica, se ha alcanzado un hito significativo. El 3 de julio, la Alibaba DAMO Academy, en colaboración con la Universid
 Cómo verificar el posicionamiento SEO en Google Japón y Yahoo Japón de manera efectiva
Convierte una foto de retrato en un boceto de Harry PotterTabla de contenidos:IntroducciónConversión de una fotografía en un bocetoUso del filtro MínimoUna técnica diferente para convertir retratosPrimeros pasosDescarga la imagen requeridaPrep
2026 Últimas mejores herramientas de depuración de ChatGPT para errores de Python, registros de API y triaje de trazas de pila están aquí en XIX.AI. Esta lista curada de soluciones mejor valoradas ofrece una comparación entre versión gratuita y de pago, pruebas en el mundo real y clasificaciones detalladas para ayudarte a encontrar la herramienta más potente que puede aumentar significativamente tu productividad y ayudarte a resolver problemas técnicos complejos más rápido. ¡Explora ahora para descubrir tu solución perfecta!
9 herramientas
xix.ai
2026 Últimas Mejores Herramientas de Voz IA Mejor Valoradas para Videos de Demostración de Productos están aquí en XIX.AI. Esta lista curada presenta opciones poderosas y transformadoras que te ayudan a crear contenido de audio de calidad profesional rápidamente, mejorando significativamente tu eficiencia en las demostraciones. Realizamos pruebas en el mundo real y proporcionamos una comparación entre versión gratuita y de pago, junto con clasificaciones actualizadas semanalmente para ayudarte a encontrar la opción perfecta. Explora ahora para desbloquear tu ventaja con IA.
10 herramientas
xix.ai

¡Las mejores herramientas de 2026 para elaborar planes de negocio basados en IA y validar tu startup! XIX.AI ha elaborado una lista de las herramientas más valoradas, potentes y revolucionarias, que se someten a pruebas en el mundo real para ofrecer resultados precisos. Encontrarás una comparación entre opciones gratuitas y de pago, clasificaciones detalladas e información clara y fácil de entender que te ayudará a elegir la solución perfecta y a aumentar las posibilidades de éxito de tu startup. ¡Échale un vistazo ahora y descubre tu ventaja competitiva en IA!
9 herramientas
xix.ai

¡Las mejores aplicaciones de chat con IA de 2026 para juegos de rol y práctica de conversación! XIX.AI selecciona una lista de herramientas recomendadas y poderosas que deben probarse, sometidas a rigurosas pruebas en el mundo real para ofrecer resultados excepcionales. Encontrarás una comparación detallada entre versiones gratuitas y de pago, clasificaciones completas e información sobre cómo estas aplicaciones pueden mejorar tus habilidades lingüísticas y tu confianza en la comunicación. ¡Explora ahora para descubrir la herramienta perfecta para tu práctica!
10 herramientas
xix.ai

¡Las mejores herramientas de wireframes con IA mejor valoradas de 2026 para equipos de producto! Esta lista seleccionada presenta soluciones potentes y revolucionarias que aumentan significativamente la productividad gracias a pruebas en el mundo real y a rigurosas clasificaciones. Incluye una comparación detallada entre las versiones gratuitas y de pago para ayudarte a encontrar la opción perfecta. XIX.AI ofrece consejos de expertos para orientar tu decisión. ¡Explora ahora para descubrir tu herramienta perfecta y sacar el máximo partido a la IA en el desarrollo de productos!
8 herramientas
xix.ai
Aquí se presentan las mejores herramientas de DevOps con IA de 2026, más valoradas y de última generación, en nuestra lista cuidadosamente seleccionada. Estas potentes herramientas ayudan a los equipos a aumentar significativamente la productividad mediante pruebas en el mundo real y clasificaciones rigurosas. Obtén una comparación gratuita entre versiones gratuitas y de pago para encontrar la opción perfecta que se adapte a tus necesidades. Explora ahora para desbloquear tu ventaja con IA.
11 herramientas
xix.ai












