


 Lar
Google revela o modelo Gemini 3.1 Lightweight com uma interface de usuário impressionante
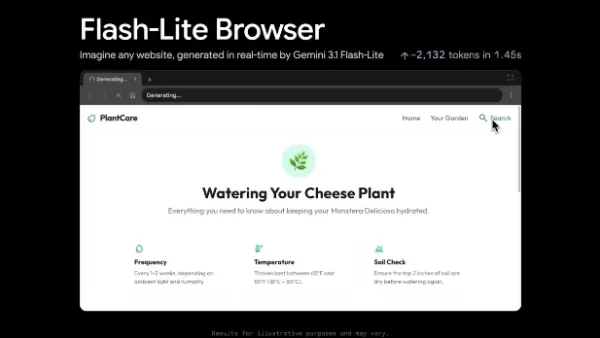
A Google DeepMind revelou seu mais recente avanço em velocidade de IA generativa: o Gemini 3.1 Flash-Lite. Esse modelo oferece uma eficiência de raciocínio excepcional, permitindo a renderização da web quase em tempo real e levando a IA da interação textual básica para a vanguarda do desenvolvimento de interfaces de usuário dinâmicas.
Salto de desempenho e equilíbrio de custos
Dados oficiais indicam que o Gemini 3.1 Flash-Lite responde 2,5 vezes mais rápido do que seu antecessor, o Gemini 2.5 Flash. Ele atinge um rendimento notável, gerando mais de 360 tokens por segundo. Em avaliações de tarefas multimodais realizadas pela empresa independente Artificial Analysis, esse modelo leve chegou a superar concorrentes maiores, como o Claude Opus 4.6.
No entanto, esse aumento de velocidade vem acompanhado de uma estrutura de custos revisada. O preço de saída do modelo aumentou de US$ 0,40 para US$ 1,50 por milhão de tokens, refletindo o custo computacional adicional da tecnologia de alto desempenho e baixa latência.
Demonstração do “Pseudo Browser” e cenários de aplicação
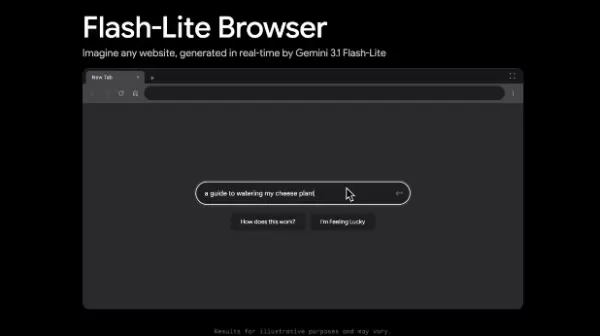
Juntamente com o modelo, o Google lançou um aplicativo de demonstração do “pseudo browser”. Os usuários podem fornecer instruções descritivas, e o sistema gera e renderiza o conteúdo da web correspondente em milissegundos. Embora a demonstração atual possa apresentar instabilidade com lógica complexa em sessões prolongadas, ela demonstra um potencial significativo em várias áreas:
Prototipagem rápida: visualize instantaneamente maquetes e conceitos de interface do usuário.
Interfaces interativas dinâmicas: adapte a estrutura da web com base na intenção do usuário em tempo real.
Tarefas multimodais de baixa latência: Sirva como uma alternativa eficiente a modelos mais pesados em cenários que exigem feedback rápido.
O Gemini 3.1 Flash-Lite já está disponível no Google AI Studio e no Vertex AI, onde os usuários podem experimentar os recursos de geração ultrarrápida.
Artigo relacionado
 A Meta quer que seu próximo gadget seja alimentado por Muse
O Muse da Meta, um assistente de inteligência artificial que gerencia reservas de viagem, envio de formulários e compras, tem sido amplamente adotado, mas uma nova iniciativa pode atrair especialmente desenvolvedores e entusiastas de hardware.Na sex
Wan-Streamer v0.2 oferece chat de IA com latência ultrabaixa
À medida que a tecnologia moderna avança rapidamente, a interação entre humanos e inteligência artificial está se tornando mais comum. As chamadas de vídeo tradicionais frequentemente enfrentam problemas de atraso, latência e dessincronização áudio-v
A Meta se une à TSMC e Micron para equipar novos servidores com memória antiga
À medida que a adoção da inteligência artificial se acelera em todo o mundo, a memória DDR5 de próxima geração está enfrentando uma escassez crítica de suprimentos. Para evitar atrasos nos despliegues de data centers de IA, a Meta estabeleceu uma par
Recomendações de tópicos especiais relacionados
Design e Arte
 As melhores ferramentas de ilustração com IA: crie cenas editoriais e capas de forma mais rápida
As melhores ferramentas de ilustração com IA de 2026: nossa lista selecionada apresenta as melhores ferramentas, com design robusto, para criar rapidamente cenas editoriais impressionantes e capas atraentes. Cada opção passou por rigorosos testes práticos, oferecendo uma comparação entre versões gratuitas e pagas para ajudar você a encontrar a opção perfeita para o seu fluxo de trabalho. Experimente hoje mesmo essas soluções imperdíveis para aproveitar ao máximo as vantagens da IA e impulsionar sua produtividade criativa. Explore agora no XIX.AI.
 10 ferramentas
 xix.ai
Educação e Aprendizagem
Os melhores professores particulares especializados em IA para preparação para exames: pratique matemática, ciências e inglês
Os melhores tutores de IA para preparação para exames de 2026, com as melhores avaliações, estão aqui no XIX.AI! Nossa lista cuidadosamente selecionada apresenta ferramentas poderosas e revolucionárias que oferecem comparação entre versões gratuitas e pagas, testes práticos e rankings atualizados semanalmente. Elas ajudam a aumentar sua eficiência na redação, simplificar o aprendizado de tópicos complexos e liberar seu potencial acadêmico. Explore agora para descobrir sua ferramenta perfeita de preparação para exames e comece a criar hoje mesmo para aproveitar toda a vantagem da IA!
10 ferramentas
xix.ai
Financiar
Ferramentas de planejamento orçamentário com IA para gestão financeira pessoal
As melhores e mais bem avaliadas ferramentas de planejamento orçamentário com IA para gestão financeira pessoal de 2026 estão aqui no XIX.AI! Esta seleção especial apresenta soluções poderosas e revolucionárias que ajudam você a realizar testes na prática, entender hábitos de consumo e criar planos personalizados para aumentar a produtividade. Confira uma comparação entre versões gratuitas e pagas, além de rankings detalhados. Ferramentas imperdíveis, projetadas para simplificar a gestão financeira e explorar o potencial da IA. Explore agora!
11 ferramentas
xix.ai
Saúde e Bem-Estar
Assistentes de rastreamento do sono com IA: melhore sua recuperação adotando hábitos mais adequados antes de dormir
2026 – Os melhores assistentes de rastreamento do sono com inteligência artificial mais bem avaliados, selecionados para proporcionar uma recuperação máxima. Este guia semanal completamente atualizado apresenta ferramentas poderosas que incluem testes reais, comparações entre versões gratuitas e pagas, além de classificações detalhadas, visando ajudá-lo a encontrar a solução ideal para melhorar a qualidade do sono e fomentar hábitos noturnos mais saudáveis. Explore agora em XIX.AI e aproveite todas as vantagens oferecidas pela inteligência artificial.
10 ferramentas
xix.ai
Análise de dados
Copilotos de IA em SQL para análise de produtos e receitas
2026: Os melhores e mais bem avaliados copilotos de IA para SQL em análise de produtos e receitas! A XIX.AI selecionou um conjunto poderoso e revolucionário de ferramentas imperdíveis, que passam por testes práticos por meio de rankings atualizados semanalmente. Essas ferramentas ajudam os usuários a aumentar significativamente a produtividade, acelerando a análise de dados, simplificando consultas complexas e gerando insights precisos para impulsionar decisões de negócios mais inteligentes. Explore agora e descubra a ferramenta perfeita para aproveitar ao máximo o potencial da IA!
14 ferramentas
xix.ai
Educação e Aprendizagem
Os melhores auxiliares de tarefas escolares com IA que ensinam: aprenda conceitos, não apenas respostas
2026: Os melhores e mais bem avaliados auxiliares de tarefas com IA que ensinam conceitos fundamentais, não apenas respostas. Ferramentas poderosas para estudantes. Lista selecionada que você não pode deixar de conferir. Atualizada semanalmente. Comparação entre versões gratuitas e pagas. Testes em situações reais. Rankings precisos para ajudar você a atingir todo o seu potencial de aprendizado. Explore agora e descubra a ferramenta perfeita para estudar de forma mais inteligente.
10 ferramentas
xix.ai

 Comentários (0)
A Google DeepMind revelou seu mais recente avanço em velocidade de IA generativa: o Gemini 3.1 Flash-Lite. Esse modelo oferece uma eficiência de raciocínio excepcional, permitindo a renderização da web quase em tempo real e levando a IA da interação textual básica para a vanguarda do desenvolvimento de interfaces de usuário dinâmicas.
Salto de desempenho e equilíbrio de custos
Dados oficiais indicam que o Gemini 3.1 Flash-Lite responde 2,5 vezes mais rápido do que seu antecessor, o Gemini 2.5 Flash. Ele atinge um rendimento notável, gerando mais de 360 tokens por segundo. Em avaliações de tarefas multimodais realizadas pela empresa independente Artificial Analysis, esse modelo leve chegou a superar concorrentes maiores, como o Claude Opus 4.6.
No entanto, esse aumento de velocidade vem acompanhado de uma estrutura de custos revisada. O preço de saída do modelo aumentou de US$ 0,40 para US$ 1,50 por milhão de tokens, refletindo o custo computacional adicional da tecnologia de alto desempenho e baixa latência.
Demonstração do “Pseudo Browser” e cenários de aplicação
Juntamente com o modelo, o Google lançou um aplicativo de demonstração do “pseudo browser”. Os usuários podem fornecer instruções descritivas, e o sistema gera e renderiza o conteúdo da web correspondente em milissegundos. Embora a demonstração atual possa apresentar instabilidade com lógica complexa em sessões prolongadas, ela demonstra um potencial significativo em várias áreas:
Prototipagem rápida: visualize instantaneamente maquetes e conceitos de interface do usuário.
Interfaces interativas dinâmicas: adapte a estrutura da web com base na intenção do usuário em tempo real.
Tarefas multimodais de baixa latência: Sirva como uma alternativa eficiente a modelos mais pesados em cenários que exigem feedback rápido.
O Gemini 3.1 Flash-Lite já está disponível no Google AI Studio e no Vertex AI, onde os usuários podem experimentar os recursos de geração ultrarrápida.








 A Meta quer que seu próximo gadget seja alimentado por Muse
O Muse da Meta, um assistente de inteligência artificial que gerencia reservas de viagem, envio de formulários e compras, tem sido amplamente adotado, mas uma nova iniciativa pode atrair especialmente desenvolvedores e entusiastas de hardware.Na sex
 Wan-Streamer v0.2 oferece chat de IA com latência ultrabaixa
À medida que a tecnologia moderna avança rapidamente, a interação entre humanos e inteligência artificial está se tornando mais comum. As chamadas de vídeo tradicionais frequentemente enfrentam problemas de atraso, latência e dessincronização áudio-v
 A Meta se une à TSMC e Micron para equipar novos servidores com memória antiga
À medida que a adoção da inteligência artificial se acelera em todo o mundo, a memória DDR5 de próxima geração está enfrentando uma escassez crítica de suprimentos. Para evitar atrasos nos despliegues de data centers de IA, a Meta estabeleceu uma par

As melhores ferramentas de ilustração com IA de 2026: nossa lista selecionada apresenta as melhores ferramentas, com design robusto, para criar rapidamente cenas editoriais impressionantes e capas atraentes. Cada opção passou por rigorosos testes práticos, oferecendo uma comparação entre versões gratuitas e pagas para ajudar você a encontrar a opção perfeita para o seu fluxo de trabalho. Experimente hoje mesmo essas soluções imperdíveis para aproveitar ao máximo as vantagens da IA e impulsionar sua produtividade criativa. Explore agora no XIX.AI.
10 ferramentas
xix.ai

Os melhores tutores de IA para preparação para exames de 2026, com as melhores avaliações, estão aqui no XIX.AI! Nossa lista cuidadosamente selecionada apresenta ferramentas poderosas e revolucionárias que oferecem comparação entre versões gratuitas e pagas, testes práticos e rankings atualizados semanalmente. Elas ajudam a aumentar sua eficiência na redação, simplificar o aprendizado de tópicos complexos e liberar seu potencial acadêmico. Explore agora para descobrir sua ferramenta perfeita de preparação para exames e comece a criar hoje mesmo para aproveitar toda a vantagem da IA!
10 ferramentas
xix.ai

As melhores e mais bem avaliadas ferramentas de planejamento orçamentário com IA para gestão financeira pessoal de 2026 estão aqui no XIX.AI! Esta seleção especial apresenta soluções poderosas e revolucionárias que ajudam você a realizar testes na prática, entender hábitos de consumo e criar planos personalizados para aumentar a produtividade. Confira uma comparação entre versões gratuitas e pagas, além de rankings detalhados. Ferramentas imperdíveis, projetadas para simplificar a gestão financeira e explorar o potencial da IA. Explore agora!
11 ferramentas
xix.ai

2026 – Os melhores assistentes de rastreamento do sono com inteligência artificial mais bem avaliados, selecionados para proporcionar uma recuperação máxima. Este guia semanal completamente atualizado apresenta ferramentas poderosas que incluem testes reais, comparações entre versões gratuitas e pagas, além de classificações detalhadas, visando ajudá-lo a encontrar a solução ideal para melhorar a qualidade do sono e fomentar hábitos noturnos mais saudáveis. Explore agora em XIX.AI e aproveite todas as vantagens oferecidas pela inteligência artificial.
10 ferramentas
xix.ai

2026: Os melhores e mais bem avaliados copilotos de IA para SQL em análise de produtos e receitas! A XIX.AI selecionou um conjunto poderoso e revolucionário de ferramentas imperdíveis, que passam por testes práticos por meio de rankings atualizados semanalmente. Essas ferramentas ajudam os usuários a aumentar significativamente a produtividade, acelerando a análise de dados, simplificando consultas complexas e gerando insights precisos para impulsionar decisões de negócios mais inteligentes. Explore agora e descubra a ferramenta perfeita para aproveitar ao máximo o potencial da IA!
14 ferramentas
xix.ai

2026: Os melhores e mais bem avaliados auxiliares de tarefas com IA que ensinam conceitos fundamentais, não apenas respostas. Ferramentas poderosas para estudantes. Lista selecionada que você não pode deixar de conferir. Atualizada semanalmente. Comparação entre versões gratuitas e pagas. Testes em situações reais. Rankings precisos para ajudar você a atingir todo o seu potencial de aprendizado. Explore agora e descubra a ferramenta perfeita para estudar de forma mais inteligente.
10 ferramentas
xix.ai












