


 Lar
O best-seller “Reservation Ends Token Anxiety”: desenhe fluxogramas à mão livre com o Gemma 4 localmente no navegador, de graça
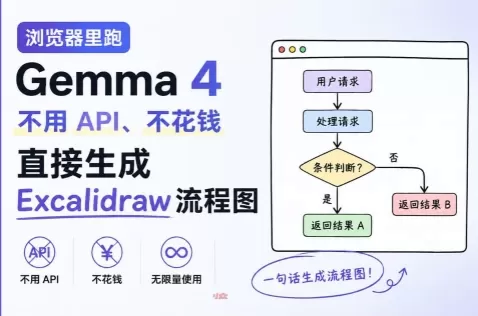
Executar grandes modelos de linguagem em dispositivos móveis não é novidade, mas equipar navegadores com recursos avançados de IA está se tornando uma tendência importante. Recentemente, desenvolvedores integraram o modelo Gemma4 diretamente ao navegador usando o mais recente algoritmo TurboQuant do Google. Isso permite que os usuários tenham interações fluidas com a IA localmente, sem precisar configurar ambientes complexos de API nem pagar taxas de assinatura.
Tecnologia central: a revolução da memória impulsionada pelo TurboQuant
No centro dessa inovação está o algoritmo TurboQuant do Google, que se concentra na otimização do “banco de memória temporária” do modelo de grande porte — o KV Cache (Cache Chave-Valor).
Em configurações convencionais, os dados do cache crescem rapidamente durante conversas longas ou tarefas complexas, causando lentidão no sistema. O TurboQuant compacta essas entradas vetoriais para um sexto do tamanho original e permite a recuperação diretamente do estado compactado. Essa capacidade de “busca sem descompactação” permite que o modelo retenha um contexto mais longo, ao mesmo tempo em que aumenta a eficiência computacional.
Experiência de teste: gerando um fluxograma profissional em 30 segundos
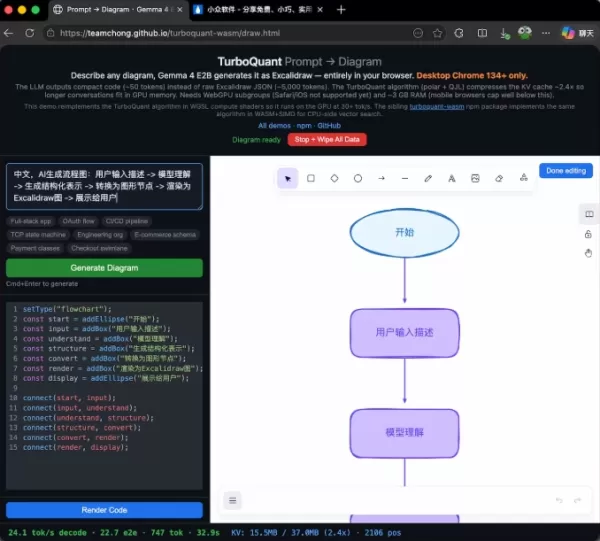
Por exemplo, com uma ferramenta de integração local, os usuários simplesmente abrem uma página da web em um navegador de desktop Chrome 134+ compatível com WebGPU para carregar o modelo Gemma4E2B.
Nos testes, a geração de um fluxograma completo no Excalidraw levou cerca de 32,9 segundos. O modelo produz aproximadamente 24 tokens por segundo no navegador, com resposta rápida de ponta a ponta. A principal vantagem: como todo o cálculo ocorre localmente no dispositivo do usuário, nenhum token online é utilizado, possibilitando uma “criação de custo zero” de fato.
Barreiras e perspectivas: um novo paradigma para aplicações locais de IA
Embora a operação com “tráfego zero” já seja possível, a execução local ainda enfrenta barreiras de hardware. Os usuários precisam baixar cerca de 3,1 GB de arquivos de modelo para o primeiro uso, e os requisitos de versão do navegador são específicos.
Essa solução, desenvolvida com base no WebAssembly (WASM) e no TurboQuant, oferece um modelo altamente replicável para aplicativos de IA leves. Ela demonstra que, sem a dispendiosa computação em nuvem, os navegadores podem lidar com a geração de fluxogramas complexos e o processamento de textos longos por meio da otimização algorítmica. Para usuários que valorizam a privacidade e a eficiência de custos, esse modelo “pronto para uso e executado localmente” pode se tornar a forma dominante das futuras ferramentas de IA.
Artigo relacionado
 Meta Remove Funcionalidade de Edição de Fotos por IA Após Reação Negativa dos Usuários
A Meta, gigante das redes sociais, está novamente envolvida em um debate público sobre o delicado equilíbrio entre inteligência artificial e privacidade dos usuários. De acordo com a TechCrunch, o Superintelligence Labs da Meta apresentou um novo ger
CEO da DeepMind, Hassabis: Durmo seis horas por dia, geralmente me sinto energético por volta da 1h
O Fortune recentemente publicou uma entrevista com Demis Hassabis, CEO da Google DeepMind, revelando sua abordagem incomum para descanso e produtividade. Hassabis revelou que dorme muito pouco, estruturando suas horas acordadas em dois blocos de trab
OpenAI e Anthropic disputam participação no mercado, apesar da queda na receita
Apesar de relatos recentes sugerirem que a OpenAI não atingiu suas metas de receita, o que gerou pressão sobre as ações do setor de tecnologia nesta terça-feira, os investidores privados em laboratóri
Recomendações de tópicos especiais relacionados
Criação de vídeo
 Geradores de ganchos para vídeos curtos com IA para Reels, Shorts e campanhas de lançamento de produtos
Os melhores geradores de ganchos para vídeos curtos com IA de 2026 para Reels, Shorts e campanhas de lançamento de produtos! A XIX.AI seleciona as ferramentas mais bem avaliadas, poderosas e revolucionárias, que oferecem resultados imperdíveis comprovados por testes reais. Esta página, atualizada semanalmente, apresenta rankings comparativos entre opções gratuitas e pagas para ajudar você a encontrar a solução perfeita para impulsionar a criatividade e a produtividade do seu conteúdo. Explore agora para descobrir sua vantagem com IA!
 11 ferramentas
 xix.ai
escrita
Ferramentas de IA para esboço de artigos em formato longo
2026: As melhores e mais bem avaliadas ferramentas de esboço com IA para redação de textos longos! Esta coleção selecionada apresenta ferramentas poderosas e revolucionárias que geram esboços precisos e estruturados, comprovados em testes reais, para aumentar significativamente a eficiência na redação. A XIX.AI faz parte dessa seleção de elite. Veja uma comparação entre as versões gratuita e paga para ajudá-lo a escolher a ferramenta perfeita. Explore agora e descubra sua vantagem com a IA!
9 ferramentas
xix.ai
chatbot
Melhores aplicativos de chat de interpretação de papéis com IA para prática de idiomas, preparação para entrevistas e fluência diária
2026 Últimas Melhores Aplicativos de Chat de Interpretação de Papéis por IA Mais Bem Avaliados para Prática de Idiomas, Preparação para Entrevistas e Fluência Diária! O XIX.AI seleciona uma poderosa coleção revolucionária que oferece comparação entre gratuito e pago, testes do mundo real e classificações atualizadas semanalmente. Essas ferramentas imperdíveis ajudam você a aprimorar suas habilidades de escrita, superar desafios de fluência e melhorar a eficiência da comunicação em todos os cenários diários. Explore agora para descobrir sua ferramenta perfeita para o crescimento do idioma!
10 ferramentas
xix.ai
Composição musical
Ferramentas de separação de stems com IA para produção de remixes, preparação de samples e masters de karaokê
As melhores e mais bem avaliadas ferramentas de separação de faixas com IA de 2026, selecionadas especialmente para produção de remixes, preparação de samples e masters de karaokê. Essas ferramentas poderosas e revolucionárias passaram por testes práticos para oferecer isolamento de áudio preciso, aumentando significativamente a produtividade. A XIX.AI oferece um guia comparativo entre versões gratuitas e pagas, atualizado semanalmente, para ajudá-lo a encontrar a solução imperdível que melhor atenda às suas necessidades. Explore agora para aproveitar ao máximo as vantagens da IA.
8 ferramentas
xix.ai
Análise de dados
Copilotos de IA para SQL voltados para painéis de receita, análise de funis e métricas de produtos
2026: Os melhores copilotos AI para SQL, atualizados e classificados entre os melhores! A XIX.AI reúne uma coleção poderosa e revolucionária, com testes em ambiente real atualizados semanalmente. Essas ferramentas indispensáveis ajudam a gerar painéis de controle de receita precisos, analisar funis de vendas e rastrear métricas de produtos de forma rápida, aumentando significativamente a produtividade. Explore agora e encontre a ferramenta perfeita para tomada de decisões baseadas em dados! 238 caracteres
9 ferramentas
xix.ai
Composição musical
Melhores Ferramentas de IA para Criação de Melodias para Rascunhos de Músicas
2026 Últimas Melhores Ferramentas de Escrita de Melodias por IA Mais Bem Avaliadas para Rascunhos de Músicas! A XIX.AI reuniu uma coleção altamente poderosa e transformadora, que passou por rigorosos testes no mundo real para oferecer a melhor experiência de escrita. Você pode encontrar comparações detalhadas entre as versões gratuita e paga, classificações precisas e opções imperdíveis projetadas para ajudá-lo a criar rascunhos de músicas impressionantes sem esforço e aumentar significativamente sua produtividade criativa. Explore agora para descobrir a ferramenta perfeita para você!
8 ferramentas
xix.ai

 Comentários (0)
Executar grandes modelos de linguagem em dispositivos móveis não é novidade, mas equipar navegadores com recursos avançados de IA está se tornando uma tendência importante. Recentemente, desenvolvedores integraram o modelo Gemma4 diretamente ao navegador usando o mais recente algoritmo TurboQuant do Google. Isso permite que os usuários tenham interações fluidas com a IA localmente, sem precisar configurar ambientes complexos de API nem pagar taxas de assinatura.
Tecnologia central: a revolução da memória impulsionada pelo TurboQuant
No centro dessa inovação está o algoritmo TurboQuant do Google, que se concentra na otimização do “banco de memória temporária” do modelo de grande porte — o KV Cache (Cache Chave-Valor).
Em configurações convencionais, os dados do cache crescem rapidamente durante conversas longas ou tarefas complexas, causando lentidão no sistema. O TurboQuant compacta essas entradas vetoriais para um sexto do tamanho original e permite a recuperação diretamente do estado compactado. Essa capacidade de “busca sem descompactação” permite que o modelo retenha um contexto mais longo, ao mesmo tempo em que aumenta a eficiência computacional.
Experiência de teste: gerando um fluxograma profissional em 30 segundos
Por exemplo, com uma ferramenta de integração local, os usuários simplesmente abrem uma página da web em um navegador de desktop Chrome 134+ compatível com WebGPU para carregar o modelo Gemma4E2B.
Nos testes, a geração de um fluxograma completo no Excalidraw levou cerca de 32,9 segundos. O modelo produz aproximadamente 24 tokens por segundo no navegador, com resposta rápida de ponta a ponta. A principal vantagem: como todo o cálculo ocorre localmente no dispositivo do usuário, nenhum token online é utilizado, possibilitando uma “criação de custo zero” de fato.
Barreiras e perspectivas: um novo paradigma para aplicações locais de IA
Embora a operação com “tráfego zero” já seja possível, a execução local ainda enfrenta barreiras de hardware. Os usuários precisam baixar cerca de 3,1 GB de arquivos de modelo para o primeiro uso, e os requisitos de versão do navegador são específicos.
Essa solução, desenvolvida com base no WebAssembly (WASM) e no TurboQuant, oferece um modelo altamente replicável para aplicativos de IA leves. Ela demonstra que, sem a dispendiosa computação em nuvem, os navegadores podem lidar com a geração de fluxogramas complexos e o processamento de textos longos por meio da otimização algorítmica. Para usuários que valorizam a privacidade e a eficiência de custos, esse modelo “pronto para uso e executado localmente” pode se tornar a forma dominante das futuras ferramentas de IA.








 Meta Remove Funcionalidade de Edição de Fotos por IA Após Reação Negativa dos Usuários
A Meta, gigante das redes sociais, está novamente envolvida em um debate público sobre o delicado equilíbrio entre inteligência artificial e privacidade dos usuários. De acordo com a TechCrunch, o Superintelligence Labs da Meta apresentou um novo ger
 CEO da DeepMind, Hassabis: Durmo seis horas por dia, geralmente me sinto energético por volta da 1h
O Fortune recentemente publicou uma entrevista com Demis Hassabis, CEO da Google DeepMind, revelando sua abordagem incomum para descanso e produtividade. Hassabis revelou que dorme muito pouco, estruturando suas horas acordadas em dois blocos de trab
 OpenAI e Anthropic disputam participação no mercado, apesar da queda na receita
Apesar de relatos recentes sugerirem que a OpenAI não atingiu suas metas de receita, o que gerou pressão sobre as ações do setor de tecnologia nesta terça-feira, os investidores privados em laboratóri

Os melhores geradores de ganchos para vídeos curtos com IA de 2026 para Reels, Shorts e campanhas de lançamento de produtos! A XIX.AI seleciona as ferramentas mais bem avaliadas, poderosas e revolucionárias, que oferecem resultados imperdíveis comprovados por testes reais. Esta página, atualizada semanalmente, apresenta rankings comparativos entre opções gratuitas e pagas para ajudar você a encontrar a solução perfeita para impulsionar a criatividade e a produtividade do seu conteúdo. Explore agora para descobrir sua vantagem com IA!
11 ferramentas
xix.ai

2026: As melhores e mais bem avaliadas ferramentas de esboço com IA para redação de textos longos! Esta coleção selecionada apresenta ferramentas poderosas e revolucionárias que geram esboços precisos e estruturados, comprovados em testes reais, para aumentar significativamente a eficiência na redação. A XIX.AI faz parte dessa seleção de elite. Veja uma comparação entre as versões gratuita e paga para ajudá-lo a escolher a ferramenta perfeita. Explore agora e descubra sua vantagem com a IA!
9 ferramentas
xix.ai

2026 Últimas Melhores Aplicativos de Chat de Interpretação de Papéis por IA Mais Bem Avaliados para Prática de Idiomas, Preparação para Entrevistas e Fluência Diária! O XIX.AI seleciona uma poderosa coleção revolucionária que oferece comparação entre gratuito e pago, testes do mundo real e classificações atualizadas semanalmente. Essas ferramentas imperdíveis ajudam você a aprimorar suas habilidades de escrita, superar desafios de fluência e melhorar a eficiência da comunicação em todos os cenários diários. Explore agora para descobrir sua ferramenta perfeita para o crescimento do idioma!
10 ferramentas
xix.ai

As melhores e mais bem avaliadas ferramentas de separação de faixas com IA de 2026, selecionadas especialmente para produção de remixes, preparação de samples e masters de karaokê. Essas ferramentas poderosas e revolucionárias passaram por testes práticos para oferecer isolamento de áudio preciso, aumentando significativamente a produtividade. A XIX.AI oferece um guia comparativo entre versões gratuitas e pagas, atualizado semanalmente, para ajudá-lo a encontrar a solução imperdível que melhor atenda às suas necessidades. Explore agora para aproveitar ao máximo as vantagens da IA.
8 ferramentas
xix.ai

2026: Os melhores copilotos AI para SQL, atualizados e classificados entre os melhores! A XIX.AI reúne uma coleção poderosa e revolucionária, com testes em ambiente real atualizados semanalmente. Essas ferramentas indispensáveis ajudam a gerar painéis de controle de receita precisos, analisar funis de vendas e rastrear métricas de produtos de forma rápida, aumentando significativamente a produtividade. Explore agora e encontre a ferramenta perfeita para tomada de decisões baseadas em dados! 238 caracteres
9 ferramentas
xix.ai

2026 Últimas Melhores Ferramentas de Escrita de Melodias por IA Mais Bem Avaliadas para Rascunhos de Músicas! A XIX.AI reuniu uma coleção altamente poderosa e transformadora, que passou por rigorosos testes no mundo real para oferecer a melhor experiência de escrita. Você pode encontrar comparações detalhadas entre as versões gratuita e paga, classificações precisas e opções imperdíveis projetadas para ajudá-lo a criar rascunhos de músicas impressionantes sem esforço e aumentar significativamente sua produtividade criativa. Explore agora para descobrir a ferramenta perfeita para você!
8 ferramentas
xix.ai












