


 Heim
Bestseller-Reservierung macht Schluss mit der Angst vor Token: Zeichnen Sie handgezeichnete Flussdiagramme mit Gemma 4 lokal im Browser – kostenlos
Der Einsatz großer Sprachmodelle auf Mobilgeräten ist nichts Neues, doch die Ausstattung von Browsern mit fortschrittlichen KI-Fähigkeiten entwickelt sich zu einem wichtigen Trend. Vor kurzem haben Entwickler das Gemma4-Modell mithilfe des neuesten TurboQuant-Algorithmus von Google direkt in den Browser integriert. Dadurch können Nutzer lokal reibungslose KI-Interaktionen erleben, ohne komplexe API-Umgebungen einrichten oder Abonnementgebühren zahlen zu müssen.
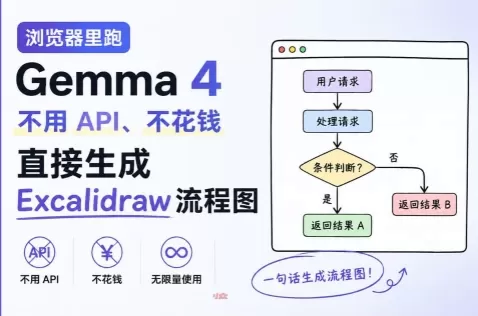
Kerntechnologie: Die von TurboQuant vorangetriebene Speicherrevolution
Das Herzstück dieses Durchbruchs ist Googles TurboQuant-Algorithmus, der sich auf die Optimierung des „temporären Speichers“ des großen Modells konzentriert – den KV-Cache (Key-Value-Cache).
In herkömmlichen Konfigurationen wachsen die Cache-Daten bei langen Konversationen oder komplexen Aufgaben schnell an, was zu Systemverlangsamungen führt. TurboQuant komprimiert diese Vektoreinträge auf ein Sechstel ihrer ursprünglichen Größe und ermöglicht den Abruf direkt aus dem komprimierten Zustand. Diese Fähigkeit zum „Suchen ohne Dekomprimierung“ ermöglicht es dem Modell, einen längeren Kontext beizubehalten und gleichzeitig die Recheneffizienz zu steigern.
Testerfahrung: Erstellung eines professionellen Flussdiagramms in 30 Sekunden
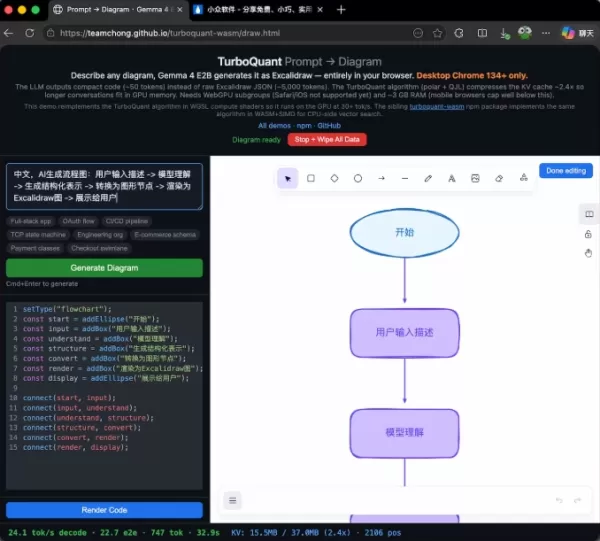
Mit einem lokalen Integrations-Tool öffnen Nutzer beispielsweise einfach eine Webseite in einem Chrome-Desktop-Browser ab Version 134, der WebGPU unterstützt, um das Gemma4E2B-Modell zu laden.
Im Test dauerte die Erstellung eines vollständigen Excalidraw-Flussdiagramms etwa 32,9 Sekunden. Das Modell erzeugt im Browser etwa 24 Token pro Sekunde und liefert eine schnelle End-to-End-Reaktion. Der entscheidende Vorteil: Da die gesamte Berechnung lokal auf dem Gerät des Nutzers stattfindet, werden keine Online-Token verwendet, was eine echte „kostenlose Erstellung“ ermöglicht.
Hindernisse und Perspektiven: Ein neues Paradigma für lokale KI-Anwendungen
Zwar ist ein Betrieb ohne Datenverkehr nun möglich, doch stößt die lokale Ausführung nach wie vor auf Hardware-Hürden. Nutzer müssen bei der ersten Verwendung etwa 3,1 GB an Modelldateien herunterladen, und es gelten spezifische Anforderungen an die Browserversion.
Diese auf WebAssembly (WASM) und TurboQuant basierende Lösung bietet einen in hohem Maße reproduzierbaren Entwurf für ressourcenschonende KI-Anwendungen. Sie zeigt, dass Browser ohne teures Cloud-Computing durch algorithmische Optimierung die Erstellung komplexer Flussdiagramme und die Verarbeitung langer Texte bewältigen können. Für Nutzer, denen Datenschutz und Kosteneffizienz wichtig sind, könnte dieses „gebrauchsfertige, lokal ausgeführte“ Modell zur vorherrschenden Form zukünftiger KI-Tools werden.
Verwandter Artikel
 Superintelligenz ist da: Lassen wir sie herein?
Laden des Players…KI-Unternehmen sprechen so, als sei eine superintelligente KI unvermeidlich, doch jüngste Sicherheitsvorfälle wie der Hugging-Face-Breach bei OpenAI zeigen die potenziellen Gefahren des Einsatzes von KI-Systemen, die leistungsfähig
iFLYTEK stellt das allgemeine Großmodell Spark X2.5 vor
Am 1. September wird iFlytek zwei kantenorientierte Large-Language-Modelle, Xinghuo X2.5-4B und Xinghuo X2.5-1.7B, open-source veröffentlichen, wie aus der neuesten offiziellen Ankündigung hervorgeht. Beide Modelle unterstützen nativ ein Kontextfenst
Meta entfernt KI-Fotobearbeitungsfunktion nach Nutzerprotesten
Meta, der Social-Media-Riese, ist erneut in eine öffentliche Debatte über die heikle Balance zwischen künstlicher Intelligenz und dem Schutz der Privatsphäre der Nutzer verwickelt. Laut TechCrunch hat Meta’s Superintelligence Labs diese Woche einen n
Empfehlungen zu verwandten Spezialthemen
Animationserstellung
 KI-Tools zur Szenenanimation für Social-Media-Inhalte
2026 – Die neuesten, besten und am besten bewerteten KI-Tools für Szenenanimationen in Social-Media-Inhalten wurden hier von XIX.AI zusammengestellt. Diese leistungsstarken, bahnbrechenden Tools bieten Praxistests und einen detaillierten Vergleich zwischen kostenlosen und kostenpflichtigen Versionen und helfen Kreativen dabei, ihre Produktivität erheblich zu steigern. Entdecken Sie sie jetzt und sichern Sie sich Ihren KI-Vorteil.
 9 Tools
 xix.ai
Videoerstellung
KI-Generatoren für ansprechende Kurzvideos für Reels, Shorts und Produkteinführungskampagnen
Die besten KI-Generatoren für kurze Video-Hooks des Jahres 2026 für Reels, Shorts und Produkteinführungskampagnen! XIX.AI stellt erstklassige, leistungsstarke und bahnbrechende Tools zusammen, die in Praxistests überzeugende Ergebnisse liefern, die Sie unbedingt ausprobieren sollten. Diese wöchentlich aktualisierte Seite bietet Vergleichsrankings zwischen kostenlosen und kostenpflichtigen Angeboten, damit Sie die perfekte Lösung finden, um Ihre Kreativität und Produktivität bei der Erstellung von Inhalten zu steigern. Entdecken Sie jetzt die Seite und sichern Sie sich Ihren KI-Vorteil!
11 Tools
xix.ai
Schreiben
KI-Tools zur Gliederung von Artikeln für das Verfassen langer Texte
2026: Die neuesten, besten und am besten bewerteten KI-Tools zur Erstellung von Gliederungen für lange Texte! Diese sorgfältig zusammengestellte Sammlung umfasst leistungsstarke, bahnbrechende Tools, die präzise, strukturierte Gliederungen liefern – getestet unter realen Bedingungen –, um die Effizienz beim Schreiben deutlich zu steigern. XIX.AI gehört zu dieser Eliteauswahl. Holen Sie sich einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, der Ihnen bei der Auswahl des perfekten Tools hilft. Entdecken Sie die Tools jetzt und sichern Sie sich Ihren KI-Vorteil!
9 Tools
xix.ai
Chatbot
Die besten KI-Rollenspiel-Chat-Apps für Sprachpraxis, Vorstellungsgesprächsvorbereitung und tägliche Sprechflüssigkeit
2026 Neueste Besten Top-bewerteten KI-Rollenspiel-Chat-Apps für Sprachpraxis, Vorstellungsgesprächsvorbereitung und tägliche Sprachflüssigkeit! XIX.AI kuratiert eine leistungsstarke, spielfeldverändernde Sammlung, die kostenlose gegen kostenpflichtige Vergleiche, reale Tests und wöchentlich aktualisierte Rankings bietet. Diese unbedingt auszuprobierenden Tools helfen Ihnen, Ihre Schreibfähigkeiten zu verbessern, Hürden der Sprachflüssigkeit zu überwinden und die Kommunikationseffizienz in allen alltäglichen Szenarien zu steigern. Entdecken Sie jetzt Ihr perfektes Werkzeug für Ihre Sprachentwicklung!
10 Tools
xix.ai
Musikkomposition
KI-Tools zur Stim-Trennung für die Remix-Produktion, die Vorbereitung von Samples und Karaoke-Master
Die besten und am besten bewerteten KI-Tools zur Stem-Trennung des Jahres 2026 – speziell ausgewählt für Remix-Produktionen, die Vorbereitung von Samples und Karaoke-Masters. Diese leistungsstarken, bahnbrechenden Tools haben sich in der Praxis bewährt und bieten präzise Audioisolierung, wodurch die Produktivität erheblich gesteigert wird. XIX.AI stellt einen wöchentlich aktualisierten Vergleichsleitfaden zwischen kostenlosen und kostenpflichtigen Lösungen bereit, der Ihnen hilft, die für Ihre Anforderungen passende Lösung zu finden, die Sie unbedingt ausprobieren sollten. Entdecken Sie ihn jetzt und sichern Sie sich Ihren KI-Vorteil.
8 Tools
xix.ai
Datenanalyse
KI-basierte SQL-Copiloten für Umsatz-Dashboards, Kanalanalysen sowie Produktmetriken
2026: Die neuesten und besten AI-SQL-Copiloten – alle in der Rangliste ganz oben! XIX.AI sammelt eine leistungsstarke Auswahl an Tools, die wöchentlich mit aktualisierten Tests aus der Praxis erweitert wird. Mit diesen unverzichtbaren Werkzeugen können Sie präzise Umsatzübersichten erstellen, Verkaufsprozesse analysieren sowie Produktmetriken schnell überwachen und so Ihre Produktivität erheblich steigern. Entdecken Sie jetzt das perfekte Tool für datenbasierte Entscheidungsfindung! 238 Zeichen
9 Tools
xix.ai

 Kommentare (0)
Der Einsatz großer Sprachmodelle auf Mobilgeräten ist nichts Neues, doch die Ausstattung von Browsern mit fortschrittlichen KI-Fähigkeiten entwickelt sich zu einem wichtigen Trend. Vor kurzem haben Entwickler das Gemma4-Modell mithilfe des neuesten TurboQuant-Algorithmus von Google direkt in den Browser integriert. Dadurch können Nutzer lokal reibungslose KI-Interaktionen erleben, ohne komplexe API-Umgebungen einrichten oder Abonnementgebühren zahlen zu müssen.
Kerntechnologie: Die von TurboQuant vorangetriebene Speicherrevolution
Das Herzstück dieses Durchbruchs ist Googles TurboQuant-Algorithmus, der sich auf die Optimierung des „temporären Speichers“ des großen Modells konzentriert – den KV-Cache (Key-Value-Cache).
In herkömmlichen Konfigurationen wachsen die Cache-Daten bei langen Konversationen oder komplexen Aufgaben schnell an, was zu Systemverlangsamungen führt. TurboQuant komprimiert diese Vektoreinträge auf ein Sechstel ihrer ursprünglichen Größe und ermöglicht den Abruf direkt aus dem komprimierten Zustand. Diese Fähigkeit zum „Suchen ohne Dekomprimierung“ ermöglicht es dem Modell, einen längeren Kontext beizubehalten und gleichzeitig die Recheneffizienz zu steigern.
Testerfahrung: Erstellung eines professionellen Flussdiagramms in 30 Sekunden
Mit einem lokalen Integrations-Tool öffnen Nutzer beispielsweise einfach eine Webseite in einem Chrome-Desktop-Browser ab Version 134, der WebGPU unterstützt, um das Gemma4E2B-Modell zu laden.
Im Test dauerte die Erstellung eines vollständigen Excalidraw-Flussdiagramms etwa 32,9 Sekunden. Das Modell erzeugt im Browser etwa 24 Token pro Sekunde und liefert eine schnelle End-to-End-Reaktion. Der entscheidende Vorteil: Da die gesamte Berechnung lokal auf dem Gerät des Nutzers stattfindet, werden keine Online-Token verwendet, was eine echte „kostenlose Erstellung“ ermöglicht.
Hindernisse und Perspektiven: Ein neues Paradigma für lokale KI-Anwendungen
Zwar ist ein Betrieb ohne Datenverkehr nun möglich, doch stößt die lokale Ausführung nach wie vor auf Hardware-Hürden. Nutzer müssen bei der ersten Verwendung etwa 3,1 GB an Modelldateien herunterladen, und es gelten spezifische Anforderungen an die Browserversion.
Diese auf WebAssembly (WASM) und TurboQuant basierende Lösung bietet einen in hohem Maße reproduzierbaren Entwurf für ressourcenschonende KI-Anwendungen. Sie zeigt, dass Browser ohne teures Cloud-Computing durch algorithmische Optimierung die Erstellung komplexer Flussdiagramme und die Verarbeitung langer Texte bewältigen können. Für Nutzer, denen Datenschutz und Kosteneffizienz wichtig sind, könnte dieses „gebrauchsfertige, lokal ausgeführte“ Modell zur vorherrschenden Form zukünftiger KI-Tools werden.








 Superintelligenz ist da: Lassen wir sie herein?
Laden des Players…KI-Unternehmen sprechen so, als sei eine superintelligente KI unvermeidlich, doch jüngste Sicherheitsvorfälle wie der Hugging-Face-Breach bei OpenAI zeigen die potenziellen Gefahren des Einsatzes von KI-Systemen, die leistungsfähig
 iFLYTEK stellt das allgemeine Großmodell Spark X2.5 vor
Am 1. September wird iFlytek zwei kantenorientierte Large-Language-Modelle, Xinghuo X2.5-4B und Xinghuo X2.5-1.7B, open-source veröffentlichen, wie aus der neuesten offiziellen Ankündigung hervorgeht. Beide Modelle unterstützen nativ ein Kontextfenst
 Meta entfernt KI-Fotobearbeitungsfunktion nach Nutzerprotesten
Meta, der Social-Media-Riese, ist erneut in eine öffentliche Debatte über die heikle Balance zwischen künstlicher Intelligenz und dem Schutz der Privatsphäre der Nutzer verwickelt. Laut TechCrunch hat Meta’s Superintelligence Labs diese Woche einen n

2026 – Die neuesten, besten und am besten bewerteten KI-Tools für Szenenanimationen in Social-Media-Inhalten wurden hier von XIX.AI zusammengestellt. Diese leistungsstarken, bahnbrechenden Tools bieten Praxistests und einen detaillierten Vergleich zwischen kostenlosen und kostenpflichtigen Versionen und helfen Kreativen dabei, ihre Produktivität erheblich zu steigern. Entdecken Sie sie jetzt und sichern Sie sich Ihren KI-Vorteil.
9 Tools
xix.ai

Die besten KI-Generatoren für kurze Video-Hooks des Jahres 2026 für Reels, Shorts und Produkteinführungskampagnen! XIX.AI stellt erstklassige, leistungsstarke und bahnbrechende Tools zusammen, die in Praxistests überzeugende Ergebnisse liefern, die Sie unbedingt ausprobieren sollten. Diese wöchentlich aktualisierte Seite bietet Vergleichsrankings zwischen kostenlosen und kostenpflichtigen Angeboten, damit Sie die perfekte Lösung finden, um Ihre Kreativität und Produktivität bei der Erstellung von Inhalten zu steigern. Entdecken Sie jetzt die Seite und sichern Sie sich Ihren KI-Vorteil!
11 Tools
xix.ai

2026: Die neuesten, besten und am besten bewerteten KI-Tools zur Erstellung von Gliederungen für lange Texte! Diese sorgfältig zusammengestellte Sammlung umfasst leistungsstarke, bahnbrechende Tools, die präzise, strukturierte Gliederungen liefern – getestet unter realen Bedingungen –, um die Effizienz beim Schreiben deutlich zu steigern. XIX.AI gehört zu dieser Eliteauswahl. Holen Sie sich einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, der Ihnen bei der Auswahl des perfekten Tools hilft. Entdecken Sie die Tools jetzt und sichern Sie sich Ihren KI-Vorteil!
9 Tools
xix.ai

2026 Neueste Besten Top-bewerteten KI-Rollenspiel-Chat-Apps für Sprachpraxis, Vorstellungsgesprächsvorbereitung und tägliche Sprachflüssigkeit! XIX.AI kuratiert eine leistungsstarke, spielfeldverändernde Sammlung, die kostenlose gegen kostenpflichtige Vergleiche, reale Tests und wöchentlich aktualisierte Rankings bietet. Diese unbedingt auszuprobierenden Tools helfen Ihnen, Ihre Schreibfähigkeiten zu verbessern, Hürden der Sprachflüssigkeit zu überwinden und die Kommunikationseffizienz in allen alltäglichen Szenarien zu steigern. Entdecken Sie jetzt Ihr perfektes Werkzeug für Ihre Sprachentwicklung!
10 Tools
xix.ai

Die besten und am besten bewerteten KI-Tools zur Stem-Trennung des Jahres 2026 – speziell ausgewählt für Remix-Produktionen, die Vorbereitung von Samples und Karaoke-Masters. Diese leistungsstarken, bahnbrechenden Tools haben sich in der Praxis bewährt und bieten präzise Audioisolierung, wodurch die Produktivität erheblich gesteigert wird. XIX.AI stellt einen wöchentlich aktualisierten Vergleichsleitfaden zwischen kostenlosen und kostenpflichtigen Lösungen bereit, der Ihnen hilft, die für Ihre Anforderungen passende Lösung zu finden, die Sie unbedingt ausprobieren sollten. Entdecken Sie ihn jetzt und sichern Sie sich Ihren KI-Vorteil.
8 Tools
xix.ai

2026: Die neuesten und besten AI-SQL-Copiloten – alle in der Rangliste ganz oben! XIX.AI sammelt eine leistungsstarke Auswahl an Tools, die wöchentlich mit aktualisierten Tests aus der Praxis erweitert wird. Mit diesen unverzichtbaren Werkzeugen können Sie präzise Umsatzübersichten erstellen, Verkaufsprozesse analysieren sowie Produktmetriken schnell überwachen und so Ihre Produktivität erheblich steigern. Entdecken Sie jetzt das perfekte Tool für datenbasierte Entscheidungsfindung! 238 Zeichen
9 Tools
xix.ai












