


 집
경쟁사가 잠재적으로 위험한 AI 모델을 출시하면 OpenAI의 안전장치가 느슨해질 수 있습니다.
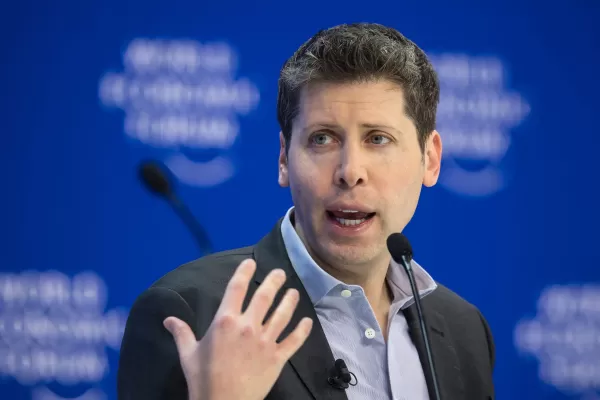
경쟁 압력 속에서 안전 프로토콜을 조정하는 OpenAI
OpenAI는 개발 주기 전반에 걸쳐 AI 모델 안전성 평가 및 보호 조치 구현을 안내하는 내부 메커니즘인 대비 프레임워크를 수정했습니다. 업데이트된 정책에는 특히 경쟁업체가 동등한 보호 조치 없이 고위험 시스템을 출시할 경우 안전 조치를 완화할 수 있는 조항이 포함되어 있습니다.
이러한 변경은 AI 개발자들이 배포 일정을 앞당기도록 강요하는 시장의 압력이 커지고 있음을 강조합니다. OpenAI는 더 빠른 출시를 위해 안전 우선순위를 낮추고, 안전 평가 문서 공개를 지연하는 등의 의혹에 대한 조사가 강화되고 있습니다. 최근 12명의 전직 직원이 OpenAI를 상대로 제기한 소송을 지지하며, 계획된 기업 구조조정이 안전 기준을 더욱 약화시킬 수 있다고 경고하는 법적 절차를 진행 중입니다.
경쟁과 안전의 균형
비판을 예상한 OpenAI는 어떤 정책 조정이 있더라도 엄격한 보호 수준을 유지할 것이라고 강조했습니다. 화요일 블로그 업데이트에 따르면 "경쟁업체가 유사한 안전장치가 없는 고위험 시스템을 배포하는 경우 요구 사항을 조정할 수 있다"면서도 "철저한 위험 검증, 수정에 대한 투명성, 우수한 보호 조치 유지에 전념할 것"이라고 밝혔습니다.
개정된 프레임워크는 기존의 사람 주도의 테스트와 함께 자동화된 평가 도구에 대한 OpenAI의 의존도가 증가하고 있음을 강조합니다. 회사 관계자들은 이러한 자동화된 시스템을 통해 평가 품질을 저하시키지 않으면서도 출시 속도를 유지할 수 있다고 주장합니다.
논란의 여지가 있는 테스트 관행 등장
내부자 계정을 통해 안전 검토 기간이 압축되었다는 사실이 드러나면서 OpenAI의 공식 입장과 상반되는 보도가 나왔습니다. 파이낸셜 타임즈 소식통에 따르면, 테스터들은 최근 출시가 임박한 모델을 평가하는 데 1주일도 채 걸리지 않아 이전보다 훨씬 짧은 시간을 받았다고 합니다. 공개 배포 버전이 아닌 출시 전 모델 변형에 대한 안전성 테스트가 주로 이루어지고 있다는 우려도 추가로 제기되었습니다.
OpenAI는 조용히 안전에 대한 약속을 줄였습니다.
프레임워크 변경에서 생략:
- 미세 조정된 모델에 대한 안전 테스트 불필요
- 스티븐 애들러 (@sjgadler) April 15, 2025
재정의된 위험 분류 시스템
업데이트된 프레임워크는 두 가지 기능 임계값에 초점을 맞춘 간소화된 모델 분류를 도입합니다:
- 높은 역량: 기존의 심각한 피해 벡터를 증폭시키는 모델
- 중요 역량: 새로운 심각한 피해 경로를 확립하는 모델
"고기능 시스템은 위험을 완화하는 안전장치를 사전 배포해야 합니다."라고 OpenAI는 설명합니다. "중요 역량 모델은 추가적인 개발 단계 보호가 필요합니다."
이는 2023년 이후 프레임워크의 첫 번째 실질적인 개정으로, 진화하는 산업 역학 관계와 OpenAI의 내부 운영 변화를 반영합니다.
관련 기사
 OpenAI, 청소년들이 ChatGPT를 사용하기 시작한 지 수년 만에 더 안전한 버전을 출시했다
AI 챗봇에 안전 프로토콜이 부재하여 청소년 자살 및 기타 정신 건강 위기를 초래했다는 일련의 소송이 제기된 데 이어, 오픈AI는 월요일 ‘ChatGPT for Teens’를 공개했다. 이 새로운 서비스는 강화된 안전 기능을 탑재했으며, 학교에서 AI 도구가 조장하는 학업 부정행위라는 점점 심각해지는 문제도 해결하고자 한다.교육적 관점에서 볼 때, ‘Cha
프론티어 AI 랩스, 비정상 모델에 대한 통제 전략 공개 거부
최근 연구에 따르면, 선도적인 AI 연구소 중 극소수만이 통제 대응 계획을 발표하거나 시연한 것으로 나타났습니다. 통제 계획은 AI 시스템이 인간의 통제를 무력화하려 할 때의 절차를 정의하며, 어떤 접근 권한이 철회되고 언제 시스템이 완전히 종료되는지를 명시합니다.이러한 결과는 안전한 최첨단 AI 개발 관행을 장려하는 데 주력하는 단체인 ‘Guideligh
NEA의 티파니 럭: 기업들은 여전히 AI ROI와 씨름하고 있다
플레이어 로딩 중…올초 실리콘밸리에서는 ‘토큰 극대화(tokenmaxxing)’가 주요 화두였으며, 최고경영자들은 직원들에게 AI 활용을 극대화할 것을 독려했습니다. 그러나 이러한 열정은 곧 현실과 부딪혔습니다. 우버(Uber)는 보고에 따라 수개월 만에 연간 AI 예산을 초과했으며, 일부 기업은 부서 전반에 걸쳐 Claude 구독을 축소했고, 메타(Meta)는 내부 성과 평가 제도를 중단했습니다.NEA의 파트너 티파니 럭(Tiffany L
관련 특별 주제 추천
챗봇
 언어 연습, 면접 준비 및 일상 유창성을 위한 최고의 AI 역할극 채팅 앱
2026년 최신 최고 인기 AI 역할극 채팅 앱: 언어 연습, 면접 준비 및 일상 유창성을 위한 최고의 선택! XIX.AI는 무료와 유료 비교, 실제 테스트, 매주 업데이트되는 순위 등을 제공하는 강력한 혁신적인 컬렉션을 엄선합니다. 이 필수 도구들은 글쓰기 실력을 향상시키고, 유창성 관련 어려움을 극복하며, 모든 일상 상황에서 의사소통 효율성을 높이는 데 도움을 줍니다. 지금 바로 탐색하여 언어 성장을 위한 완벽한 도구를 발견하세요!
 10 도구
 xix.ai
음악 작곡
리믹스 제작, 샘플링 준비, 카라오케 마스터 파일 제작을 위한 AI 스템 분리 도구
2026년 최신형으로 선정된 최고 평점의 AI 스템 분리 도구들은 리믹스 제작, 샘플링 준비, 카라오케 녹음에 특화되어 있습니다. 이 강력하고 혁신적인 도구들은 실제 환경에서의 테스트를 거쳐 정밀한 오디오 분리 기능을 제공함으로써 작업 효율성을 크게 향상시켜 줍니다. XIX.AI는 매주 업데이트되는 무료 버전과 유료 버전의 비교 가이드를 제공하여 사용자의 니즈에 가장 적합한 도구를 찾는 데 도움을 줍니다. 지금 바로 확인하여 AI 기술의 잠재력을 최대한 활용해 보세요.
8 도구
xix.ai
데이터 분석
수익 대시보드, 퍼널 분석, 그리고 제품 지표를 위한 AI SQL 코파일럿
2026년 최신 최고의 AI SQL 코파일럿들이 최상위 순위에 올랐습니다! XIX.AI는 매주 업데이트되는 실제 환경 테스트를 위해 강력하고 혁신적인 도구들을 선별하여 제공합니다. 반드시 사용해 보아야 할 이 도구들은 정확한 수익 대시보드를 생성하고, 판매 과정을 분석하며, 제품 관련 지표를 신속하게 추적할 수 있도록 도와 생산성을 크게 향상시켜 줍니다. 데이터 기반 의사결정을 위한 완벽한 도구를 찾아보세요! 238자
9 도구
xix.ai
음악 작곡
노래 초안을 위한 최고의 AI 멜로디 작곡 도구
2026년 최신 최고 인기 AI 멜로디 작곡 도구! XIX.AI는 엄격한 실전 테스트를 거쳐 최고의 작곡 경험을 제공하는 강력한 게임 체인저 컬렉션을 엄선했습니다. 무료와 유료 버전의 상세 비교, 정확한 순위, 그리고 놀라운 노래 초안을 손쉽게 만들고 창의적 생산성을 크게 높일 수 있는 필수 추천 옵션들을 확인할 수 있습니다. 지금 바로 탐색하여 완벽한 도구를 발견하세요!
8 도구
xix.ai
챗봇
면접 연습을 위한 최고의 AI 대화 트레이너 도구
2026년 최신 최고의 평점 높은 AI 대화 트레이너 도구들이 XIX.AI에서 만나보세요! 면접 연습을 위한 이 엄선된 컬렉션은 강력한, 게임 체인저 도구들을 포함하고 있으며, 엄격한 실제 세계 테스트를 거쳐 정확한 피드백을 제공합니다. 무료 대 유료 비교와 상세한 순위표를 찾을 수 있어 자신감과 기술을 향상시킬 수 있는 꼭 시도해봐야 할 옵션을 선택하는 데 도움이 됩니다. 지금 탐색하여 면접 성공을 위한 완벽한 도구를 발견하세요!
12 도구
xix.ai
디자인과 예술
창의적인 실험을 위한 최고의 AI 스타일 변환 도구
2026년 최신, 최고 평점을 받은 창의적 실험을 위한 AI 스타일 변환 도구! XIX.AI는 실제 테스트와 엄격한 평가를 통해 탁월한 결과를 보여주는, 강력하고 판도를 바꿀 만한 ‘꼭 사용해 봐야 할’ 도구들을 엄선했습니다. 이 최고의 솔루션들은 콘텐츠 제작 속도를 높이고 무한한 창의적 가능성을 열어줌으로써 크리에이터들의 생산성을 크게 높여줍니다. 지금 바로 탐색하여 나에게 딱 맞는 도구를 찾아보고, 오늘 바로 창작을 시작해 보세요!
9 도구
xix.ai

 의견 (2)
0/500
![WillieHernández]()
またOpenAIの方針転換...競争が激化する中、安全性と開発速度のバランスって本当に難しいですよね。個人的には過去のChatGPTの制限が緩和された時みたいに、今回もユーザー体験が向上するなら歓迎だけど、やっぱり倫理的基準は守ってほしいな😅 他の企業が危険なAIを出したら同じ土俵に上がる必要性ある?
![PaulTaylor]()
Interesante cómo la competencia puede influir en los estándares de seguridad 😕 No sé si relajar protocolos sea buena idea, pero entiendo la presión del mercado. ¿Hasta qué punto la carrera por la IA está poniendo en riesgo controles importantes?
경쟁 압력 속에서 안전 프로토콜을 조정하는 OpenAI
OpenAI는 개발 주기 전반에 걸쳐 AI 모델 안전성 평가 및 보호 조치 구현을 안내하는 내부 메커니즘인 대비 프레임워크를 수정했습니다. 업데이트된 정책에는 특히 경쟁업체가 동등한 보호 조치 없이 고위험 시스템을 출시할 경우 안전 조치를 완화할 수 있는 조항이 포함되어 있습니다.
이러한 변경은 AI 개발자들이 배포 일정을 앞당기도록 강요하는 시장의 압력이 커지고 있음을 강조합니다. OpenAI는 더 빠른 출시를 위해 안전 우선순위를 낮추고, 안전 평가 문서 공개를 지연하는 등의 의혹에 대한 조사가 강화되고 있습니다. 최근 12명의 전직 직원이 OpenAI를 상대로 제기한 소송을 지지하며, 계획된 기업 구조조정이 안전 기준을 더욱 약화시킬 수 있다고 경고하는 법적 절차를 진행 중입니다.
경쟁과 안전의 균형
비판을 예상한 OpenAI는 어떤 정책 조정이 있더라도 엄격한 보호 수준을 유지할 것이라고 강조했습니다. 화요일 블로그 업데이트에 따르면 "경쟁업체가 유사한 안전장치가 없는 고위험 시스템을 배포하는 경우 요구 사항을 조정할 수 있다"면서도 "철저한 위험 검증, 수정에 대한 투명성, 우수한 보호 조치 유지에 전념할 것"이라고 밝혔습니다.
개정된 프레임워크는 기존의 사람 주도의 테스트와 함께 자동화된 평가 도구에 대한 OpenAI의 의존도가 증가하고 있음을 강조합니다. 회사 관계자들은 이러한 자동화된 시스템을 통해 평가 품질을 저하시키지 않으면서도 출시 속도를 유지할 수 있다고 주장합니다.
논란의 여지가 있는 테스트 관행 등장
내부자 계정을 통해 안전 검토 기간이 압축되었다는 사실이 드러나면서 OpenAI의 공식 입장과 상반되는 보도가 나왔습니다. 파이낸셜 타임즈 소식통에 따르면, 테스터들은 최근 출시가 임박한 모델을 평가하는 데 1주일도 채 걸리지 않아 이전보다 훨씬 짧은 시간을 받았다고 합니다. 공개 배포 버전이 아닌 출시 전 모델 변형에 대한 안전성 테스트가 주로 이루어지고 있다는 우려도 추가로 제기되었습니다.
OpenAI는 조용히 안전에 대한 약속을 줄였습니다.
- 스티븐 애들러 (@sjgadler) April 15, 2025
프레임워크 변경에서 생략:
- 미세 조정된 모델에 대한 안전 테스트 불필요
재정의된 위험 분류 시스템
업데이트된 프레임워크는 두 가지 기능 임계값에 초점을 맞춘 간소화된 모델 분류를 도입합니다:
- 높은 역량: 기존의 심각한 피해 벡터를 증폭시키는 모델
- 중요 역량: 새로운 심각한 피해 경로를 확립하는 모델
"고기능 시스템은 위험을 완화하는 안전장치를 사전 배포해야 합니다."라고 OpenAI는 설명합니다. "중요 역량 모델은 추가적인 개발 단계 보호가 필요합니다."
이는 2023년 이후 프레임워크의 첫 번째 실질적인 개정으로, 진화하는 산업 역학 관계와 OpenAI의 내부 운영 변화를 반영합니다.








 OpenAI, 청소년들이 ChatGPT를 사용하기 시작한 지 수년 만에 더 안전한 버전을 출시했다
AI 챗봇에 안전 프로토콜이 부재하여 청소년 자살 및 기타 정신 건강 위기를 초래했다는 일련의 소송이 제기된 데 이어, 오픈AI는 월요일 ‘ChatGPT for Teens’를 공개했다. 이 새로운 서비스는 강화된 안전 기능을 탑재했으며, 학교에서 AI 도구가 조장하는 학업 부정행위라는 점점 심각해지는 문제도 해결하고자 한다.교육적 관점에서 볼 때, ‘Cha
 프론티어 AI 랩스, 비정상 모델에 대한 통제 전략 공개 거부
최근 연구에 따르면, 선도적인 AI 연구소 중 극소수만이 통제 대응 계획을 발표하거나 시연한 것으로 나타났습니다. 통제 계획은 AI 시스템이 인간의 통제를 무력화하려 할 때의 절차를 정의하며, 어떤 접근 권한이 철회되고 언제 시스템이 완전히 종료되는지를 명시합니다.이러한 결과는 안전한 최첨단 AI 개발 관행을 장려하는 데 주력하는 단체인 ‘Guideligh
 NEA의 티파니 럭: 기업들은 여전히 AI ROI와 씨름하고 있다
플레이어 로딩 중…올초 실리콘밸리에서는 ‘토큰 극대화(tokenmaxxing)’가 주요 화두였으며, 최고경영자들은 직원들에게 AI 활용을 극대화할 것을 독려했습니다. 그러나 이러한 열정은 곧 현실과 부딪혔습니다. 우버(Uber)는 보고에 따라 수개월 만에 연간 AI 예산을 초과했으며, 일부 기업은 부서 전반에 걸쳐 Claude 구독을 축소했고, 메타(Meta)는 내부 성과 평가 제도를 중단했습니다.NEA의 파트너 티파니 럭(Tiffany L

2026년 최신 최고 인기 AI 역할극 채팅 앱: 언어 연습, 면접 준비 및 일상 유창성을 위한 최고의 선택! XIX.AI는 무료와 유료 비교, 실제 테스트, 매주 업데이트되는 순위 등을 제공하는 강력한 혁신적인 컬렉션을 엄선합니다. 이 필수 도구들은 글쓰기 실력을 향상시키고, 유창성 관련 어려움을 극복하며, 모든 일상 상황에서 의사소통 효율성을 높이는 데 도움을 줍니다. 지금 바로 탐색하여 언어 성장을 위한 완벽한 도구를 발견하세요!
10 도구
xix.ai

2026년 최신형으로 선정된 최고 평점의 AI 스템 분리 도구들은 리믹스 제작, 샘플링 준비, 카라오케 녹음에 특화되어 있습니다. 이 강력하고 혁신적인 도구들은 실제 환경에서의 테스트를 거쳐 정밀한 오디오 분리 기능을 제공함으로써 작업 효율성을 크게 향상시켜 줍니다. XIX.AI는 매주 업데이트되는 무료 버전과 유료 버전의 비교 가이드를 제공하여 사용자의 니즈에 가장 적합한 도구를 찾는 데 도움을 줍니다. 지금 바로 확인하여 AI 기술의 잠재력을 최대한 활용해 보세요.
8 도구
xix.ai

2026년 최신 최고의 AI SQL 코파일럿들이 최상위 순위에 올랐습니다! XIX.AI는 매주 업데이트되는 실제 환경 테스트를 위해 강력하고 혁신적인 도구들을 선별하여 제공합니다. 반드시 사용해 보아야 할 이 도구들은 정확한 수익 대시보드를 생성하고, 판매 과정을 분석하며, 제품 관련 지표를 신속하게 추적할 수 있도록 도와 생산성을 크게 향상시켜 줍니다. 데이터 기반 의사결정을 위한 완벽한 도구를 찾아보세요! 238자
9 도구
xix.ai

2026년 최신 최고 인기 AI 멜로디 작곡 도구! XIX.AI는 엄격한 실전 테스트를 거쳐 최고의 작곡 경험을 제공하는 강력한 게임 체인저 컬렉션을 엄선했습니다. 무료와 유료 버전의 상세 비교, 정확한 순위, 그리고 놀라운 노래 초안을 손쉽게 만들고 창의적 생산성을 크게 높일 수 있는 필수 추천 옵션들을 확인할 수 있습니다. 지금 바로 탐색하여 완벽한 도구를 발견하세요!
8 도구
xix.ai

2026년 최신 최고의 평점 높은 AI 대화 트레이너 도구들이 XIX.AI에서 만나보세요! 면접 연습을 위한 이 엄선된 컬렉션은 강력한, 게임 체인저 도구들을 포함하고 있으며, 엄격한 실제 세계 테스트를 거쳐 정확한 피드백을 제공합니다. 무료 대 유료 비교와 상세한 순위표를 찾을 수 있어 자신감과 기술을 향상시킬 수 있는 꼭 시도해봐야 할 옵션을 선택하는 데 도움이 됩니다. 지금 탐색하여 면접 성공을 위한 완벽한 도구를 발견하세요!
12 도구
xix.ai

2026년 최신, 최고 평점을 받은 창의적 실험을 위한 AI 스타일 변환 도구! XIX.AI는 실제 테스트와 엄격한 평가를 통해 탁월한 결과를 보여주는, 강력하고 판도를 바꿀 만한 ‘꼭 사용해 봐야 할’ 도구들을 엄선했습니다. 이 최고의 솔루션들은 콘텐츠 제작 속도를 높이고 무한한 창의적 가능성을 열어줌으로써 크리에이터들의 생산성을 크게 높여줍니다. 지금 바로 탐색하여 나에게 딱 맞는 도구를 찾아보고, 오늘 바로 창작을 시작해 보세요!
9 도구
xix.ai

またOpenAIの方針転換...競争が激化する中、安全性と開発速度のバランスって本当に難しいですよね。個人的には過去のChatGPTの制限が緩和された時みたいに、今回もユーザー体験が向上するなら歓迎だけど、やっぱり倫理的基準は守ってほしいな😅 他の企業が危険なAIを出したら同じ土俵に上がる必要性ある?
Interesante cómo la competencia puede influir en los estándares de seguridad 😕 No sé si relajar protocolos sea buena idea, pero entiendo la presión del mercado. ¿Hasta qué punto la carrera por la IA está poniendo en riesgo controles importantes?












