


 家
Tencent Hunyuanは、PPO強化学習に重要点のサイズ理論を組み込み、スループットを2.29倍に向上させ、GRPOのトレーニング時間を29%削減しました。
大規模なGPUクラスターへのスケールアップや高密度なトレーニングデータセットへの移行に伴い、大規模モデルの強化学習において、トレーニング効率がいかに重要な優先事項であるかが浮上しています。最近の騰訊環元チームによる研究は、しばしば見落とされる課題に焦点を当てています。モデルが自らのトレーニングデータを生成する場合、ロールアウト生成とトレーニングの速度が異なることを踏まえて、バッチサイズをどのように再定義すべきかという問いです。
クリティカルバッチサイズの古典的な理論に基づき、本研究はオンライン大規模言語モデルの強化学習におけるこの概念を再導出しています。その結果は、実用的な解決策を示しています。バッチサイズを増加させる際、特定の範囲内で学習率を調整することで、GRPOおよびPPOの両アルゴリズムが、各応答が薄められることなく効果的に学習することを保証できます。これは、バッチサイズが単に「大きいほど良い」わけでも、固定された値でもないことを示しています。むしろ、最大の効率を実現するために微調整可能な最適な範囲内に存在します。
現実のハードウェアコストへの影響は甚大です。ハードウェア構成が固定されている場合、バッチサイズを増加させることで、PPOの生成スループットを最大2.29倍まで向上させることができます。一方、最適なGRPO構成は、検証目標を29%少ない時間で達成します。GPUリソースに多額の投資を行っているチームにとって、これは同じクラスターでタスクをより速く完了するか、同じ時間枠内でより多くのデータを処理することを意味し、強化学習において最も高価なフェーズのコストを実質的に削減します。
この研究は、モデルが学生であり出題者でもあるオンライン強化学習のスケーリングに対する実用的なレバーを提供します。生成とトレーニングの規模の不整合から生じる効率のギャップを、この研究はクリティカルバッチサイズ理論と学習率の調整を組み合わせることで埋めています。業界が最大規模のモデル構築で競争を繰り広げる中、騰訊環元は既存のハードウェアを最適化し、より費用対効果の高い運用に注力しています。
関連記事
 AIスタートアップが収益成長を加速
確立された企業や新興ベンチャーが人工知能の活用を巡ってしのぎを削る中、多くのAIスタートアップ企業が、収益が単に拡大しているだけでなく、急速に加速し、より短い期間で次のマイルストーンを達成していると報告している。以下のスタートアップ企業は、このフライングホイール成長の一貫したパターンを示している。これらすべての企業が「ARR」という用語を使用しているにもかかわらず、基盤となる指標は企業によって異なることに注意することが重要である。一部の企業は、年間化された継続収益(ARR)、または支払済み顧客
Replitのアムジャド・マサドがCursorの取引、Appleとの闘い、そしてなぜ売却を望まないかについて語る
アムジャド・マサドは過去10年間、Replitの構築に注力してきたが、直近の18ヶ月は変革的な時期であった。AIコーディングプラットフォームの年間収益は2024年の280万ドルから急成長し、マサドが「年間10億ドルの収益率」と表現する軌道に乗っている。木曜夜のサンフランシスコで開催された、完売したTechCrunchのStrictlyVCイベントにおいて、私たちは広範な話題を扱った。まず業界の喫緊の課題から始まった。競合のCursorがSpaceXによって600億ドル規模の買収交渉を行っている
AIエージェントがエビ養殖を強化し、MIITが警告を発し、Rockchipが対応する
AIコミュニティでの議論は「大規模モデルのトレーニング」から「ロブターの飼育」へとシフトしました。もしソーシャルメディアで誰かが「ロブター」のデータ供給やパラメータ調整について話しているのを見かけても、混乱しないでください。彼らは水生生物を養殖しているのではなく、オープンソースのAIエージェント「OpenClaw」を展開しているのです。公式アイコンが赤いロブターであるため、ユーザーはこのプロセスを冗談交じりに「ロブターの飼育」と呼んでいます。なぜこの「ロブター」が一夜にしてこれほど人気があるの
関連特集おすすめ
ファイナンス
 個人投資家向けアナリストに最適なAI投資リサーチツール
XIX.AIが厳選した、個人投資家向けアナリストのための2026年最新・最高評価のAI投資リサーチツール。これらの強力なツールは、コンテンツ作成の加速、執筆効率の向上、分析業務の効率化において画期的なメリットをもたらし、プロフェッショナルがAIの力を最大限に活用できるよう支援します。 無料版と有料版の比較に加え、実地テストや詳細なランキングも掲載しています。今すぐチェックして、あなたにぴったりのツールを見つけましょう!
 11 ツール
 xix.ai
コード
おすすめのAIテスト生成ツール:APIや関数のユニットテストを作成する
2026年最新・最高評価のAPIおよび関数開発向けAIテストジェネレーター。XIX.AIは、厳格な実環境テストを経て正確な結果を提供する、強力で業界に革新をもたらす「必試」ツールを厳選しました。 無料版と有料版の詳細な比較分析や、毎週更新されるランキングをご覧いただけます。今すぐチェックして、あなたにぴったりのツールを見つけ、ソフトウェアテストにおけるAIの優位性を手に入れましょう。
7 ツール
xix.ai
仕事
おすすめのAIビジネスプラン作成ツール:アイデアを投資家向けプレゼン資料の草案に変える
2026年最新の、高評価を誇るAIビジネスプラン作成ツールがXIX.AIに登場!この厳選コレクションには、クリエイターが革新的なアイデアを、洗練された投資家向けプレゼン資料の草案へと迅速にまとめ上げるのに役立つ、業界に革命をもたらす強力なツールが揃っています。 毎週更新されるランキング、無料版と有料版の比較分析、実地テストの結果など、生産性を高め、最高の成果をもたらす「必試」のソリューション選びに役立つ情報が満載です。今すぐチェックして、資金調達を成功させるための最適なツールを発見しましょう!
11 ツール
xix.ai
ファイナンス
QuickBooks、Xero、および複数事業体間の照合に対応したAI請求書OCRプラットフォーム
2026年版:QuickBooks、Xero、および複数事業体の照合に最適なAI請求書OCRプラットフォーム最新ランキング! XIX.AIは、実環境での正確なテストと毎週更新されるランキングに基づき、高評価の強力なツールリストを厳選しています。これらの必見ソリューションは、請求書処理を効率化し、生産性を向上させ、複雑なビジネス環境においても時間を節約します。無料版と有料版の比較を確認して、最適なソリューションを見つけましょう。今すぐチェックして、AIの力を最大限に活用しましょう!
8 ツール
xix.ai
仕事
企業向け提案ワークフローに特化したAI RFP対応ソフトウェア
2026年最新の、企業向け提案ワークフローに最適なAI RFP対応ソフトウェア!XIX.AIは、厳しい実際の運用テストをクリアした優れたツールを厳選してリストアップしており、生産性を向上させ、提案プロセスを効率化するための有用な機能を提供しています。無料版と有料版の比較情報や詳細なランキングを確認し、これら画期的なソリューションがいかにしてより迅速に高品質な回答を作成するのに役立つかをご覧ください。今すぐチェックして、AIによる競争優位を手に入れましょう!
9 ツール
xix.ai
動画作成
AI字幕・吹き替えツール:世界中の視聴者向けに動画をローカライズする
2026年最新・最高評価のAI字幕・吹き替えツール集:世界中の視聴者に向けた動画のローカライズに最適。画期的な精度で、言語の壁を越えてコンテンツのリーチを飛躍的に拡大。実地テストで実証された、ぜひ試すべきソリューションの数々。無料版と有料版の比較や信頼性の高いランキングを通じて、生産性を最大化。今すぐチェックして、グローバルなコンテンツ配信に最適なツールを見つけましょう。
10 ツール
xix.ai

 コメント (0)
0/500
大規模なGPUクラスターへのスケールアップや高密度なトレーニングデータセットへの移行に伴い、大規模モデルの強化学習において、トレーニング効率がいかに重要な優先事項であるかが浮上しています。最近の騰訊環元チームによる研究は、しばしば見落とされる課題に焦点を当てています。モデルが自らのトレーニングデータを生成する場合、ロールアウト生成とトレーニングの速度が異なることを踏まえて、バッチサイズをどのように再定義すべきかという問いです。
クリティカルバッチサイズの古典的な理論に基づき、本研究はオンライン大規模言語モデルの強化学習におけるこの概念を再導出しています。その結果は、実用的な解決策を示しています。バッチサイズを増加させる際、特定の範囲内で学習率を調整することで、GRPOおよびPPOの両アルゴリズムが、各応答が薄められることなく効果的に学習することを保証できます。これは、バッチサイズが単に「大きいほど良い」わけでも、固定された値でもないことを示しています。むしろ、最大の効率を実現するために微調整可能な最適な範囲内に存在します。
現実のハードウェアコストへの影響は甚大です。ハードウェア構成が固定されている場合、バッチサイズを増加させることで、PPOの生成スループットを最大2.29倍まで向上させることができます。一方、最適なGRPO構成は、検証目標を29%少ない時間で達成します。GPUリソースに多額の投資を行っているチームにとって、これは同じクラスターでタスクをより速く完了するか、同じ時間枠内でより多くのデータを処理することを意味し、強化学習において最も高価なフェーズのコストを実質的に削減します。
この研究は、モデルが学生であり出題者でもあるオンライン強化学習のスケーリングに対する実用的なレバーを提供します。生成とトレーニングの規模の不整合から生じる効率のギャップを、この研究はクリティカルバッチサイズ理論と学習率の調整を組み合わせることで埋めています。業界が最大規模のモデル構築で競争を繰り広げる中、騰訊環元は既存のハードウェアを最適化し、より費用対効果の高い運用に注力しています。








 AIスタートアップが収益成長を加速
確立された企業や新興ベンチャーが人工知能の活用を巡ってしのぎを削る中、多くのAIスタートアップ企業が、収益が単に拡大しているだけでなく、急速に加速し、より短い期間で次のマイルストーンを達成していると報告している。以下のスタートアップ企業は、このフライングホイール成長の一貫したパターンを示している。これらすべての企業が「ARR」という用語を使用しているにもかかわらず、基盤となる指標は企業によって異なることに注意することが重要である。一部の企業は、年間化された継続収益(ARR)、または支払済み顧客
 Replitのアムジャド・マサドがCursorの取引、Appleとの闘い、そしてなぜ売却を望まないかについて語る
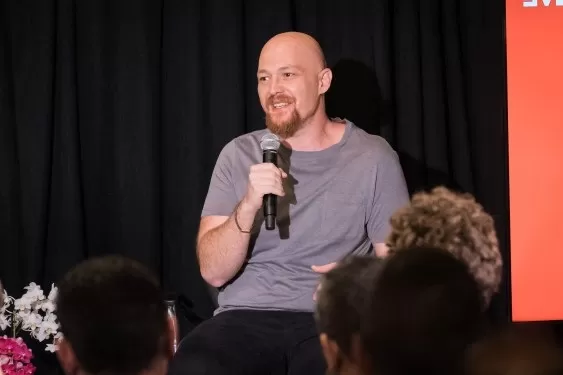
アムジャド・マサドは過去10年間、Replitの構築に注力してきたが、直近の18ヶ月は変革的な時期であった。AIコーディングプラットフォームの年間収益は2024年の280万ドルから急成長し、マサドが「年間10億ドルの収益率」と表現する軌道に乗っている。木曜夜のサンフランシスコで開催された、完売したTechCrunchのStrictlyVCイベントにおいて、私たちは広範な話題を扱った。まず業界の喫緊の課題から始まった。競合のCursorがSpaceXによって600億ドル規模の買収交渉を行っている
 AIエージェントがエビ養殖を強化し、MIITが警告を発し、Rockchipが対応する
AIコミュニティでの議論は「大規模モデルのトレーニング」から「ロブターの飼育」へとシフトしました。もしソーシャルメディアで誰かが「ロブター」のデータ供給やパラメータ調整について話しているのを見かけても、混乱しないでください。彼らは水生生物を養殖しているのではなく、オープンソースのAIエージェント「OpenClaw」を展開しているのです。公式アイコンが赤いロブターであるため、ユーザーはこのプロセスを冗談交じりに「ロブターの飼育」と呼んでいます。なぜこの「ロブター」が一夜にしてこれほど人気があるの
XIX.AIが厳選した、個人投資家向けアナリストのための2026年最新・最高評価のAI投資リサーチツール。これらの強力なツールは、コンテンツ作成の加速、執筆効率の向上、分析業務の効率化において画期的なメリットをもたらし、プロフェッショナルがAIの力を最大限に活用できるよう支援します。 無料版と有料版の比較に加え、実地テストや詳細なランキングも掲載しています。今すぐチェックして、あなたにぴったりのツールを見つけましょう!
11 ツール
xix.ai
2026年最新・最高評価のAPIおよび関数開発向けAIテストジェネレーター。XIX.AIは、厳格な実環境テストを経て正確な結果を提供する、強力で業界に革新をもたらす「必試」ツールを厳選しました。 無料版と有料版の詳細な比較分析や、毎週更新されるランキングをご覧いただけます。今すぐチェックして、あなたにぴったりのツールを見つけ、ソフトウェアテストにおけるAIの優位性を手に入れましょう。
7 ツール
xix.ai
2026年最新の、高評価を誇るAIビジネスプラン作成ツールがXIX.AIに登場!この厳選コレクションには、クリエイターが革新的なアイデアを、洗練された投資家向けプレゼン資料の草案へと迅速にまとめ上げるのに役立つ、業界に革命をもたらす強力なツールが揃っています。 毎週更新されるランキング、無料版と有料版の比較分析、実地テストの結果など、生産性を高め、最高の成果をもたらす「必試」のソリューション選びに役立つ情報が満載です。今すぐチェックして、資金調達を成功させるための最適なツールを発見しましょう!
11 ツール
xix.ai
2026年版:QuickBooks、Xero、および複数事業体の照合に最適なAI請求書OCRプラットフォーム最新ランキング! XIX.AIは、実環境での正確なテストと毎週更新されるランキングに基づき、高評価の強力なツールリストを厳選しています。これらの必見ソリューションは、請求書処理を効率化し、生産性を向上させ、複雑なビジネス環境においても時間を節約します。無料版と有料版の比較を確認して、最適なソリューションを見つけましょう。今すぐチェックして、AIの力を最大限に活用しましょう!
8 ツール
xix.ai
2026年最新の、企業向け提案ワークフローに最適なAI RFP対応ソフトウェア!XIX.AIは、厳しい実際の運用テストをクリアした優れたツールを厳選してリストアップしており、生産性を向上させ、提案プロセスを効率化するための有用な機能を提供しています。無料版と有料版の比較情報や詳細なランキングを確認し、これら画期的なソリューションがいかにしてより迅速に高品質な回答を作成するのに役立つかをご覧ください。今すぐチェックして、AIによる競争優位を手に入れましょう!
9 ツール
xix.ai
2026年最新・最高評価のAI字幕・吹き替えツール集:世界中の視聴者に向けた動画のローカライズに最適。画期的な精度で、言語の壁を越えてコンテンツのリーチを飛躍的に拡大。実地テストで実証された、ぜひ試すべきソリューションの数々。無料版と有料版の比較や信頼性の高いランキングを通じて、生産性を最大化。今すぐチェックして、グローバルなコンテンツ配信に最適なツールを見つけましょう。
10 ツール
xix.ai












