


 家
GPT-5が始動、オープンAIの次世代AIモデルを公開
OpenAIは、次世代のChatGPTを牽引する新しいフラッグシップAIモデルGPT-5を発表しました。
木曜日にリリースされたGPT-5は、OpenAI初の統合AIモデルであり、oシリーズの推論の強みとGPTラインの迅速な応答を融合しています。この次世代モデルは、ChatGPTとOpenAIの新たな章を示すものであり、反応型チャットボットよりも、より積極的なエージェントのように振る舞うAIシステムを構築するという同社の野心を強調するものです。
GPT-4では、AIチャットボットが幅広いトピックにわたってインテリジェントな回答を提供することができましたが、GPT-5では、ソフトウェアアプリケーションの開発、スケジュール管理、調査概要の作成など、ユーザーに代わってChatGPTがタスクを実行できるようになります。
OpenAIはGPT-5でChatGPTをより使いやすくすることにも注力しました。ユーザーが設定を調整する必要がない代わりに、このモデルにはリアルタイム・ルーターが搭載されており、返答に最適な方法(素早く答えるか、時間をかけて推論するか)を判断します。
画像クレジットOpenAI オープンエイのCEOであるサム・アルトマンは記者団とのブリーフィングで、GPT-5を「世界最高のモデル」と評し、経済的に価値のある仕事(人工知能(AGI)としても知られる)において人間を凌駕できるAIの開発に向けた「大きな一歩」だと述べた。
アルトマンは、「GPT-5のようなツールは、歴史のどの時点においても、ほとんど考えられなかっただろう」と付け加えた。
木曜日から、GPT-5はすべての無料ChatGPTユーザーのデフォルトモデルとなる。OpenAIのChatGPT担当副社長、ニック・ターリーによると、この動きによって無料ユーザーは初めてAI推論モデルにアクセスできるようになる。(これまでは、このような高度なモデルは有料会員にのみ提供されていました)。
「これは、我々のミッションを実現する方法の1つであり、これらの進歩が真にすべての人に利益をもたらすことを保証するものです」とターリー氏はコメントし、最先端のAIを広く利用できるようにするというOpenAIのコミットメントに言及した。
テッククランチイベントDisrupt2025アジェンダにテックとVCのトップリーダーが参加
Netflix、ElevenLabs、Wayve、Sequoia CapitalなどがDisrupt 2025のアジェンダに参加する。スタートアップが成長し、競争力を維持するための重要な洞察を共有する。20周年を迎えるTechCrunch Disruptをお見逃しなく。8月7日の値上げ前に、最大675ドルお得な今すぐチケットをお求めください。
TechCrunch Disrupt 2025のアジェンダにテック企業やベンチャーキャピタルのトップが参加
Netflix、ElevenLabs、Wayve、Sequoia Capitalなどの有力企業がDisrupt 2025のアジェンダに参加します。スタートアップ企業が成長し、競争力を維持するための重要な洞察を共有する。20周年を迎えるTechCrunch Disruptをお見逃しなく。チケットは今なら675ドルお得です。
サンフランシスコ|2025年10月27日-29日今すぐ予約するGPT-5への期待は非常に高く、2022年にChatGPTがOpenAIを一躍有名にして以来、OpenAIが最も期待しているローンチの一つです。それ以来、ChatGPTは世界で最も広く利用されているコンシューマー向け製品のひとつとなり、同社によれば、毎週7億人以上のユーザー(世界人口の10%近く)にリーチしている。
GPT-5は、より広範なAIの進歩のための木鐸であると多くの人が見ており、シリコンバレーでの受け入れは、ビッグテック、ウォール街、技術政策立案者に大きな影響を与える可能性がある。関係者は、GPT-5が、ソフトウェアが達成できることを再定義した前身のGPT-4のように、AI能力の大幅な飛躍をもたらすかどうかに注目している。
GPT-5は競合を僅差でリード
OpenAIは、GPT-5がいくつかの分野で新しい標準を設定し、主要なベンチマークでAnthropic、Google DeepMind、イーロン・マスクのxAIの主要モデルをわずかに上回っていると主張している。
同社はGPT-5の卓越したコーディング能力を強調している。アルトマンは、このモデルはオンデマンドで完全なソフトウェア・アプリケーションを生成する能力に優れており、これはしばしば "バイブ・コーディング "と呼ばれる能力だと指摘した。
SWE-benchVerified(GitHubの実際のコーディングタスクに基づくテスト)では、GPT-5は最初のトライで74.9%のスコアを出した。これは、AnthropicのClaude Opus 4.1(74.5%)とGoogle DeepMindのGemini 2.5 Pro(59.6%)をわずかに上回るものだ。
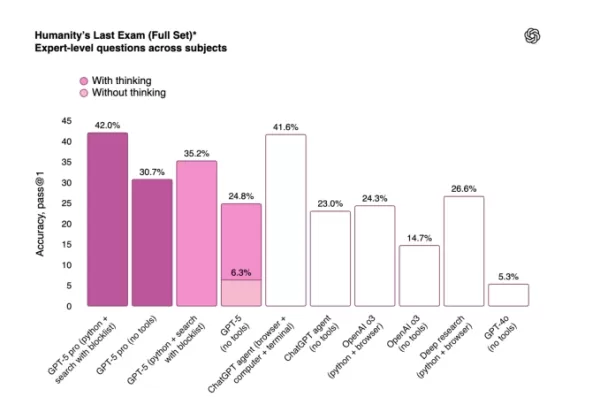
数学、人文科学、科学にまたがる厳格な評価であるHumanity's Last Examにおいて、GPT-5の拡張推論バージョン(GPT-5 Pro)はツールを使用して42%のスコアを獲得した。これは、44.4%を達成したxAIのGrok 4 Heavyをわずかに下回っている。
画像クレジットOpenAI 博士レベルの科学問題のベンチマークであるGPQA Diamondでは、GPT-5 Proは最初の試行で89.4%を獲得し、Claude Opus 4.1(80.9%)とGrok 4 Heavy(88.9%)を上回った。
OpenAIはまた、GPT-5が健康関連の問い合わせでより良いパフォーマンスを示したと報告している。ヘルスケアの回答精度を測定するHealthBench Hard Hallucinationsでは、GPT-5(思考あり)が幻覚を見たのはわずか1.6%で、GPT-4o(12.9%)やo3(15.8%)よりはるかに低かった。
AIチャットボットは医療専門家ではないが、何百万人もの人々が健康アドバイスを求めている。これに対してOpenAIは、GPT-5は潜在的な健康問題にフラグを立て、ユーザーが医療情報を解釈するのを助けることで、より積極的であるとしている。
さらにGPT-5は、クリエイティブなデザインや文章など、より主観的な分野にも優れている。Turley氏は、GPT-5はライバルモデルよりも自然に反応し、創造的なタスクにおいて「より良いセンス」を示すと指摘した。
「このモデルは本当に良い雰囲気を持っている」とターリー氏は述べた。
GPT-5はOpenAIの初期のモデルよりも正確で、幻覚(情報を捏造する傾向)も少ない。幻覚の割合は、o3のような最近の推論モデルで増加しており、OpenAIはこの傾向を説明するのに苦労していた。
応答テストでは、GPT-5(思考あり)は4.8%の確率で誤った情報を提供したが、これはo3(22%)やGPT-4o(20.6%)に比べて顕著な改善であった。
AIエージェントが模擬オンラインタスクを完了する能力を測定するTau-benchでは、GPT-5はさまざまな結果を出した。航空会社のウェブサイトナビゲーションでは63.5%(o3の64.8%をわずかに下回る)、小売サイトのナビゲーションでは81.1%(クロード・オーパス4.1の82.4%を下回る)を記録した。
OpenAIはまた、GPT-5が前世代よりも安全であることも強調している。推論モデルは時に欺瞞的な行動を示すことがあるが、GPT-5は欺瞞の割合が低く、より信頼できるユーザー体験に貢献していることを示した。
安全性研究のリーダーであるアレックス・ボイテルは、欺瞞を減らすことは安全性を向上させるだけでなく、モデルをより "ユーザーが信頼できる方法で透明で正直なものにする "と指摘した。
ボイテル氏は、GPT-5が悪意のある誤用と無害なリクエストの区別に優れているため、安全でないクエリに対してより適切な拒否が行われ、良性のクエリに対して不必要な拒否が少なくなっていると付け加えた。
消費者と開発者向けの新機能
GPT-5のリリースと同時に、ChatGPTはいくつかのユーザーエクスペリエンスのアップグレードを受けています。ユーザーは、設定で4つの新しい応答スタイルから選択できるようになりました:シニック、ロボット、リスナー、オタクです。これらは、明示的な指示を必要とせずにChatGPTのトーンを調整します。
ChatGPTプラス加入者($20/月)は、GPT-5のより高い使用制限を受け、プロ加入者($200/月)は、無制限のアクセスに加えて、GPT-5 Pro-より良い回答のために余分な計算を使用する拡張バージョンを取得します。Team、Edu、Enterpriseの顧客は、来週からGPT-5をデフォルトモデルとして利用できるようになる。
開発者向けには、GPT-5はOpenAIのAPIを通じて、推論の深さが異なる3つのサイズ-gpt-5、gpt-5-mini、gpt-5-nano-で利用可能になります。APIには冗長性コントロールも含まれており、開発者は希望の応答長を設定することができます。
GPT-5の基本モデルは、入力トークン100万個(約75万語)あたり1.25ドル、出力トークン100万個あたり10ドルです。
GPT-5の発売は、OpenAIの多忙な時期に続くものだ。同社は最近、o3やo4-miniのような初期のトップモデルにほぼ匹敵する無料のオープンウェイト推論モデル、gpt-ossをリリースした。しかし、GPT-5はコーディングなどの分野で新たなベンチマークを確立する。
それでも、GPT-5は多くのベンチマークで優位というよりは、競争力を保っている。実際の性能と開発者の採用が、GPT-5が本当にライバルモデルの上に立つかどうかを最終的に決定するでしょう。
関連記事
 OpenAIは、10代の若者がChatGPTを使い始めてから数年を経て、より安全なChatGPTをリリースした
AIチャットボットに安全対策が欠如していたことによる一連の訴訟――これが10代の自殺やその他のメンタルヘルスの危機の一因となった――を受け、OpenAIは月曜日に「ChatGPT for Teens」を発表した。この新サービスには強化された安全機能が組み込まれており、学校現場でAIツールによって助長されている学業上の不正行為という深刻化する問題に対処している。教育的な観点から、「ChatGPT f
フロンティアAIラボ、異常挙動を示すモデルの封じ込め戦略の開示を拒否
最近の調査によると、主要なAI研究所のうち、封じ込め対応計画を公表または実証しているところはごくわずかであることが示されている。封じ込め計画とは、AIシステムが人間の制御を覆そうとした場合の対応手順を定義するもので、どのアクセス権限を取り消すか、またいつシステムを完全にシャットダウンするかを具体的に規定している。この調査結果は、安全な最先端AI開発の実践を推進することに注力する組織「Guideli
NEAのティファニー・ラック:企業はまだAIのROIに苦戦している
プレイヤーを読み込み中…今年初頭、シリコンバレーでは「トークン最大化」が話題を独占し、CEOたちは社員にAIの使用を最大化するよう促した。しかし、その熱狂はすぐに現実とぶつかった。ウーバーは報告によると、数ヶ月で年間AI予算を超過し、一部の企業は部門全体でClaudeのライセンスを削減し、メタは社内パフォーマンスランキングを廃止した。NEAパートナーのティファニー・ラックは、この興奮と実際のリターンのギャップを日々乗り越えている。以前はECが未来であると企業を説得した経験を持つ彼女は、現在、
関連特集おすすめ
デザインとアート
 クリエイティブな実験に最適なAIスタイル転送ツール
2026年版 クリエイティブな実験に最適な、最新・最高評価のAIスタイル転送ツール!XIX.AIは、実地テストと厳格なランキングを通じて卓越した結果をもたらす、強力で画期的な「必試」ツールを厳選しました。これらのトップソリューションは、コンテンツ制作を加速させ、無限の創造的可能性を切り拓くことで、クリエイターの生産性を大幅に向上させます。 今すぐチェックして、あなたにぴったりのツールを見つけ、今日から創作を始めましょう!
 9 ツール
 xix.ai
漫画制作
ビジュアルストーリーテリングに最適なAI吹き出しツール
2026年版、ビジュアルストーリーテリングに最適な高評価AIダイアログバブルツールがXIX.AIに登場!この厳選コレクションには、クリエイターの生産性を高め、創作上のボトルネックを解消する、画期的な強力ツールが揃っています。 無料版と有料版の比較、実地テストの結果、最新のランキングを確認して、魅力的なビジュアルストーリーを構築するのに最適な、ぜひ試すべきソリューションを見つけましょう。今すぐチェックして、あなたにぴったりのツールを発見してください!
10 ツール
xix.ai
ミーティングアシスタント
AI会議要約ツールのトップ選定:決定事項とフォローアップを明確に把握
2026年版:意思決定の追跡を明確にし、フォローアップを容易にする、高評価のAI会議要約ツールベストセレクション。この厳選リストでは、会議メモの自動化、重要なアクション項目の特定、すべてのプロジェクトにわたるチーム連携の効率化を通じて、生産性を劇的に向上させる、強力で画期的なソリューションをご紹介します。 無料版と有料版の比較、実地テストの結果、毎週更新されるランキングを参考に、最適なツールを見つけてください。今すぐチェックして、AIの力を最大限に活用しましょう!
9 ツール
xix.ai
データ分析
最強のAIデータクリーニングツール:欠損値や重複データを迅速に修正
2026年最新かつ最も評価の高いAIデータクリーニングツールをご紹介。欠損値や重複データを迅速に修正できるこれらのツールは、生産性を大幅に向上させる強力なソリューションです。各ツールは信頼性を確保するため、厳格な実環境でのテストを経ています。無料版と有料版の比較情報もご用意しており、あなたのニーズに最も合ったツールを見つけ出せます。今すぐXIX.AIで詳細を確認し、AI活用の強みを最大限に引き出しましょう。
11 ツール
xix.ai
デザインとアート
アーティストのための最高のAIクリエイティブアイディエーションツール:ビジュアルブロックを打破する
2026年最新版・最高評価のAIクリエイティブ発想ツールは、XIX.AIによって厳選され、クリエイターが視覚的な壁を打破し、創造性を即座に高めることを支援します。これらの革新的なツールは、実際のテスト結果、無料版と有料版の詳細比較、そして週次更新されるランキングを提供しています。コンテンツ制作を加速し、AIによる優位性を解き放つための最適なツールを見つけてください。今すぐ探索しましょう!
14 ツール
xix.ai
作曲
TikTokのBGM、Reelsの音声、クリエイター向けプロモーション音楽向けのAIビートメーカー
2026年最新版!TikTokのBGM、Reelsの音声、クリエイター向けプロモーション音楽に最適なAIビートメーカー集!XIX.AIは、あらゆるコンテンツのニーズに応える完璧な音楽を提供するため、実地テストを経て選りすぐられた、画期的な高機能ツールのランキングを厳選しました。 無料版と有料版の詳細な比較データ、毎週更新されるランキング、そして創造性と生産性を高めるためにぜひ試すべきツールが満載です。今すぐチェックして、あなたにぴったりのツールを見つけましょう!
11 ツール
xix.ai

 コメント (1)
0/500
![FrankTaylor]()
So GPT-5 is finally here? I'm curious if it can actually tell the difference between a joke and a serious statement this time around 😅
OpenAIは、次世代のChatGPTを牽引する新しいフラッグシップAIモデルGPT-5を発表しました。
木曜日にリリースされたGPT-5は、OpenAI初の統合AIモデルであり、oシリーズの推論の強みとGPTラインの迅速な応答を融合しています。この次世代モデルは、ChatGPTとOpenAIの新たな章を示すものであり、反応型チャットボットよりも、より積極的なエージェントのように振る舞うAIシステムを構築するという同社の野心を強調するものです。
GPT-4では、AIチャットボットが幅広いトピックにわたってインテリジェントな回答を提供することができましたが、GPT-5では、ソフトウェアアプリケーションの開発、スケジュール管理、調査概要の作成など、ユーザーに代わってChatGPTがタスクを実行できるようになります。
OpenAIはGPT-5でChatGPTをより使いやすくすることにも注力しました。ユーザーが設定を調整する必要がない代わりに、このモデルにはリアルタイム・ルーターが搭載されており、返答に最適な方法(素早く答えるか、時間をかけて推論するか)を判断します。
オープンエイのCEOであるサム・アルトマンは記者団とのブリーフィングで、GPT-5を「世界最高のモデル」と評し、経済的に価値のある仕事(人工知能(AGI)としても知られる)において人間を凌駕できるAIの開発に向けた「大きな一歩」だと述べた。
アルトマンは、「GPT-5のようなツールは、歴史のどの時点においても、ほとんど考えられなかっただろう」と付け加えた。
木曜日から、GPT-5はすべての無料ChatGPTユーザーのデフォルトモデルとなる。OpenAIのChatGPT担当副社長、ニック・ターリーによると、この動きによって無料ユーザーは初めてAI推論モデルにアクセスできるようになる。(これまでは、このような高度なモデルは有料会員にのみ提供されていました)。
「これは、我々のミッションを実現する方法の1つであり、これらの進歩が真にすべての人に利益をもたらすことを保証するものです」とターリー氏はコメントし、最先端のAIを広く利用できるようにするというOpenAIのコミットメントに言及した。
テッククランチイベントDisrupt2025アジェンダにテックとVCのトップリーダーが参加
Netflix、ElevenLabs、Wayve、Sequoia CapitalなどがDisrupt 2025のアジェンダに参加する。スタートアップが成長し、競争力を維持するための重要な洞察を共有する。20周年を迎えるTechCrunch Disruptをお見逃しなく。8月7日の値上げ前に、最大675ドルお得な今すぐチケットをお求めください。
TechCrunch Disrupt 2025のアジェンダにテック企業やベンチャーキャピタルのトップが参加
Netflix、ElevenLabs、Wayve、Sequoia Capitalなどの有力企業がDisrupt 2025のアジェンダに参加します。スタートアップ企業が成長し、競争力を維持するための重要な洞察を共有する。20周年を迎えるTechCrunch Disruptをお見逃しなく。チケットは今なら675ドルお得です。
サンフランシスコ|2025年10月27日-29日今すぐ予約するGPT-5への期待は非常に高く、2022年にChatGPTがOpenAIを一躍有名にして以来、OpenAIが最も期待しているローンチの一つです。それ以来、ChatGPTは世界で最も広く利用されているコンシューマー向け製品のひとつとなり、同社によれば、毎週7億人以上のユーザー(世界人口の10%近く)にリーチしている。
GPT-5は、より広範なAIの進歩のための木鐸であると多くの人が見ており、シリコンバレーでの受け入れは、ビッグテック、ウォール街、技術政策立案者に大きな影響を与える可能性がある。関係者は、GPT-5が、ソフトウェアが達成できることを再定義した前身のGPT-4のように、AI能力の大幅な飛躍をもたらすかどうかに注目している。
GPT-5は競合を僅差でリード
OpenAIは、GPT-5がいくつかの分野で新しい標準を設定し、主要なベンチマークでAnthropic、Google DeepMind、イーロン・マスクのxAIの主要モデルをわずかに上回っていると主張している。
同社はGPT-5の卓越したコーディング能力を強調している。アルトマンは、このモデルはオンデマンドで完全なソフトウェア・アプリケーションを生成する能力に優れており、これはしばしば "バイブ・コーディング "と呼ばれる能力だと指摘した。
SWE-benchVerified(GitHubの実際のコーディングタスクに基づくテスト)では、GPT-5は最初のトライで74.9%のスコアを出した。これは、AnthropicのClaude Opus 4.1(74.5%)とGoogle DeepMindのGemini 2.5 Pro(59.6%)をわずかに上回るものだ。
数学、人文科学、科学にまたがる厳格な評価であるHumanity's Last Examにおいて、GPT-5の拡張推論バージョン(GPT-5 Pro)はツールを使用して42%のスコアを獲得した。これは、44.4%を達成したxAIのGrok 4 Heavyをわずかに下回っている。
博士レベルの科学問題のベンチマークであるGPQA Diamondでは、GPT-5 Proは最初の試行で89.4%を獲得し、Claude Opus 4.1(80.9%)とGrok 4 Heavy(88.9%)を上回った。
OpenAIはまた、GPT-5が健康関連の問い合わせでより良いパフォーマンスを示したと報告している。ヘルスケアの回答精度を測定するHealthBench Hard Hallucinationsでは、GPT-5(思考あり)が幻覚を見たのはわずか1.6%で、GPT-4o(12.9%)やo3(15.8%)よりはるかに低かった。
AIチャットボットは医療専門家ではないが、何百万人もの人々が健康アドバイスを求めている。これに対してOpenAIは、GPT-5は潜在的な健康問題にフラグを立て、ユーザーが医療情報を解釈するのを助けることで、より積極的であるとしている。
さらにGPT-5は、クリエイティブなデザインや文章など、より主観的な分野にも優れている。Turley氏は、GPT-5はライバルモデルよりも自然に反応し、創造的なタスクにおいて「より良いセンス」を示すと指摘した。
「このモデルは本当に良い雰囲気を持っている」とターリー氏は述べた。
GPT-5はOpenAIの初期のモデルよりも正確で、幻覚(情報を捏造する傾向)も少ない。幻覚の割合は、o3のような最近の推論モデルで増加しており、OpenAIはこの傾向を説明するのに苦労していた。
応答テストでは、GPT-5(思考あり)は4.8%の確率で誤った情報を提供したが、これはo3(22%)やGPT-4o(20.6%)に比べて顕著な改善であった。
AIエージェントが模擬オンラインタスクを完了する能力を測定するTau-benchでは、GPT-5はさまざまな結果を出した。航空会社のウェブサイトナビゲーションでは63.5%(o3の64.8%をわずかに下回る)、小売サイトのナビゲーションでは81.1%(クロード・オーパス4.1の82.4%を下回る)を記録した。
OpenAIはまた、GPT-5が前世代よりも安全であることも強調している。推論モデルは時に欺瞞的な行動を示すことがあるが、GPT-5は欺瞞の割合が低く、より信頼できるユーザー体験に貢献していることを示した。
安全性研究のリーダーであるアレックス・ボイテルは、欺瞞を減らすことは安全性を向上させるだけでなく、モデルをより "ユーザーが信頼できる方法で透明で正直なものにする "と指摘した。
ボイテル氏は、GPT-5が悪意のある誤用と無害なリクエストの区別に優れているため、安全でないクエリに対してより適切な拒否が行われ、良性のクエリに対して不必要な拒否が少なくなっていると付け加えた。
消費者と開発者向けの新機能
GPT-5のリリースと同時に、ChatGPTはいくつかのユーザーエクスペリエンスのアップグレードを受けています。ユーザーは、設定で4つの新しい応答スタイルから選択できるようになりました:シニック、ロボット、リスナー、オタクです。これらは、明示的な指示を必要とせずにChatGPTのトーンを調整します。
ChatGPTプラス加入者($20/月)は、GPT-5のより高い使用制限を受け、プロ加入者($200/月)は、無制限のアクセスに加えて、GPT-5 Pro-より良い回答のために余分な計算を使用する拡張バージョンを取得します。Team、Edu、Enterpriseの顧客は、来週からGPT-5をデフォルトモデルとして利用できるようになる。
開発者向けには、GPT-5はOpenAIのAPIを通じて、推論の深さが異なる3つのサイズ-gpt-5、gpt-5-mini、gpt-5-nano-で利用可能になります。APIには冗長性コントロールも含まれており、開発者は希望の応答長を設定することができます。
GPT-5の基本モデルは、入力トークン100万個(約75万語)あたり1.25ドル、出力トークン100万個あたり10ドルです。
GPT-5の発売は、OpenAIの多忙な時期に続くものだ。同社は最近、o3やo4-miniのような初期のトップモデルにほぼ匹敵する無料のオープンウェイト推論モデル、gpt-ossをリリースした。しかし、GPT-5はコーディングなどの分野で新たなベンチマークを確立する。
それでも、GPT-5は多くのベンチマークで優位というよりは、競争力を保っている。実際の性能と開発者の採用が、GPT-5が本当にライバルモデルの上に立つかどうかを最終的に決定するでしょう。








 OpenAIは、10代の若者がChatGPTを使い始めてから数年を経て、より安全なChatGPTをリリースした
AIチャットボットに安全対策が欠如していたことによる一連の訴訟――これが10代の自殺やその他のメンタルヘルスの危機の一因となった――を受け、OpenAIは月曜日に「ChatGPT for Teens」を発表した。この新サービスには強化された安全機能が組み込まれており、学校現場でAIツールによって助長されている学業上の不正行為という深刻化する問題に対処している。教育的な観点から、「ChatGPT f
 フロンティアAIラボ、異常挙動を示すモデルの封じ込め戦略の開示を拒否
最近の調査によると、主要なAI研究所のうち、封じ込め対応計画を公表または実証しているところはごくわずかであることが示されている。封じ込め計画とは、AIシステムが人間の制御を覆そうとした場合の対応手順を定義するもので、どのアクセス権限を取り消すか、またいつシステムを完全にシャットダウンするかを具体的に規定している。この調査結果は、安全な最先端AI開発の実践を推進することに注力する組織「Guideli
 NEAのティファニー・ラック:企業はまだAIのROIに苦戦している
プレイヤーを読み込み中…今年初頭、シリコンバレーでは「トークン最大化」が話題を独占し、CEOたちは社員にAIの使用を最大化するよう促した。しかし、その熱狂はすぐに現実とぶつかった。ウーバーは報告によると、数ヶ月で年間AI予算を超過し、一部の企業は部門全体でClaudeのライセンスを削減し、メタは社内パフォーマンスランキングを廃止した。NEAパートナーのティファニー・ラックは、この興奮と実際のリターンのギャップを日々乗り越えている。以前はECが未来であると企業を説得した経験を持つ彼女は、現在、

2026年版 クリエイティブな実験に最適な、最新・最高評価のAIスタイル転送ツール!XIX.AIは、実地テストと厳格なランキングを通じて卓越した結果をもたらす、強力で画期的な「必試」ツールを厳選しました。これらのトップソリューションは、コンテンツ制作を加速させ、無限の創造的可能性を切り拓くことで、クリエイターの生産性を大幅に向上させます。 今すぐチェックして、あなたにぴったりのツールを見つけ、今日から創作を始めましょう!
9 ツール
xix.ai

2026年版、ビジュアルストーリーテリングに最適な高評価AIダイアログバブルツールがXIX.AIに登場!この厳選コレクションには、クリエイターの生産性を高め、創作上のボトルネックを解消する、画期的な強力ツールが揃っています。 無料版と有料版の比較、実地テストの結果、最新のランキングを確認して、魅力的なビジュアルストーリーを構築するのに最適な、ぜひ試すべきソリューションを見つけましょう。今すぐチェックして、あなたにぴったりのツールを発見してください!
10 ツール
xix.ai

2026年版:意思決定の追跡を明確にし、フォローアップを容易にする、高評価のAI会議要約ツールベストセレクション。この厳選リストでは、会議メモの自動化、重要なアクション項目の特定、すべてのプロジェクトにわたるチーム連携の効率化を通じて、生産性を劇的に向上させる、強力で画期的なソリューションをご紹介します。 無料版と有料版の比較、実地テストの結果、毎週更新されるランキングを参考に、最適なツールを見つけてください。今すぐチェックして、AIの力を最大限に活用しましょう!
9 ツール
xix.ai

2026年最新かつ最も評価の高いAIデータクリーニングツールをご紹介。欠損値や重複データを迅速に修正できるこれらのツールは、生産性を大幅に向上させる強力なソリューションです。各ツールは信頼性を確保するため、厳格な実環境でのテストを経ています。無料版と有料版の比較情報もご用意しており、あなたのニーズに最も合ったツールを見つけ出せます。今すぐXIX.AIで詳細を確認し、AI活用の強みを最大限に引き出しましょう。
11 ツール
xix.ai

2026年最新版・最高評価のAIクリエイティブ発想ツールは、XIX.AIによって厳選され、クリエイターが視覚的な壁を打破し、創造性を即座に高めることを支援します。これらの革新的なツールは、実際のテスト結果、無料版と有料版の詳細比較、そして週次更新されるランキングを提供しています。コンテンツ制作を加速し、AIによる優位性を解き放つための最適なツールを見つけてください。今すぐ探索しましょう!
14 ツール
xix.ai

2026年最新版!TikTokのBGM、Reelsの音声、クリエイター向けプロモーション音楽に最適なAIビートメーカー集!XIX.AIは、あらゆるコンテンツのニーズに応える完璧な音楽を提供するため、実地テストを経て選りすぐられた、画期的な高機能ツールのランキングを厳選しました。 無料版と有料版の詳細な比較データ、毎週更新されるランキング、そして創造性と生産性を高めるためにぜひ試すべきツールが満載です。今すぐチェックして、あなたにぴったりのツールを見つけましょう!
11 ツール
xix.ai

So GPT-5 is finally here? I'm curious if it can actually tell the difference between a joke and a serious statement this time around 😅












