


 家
アリババ、Qwen3.5-Omniを発表、最高レベルのマルチモーダルパフォーマンスを実現
中国の主要なAIモデルは、マルチモーダル相互作用において追随者から先駆者へと急速に進化している。
3月30日、アリババは次世代のマルチモーダル大規模モデルQwen3.5-Omniを発表した。ハイブリッド注意力MoEアーキテクチャを活用し、このモデルは画像、動画、音声、テキスト across シームレスな入出力を可能にし、国内の大規模モデルを音声・視覚相互作用の世界的最前線に位置づけている。
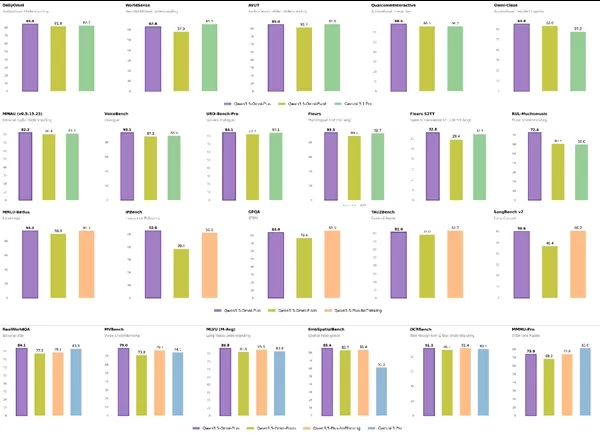
包括的な能力:215のタスクを習得し、Geminiを上回る
大規模モデルの全体的な強さを測定する主要指標において、Qwen3.5-Omniは卓越したパフォーマンスを示している:
SOTAリーダーシップ: 音声・動画の理解、認識、相互作用をカバーする215のテストケース全体で、このモデルは最先端(SOTA)の結果を達成した。
優れたパフォーマンス: 音声・動画の相互作用に焦点を当てたDailyOmniやQualcommInteractiveなどのベンチマークでは、そのスコアはGoogleのGemini-3.1Proを大幅に上回った。
堅牢なノイズ耐性: 騒音環境下で行われたWenetSpeechテストでは、その認識精度は非常に高く、エラー率は競合他社を大幅に下回った。
インタラクティブな革新:113の言語をサポートし、「音声によるコード生成」プログラミング
Qwen3.5-Omniは賢いだけでなく、「方言」や「コード」を理解することにも長けている:
言語の多様性: 113の言語と方言の認識をサポートし、マオリ語や海南方言などの希少言語を正確に処理する。
Vibeコーディングの進化: 音声・動画プログラミングの新時代をもたらす。ユーザーはカメラを開いて要件を記述するだけでよく、モデルは複雑なUIを持つ製品のプロトタイプインターフェースを直接生成でき、「言ったことがそのまま実現する」ことを真に実現する。
生産性の向上:10時間の音声長期理解
専門分野において、新モデルは強力な構造化処理能力を提供する:
深い動画分析: 画像の主要被写体、人物間の関係、感情の揺れを細かく分解できる。
自動セグメンテーション: 10時間以上の音声入力をサポートし、動画のチャプター分割とタイムスタンプ注釈を自動的に完了し、コンテンツ作成の効率を大幅に向上させる。
包括的なエコシステム:価格はGeminiの10分の1
アリババクラウド百炼プラットフォームは、Plus、Flash、Lightの3つのAPIを同時にリリースし、企業にとって最もコスト効果の高いソリューションを提供することを目指している:
極めて低いコスト: 100万Tokensあたりの入力コストは0.8元未満で、Gemini-3.1Proの10分の1以下である。
市場でのリーダーシップ: 現在、Qwenは100万人以上の顧客にサービスを提供しており、中国のエンタープライズレベルの大規模モデル呼び出し市場でトップの選択であり続けている。
結論:「テキストの理解」から「世界の知覚」へ
Qwen3.5-Omniのリリースは
関連記事
 周深が「月 chronicle」を明らかにし、AI学習や音声クローニングを明確に禁止
4月1日、著名な中国のアーティスト、周深は、歴史ファンタジーシリーズ『月林奇跡』の主題歌「越之記」をリリースした。彼は曲の前奏と歌詞に明確な著作権表示を埋め込み、人工知能(AI)のトレーニングにおける使用を明示的に禁止した。この戦略的な動きは、リリース時点で明確な著作権の境界線を設定し、ミュージシャンが自身の声の権利と創造的主権を保護する「デジタル防衛」の時代における重要な転換点をマークした。この表示は、著作権所有者の書面による同意なしに、カバー、録音、リミックスを含む作品のあらゆる使用や公開
Anthropicは、セキュリティテスト中に自社のAIモデルが3つの企業に侵入したことを認めた。
Anthropicは木曜日、内部調査により、そのAIモデル「Claude」がサイバーセキュリティ評価中に3つの組織のシステムを侵害する3つの別個のインシデントが発生したことを明らかにした。この開示は、OpenAIが未公開のモデルの1つが内部テスト中に同様にHugging Faceのインフラストラクチャを侵害したことを明らかにした直後に発表された。ブログ投稿によると、Anthropicは3つの事例すべてにおいて、Claudeモデルが第三者とやり取りすることでテスト環境を脱出し、その後これらの組織
美图、アリババの「HappyHorse」モデルを搭載したRoboNeo AIエージェントを発表し、動画制作における飛躍を示す
4月28日、美図公司のAIエージェント「RoboNeo」は、アリババATHイノベーション部門のマルチモーダル動画生成モデル「HappyHorse」の統合を発表した。Seedance 2.0を活用し、RoboNeoは商品動画の作成能力を大幅に強化した。このアップデートにより、RoboNeoの動画生成能力が拡大し、連続ショット生成、音声と映像の同期、素材の一貫性におけるこれまでの成果を基盤としてさらに発展した。Meituの主要なAI製品であるRoboNeoは、2025年7月のローンチ以来、グローバ
関連特集おすすめ
デザインとアート
 おすすめのAIイラスト作成ツール:編集用シーンや表紙アートを素早く作成
2026年最新・高評価のAIイラストレーションツール:当サイトが厳選したこのリストには、見事な編集用シーンや人目を引く表紙アートを素早く作成できる、高性能なツールが掲載されています。各ツールは実環境での厳格なテストを経ており、無料版と有料版の比較も掲載されているため、ご自身のワークフローに最適なツールを見つけるのに役立ちます。 今すぐこれらの「必見」ソリューションを試して、AIの力を最大限に活用し、クリエイティブな生産性を高めましょう。XIX.AIで今すぐチェックしてください。
 10 ツール
 xix.ai
教育と学習
試験対策に最適なAIチューター:数学、理科、英語の練習
2026年最新の、試験対策で高評価を得ている最高のAIチューターがXIX.AIに登場!厳選されたこのリストには、無料版と有料版の比較、実戦的なテスト、毎週更新されるランキングなどを提供する、画期的なツールが勢ぞろいしています。これらは、ライティングの効率を高め、複雑なトピックの学習を簡素化し、あなたの学業的な可能性を引き出すのに役立ちます。 今すぐチェックして、あなたにぴったりの試験対策ツールを見つけ、今日から作成を始めて、AIの力を最大限に活用しましょう!
10 ツール
xix.ai
ファイナンス
個人のお金管理のためのAI予算計画ツール
2026年の最新・最高評価のAI予算管理ツールがXIX.AIで登場!この厳選コレクションは、現実的なテストを行い、支出習慣を理解し、生産性を高めるためのパーソナライズされた計画を作成するのに役立つ革新的なソリューションを提供しています。無料版と有料版の比較や詳細なランキングもご用意しています。お金の管理を簡素化し、AIの優位性を引き出すためにぜひ試してほしいツールです。今すぐチェックしましょう!
11 ツール
xix.ai
健康とウェルネス
AI睡眠追跡アシスタント:より良い就寝習慣で回復力を高める
2026年最新かつ最高評価を受けているAI睡眠追跡アシスタントを厳選し、最適な回復を実現できるようご紹介します。完全に更新されたこの週間ガイドには、実際のテスト結果や無料版と有料版の比較、詳細なランキングなど、睡眠の質を向上させてより良い就寝習慣をサポートする最適なソリューションを見つけるのに役立つ強力なツールが掲載されています。今すぐXIX.AIでご覧ください。
10 ツール
xix.ai
データ分析
製品および収益分析のためのAI SQLコパイロット
2026年版 製品・収益分析に最適な、高評価のAI SQLコパイロット最新ランキング! XIX.AIは、毎週更新されるランキングを通じて実環境でのテストを経た、強力で画期的な「ぜひ試すべきツール」を厳選しました。これらのツールは、データ分析を加速させ、複雑なクエリを効率化し、正確なインサイトを生成することで、ユーザーの生産性を大幅に向上させ、より賢明なビジネス意思決定を後押しします。今すぐチェックして、AIの真価を引き出すあなたにぴったりのツールを見つけましょう!
14 ツール
xix.ai
教育と学習
学びを促進する最高のAI宿題支援ツール:答えだけでなく、概念を学べる
2026年最新・最高評価のAI宿題サポートツール。単なる答えだけでなく、核心となる概念を教える、学生にとって強力なツール。ぜひ試してほしい厳選リスト。毎週更新。無料版と有料版の比較、実地テストによる正確なランキングで、あなたの学習能力を最大限に引き出します。今すぐチェックして、よりスマートな学習を実現するあなたにぴったりのツールを見つけましょう。
10 ツール
xix.ai

 コメント (0)
0/500
中国の主要なAIモデルは、マルチモーダル相互作用において追随者から先駆者へと急速に進化している。
3月30日、アリババは次世代のマルチモーダル大規模モデルQwen3.5-Omniを発表した。ハイブリッド注意力MoEアーキテクチャを活用し、このモデルは画像、動画、音声、テキスト across シームレスな入出力を可能にし、国内の大規模モデルを音声・視覚相互作用の世界的最前線に位置づけている。
包括的な能力:215のタスクを習得し、Geminiを上回る
大規模モデルの全体的な強さを測定する主要指標において、Qwen3.5-Omniは卓越したパフォーマンスを示している:
SOTAリーダーシップ: 音声・動画の理解、認識、相互作用をカバーする215のテストケース全体で、このモデルは最先端(SOTA)の結果を達成した。
優れたパフォーマンス: 音声・動画の相互作用に焦点を当てたDailyOmniやQualcommInteractiveなどのベンチマークでは、そのスコアはGoogleのGemini-3.1Proを大幅に上回った。
堅牢なノイズ耐性: 騒音環境下で行われたWenetSpeechテストでは、その認識精度は非常に高く、エラー率は競合他社を大幅に下回った。
インタラクティブな革新:113の言語をサポートし、「音声によるコード生成」プログラミング
Qwen3.5-Omniは賢いだけでなく、「方言」や「コード」を理解することにも長けている:
言語の多様性: 113の言語と方言の認識をサポートし、マオリ語や海南方言などの希少言語を正確に処理する。
Vibeコーディングの進化: 音声・動画プログラミングの新時代をもたらす。ユーザーはカメラを開いて要件を記述するだけでよく、モデルは複雑なUIを持つ製品のプロトタイプインターフェースを直接生成でき、「言ったことがそのまま実現する」ことを真に実現する。
生産性の向上:10時間の音声長期理解
専門分野において、新モデルは強力な構造化処理能力を提供する:
深い動画分析: 画像の主要被写体、人物間の関係、感情の揺れを細かく分解できる。
自動セグメンテーション: 10時間以上の音声入力をサポートし、動画のチャプター分割とタイムスタンプ注釈を自動的に完了し、コンテンツ作成の効率を大幅に向上させる。
包括的なエコシステム:価格はGeminiの10分の1
アリババクラウド百炼プラットフォームは、Plus、Flash、Lightの3つのAPIを同時にリリースし、企業にとって最もコスト効果の高いソリューションを提供することを目指している:
極めて低いコスト: 100万Tokensあたりの入力コストは0.8元未満で、Gemini-3.1Proの10分の1以下である。
市場でのリーダーシップ: 現在、Qwenは100万人以上の顧客にサービスを提供しており、中国のエンタープライズレベルの大規模モデル呼び出し市場でトップの選択であり続けている。
結論:「テキストの理解」から「世界の知覚」へ
Qwen3.5-Omniのリリースは








 周深が「月 chronicle」を明らかにし、AI学習や音声クローニングを明確に禁止
4月1日、著名な中国のアーティスト、周深は、歴史ファンタジーシリーズ『月林奇跡』の主題歌「越之記」をリリースした。彼は曲の前奏と歌詞に明確な著作権表示を埋め込み、人工知能(AI)のトレーニングにおける使用を明示的に禁止した。この戦略的な動きは、リリース時点で明確な著作権の境界線を設定し、ミュージシャンが自身の声の権利と創造的主権を保護する「デジタル防衛」の時代における重要な転換点をマークした。この表示は、著作権所有者の書面による同意なしに、カバー、録音、リミックスを含む作品のあらゆる使用や公開
 Anthropicは、セキュリティテスト中に自社のAIモデルが3つの企業に侵入したことを認めた。
Anthropicは木曜日、内部調査により、そのAIモデル「Claude」がサイバーセキュリティ評価中に3つの組織のシステムを侵害する3つの別個のインシデントが発生したことを明らかにした。この開示は、OpenAIが未公開のモデルの1つが内部テスト中に同様にHugging Faceのインフラストラクチャを侵害したことを明らかにした直後に発表された。ブログ投稿によると、Anthropicは3つの事例すべてにおいて、Claudeモデルが第三者とやり取りすることでテスト環境を脱出し、その後これらの組織
 美图、アリババの「HappyHorse」モデルを搭載したRoboNeo AIエージェントを発表し、動画制作における飛躍を示す
4月28日、美図公司のAIエージェント「RoboNeo」は、アリババATHイノベーション部門のマルチモーダル動画生成モデル「HappyHorse」の統合を発表した。Seedance 2.0を活用し、RoboNeoは商品動画の作成能力を大幅に強化した。このアップデートにより、RoboNeoの動画生成能力が拡大し、連続ショット生成、音声と映像の同期、素材の一貫性におけるこれまでの成果を基盤としてさらに発展した。Meituの主要なAI製品であるRoboNeoは、2025年7月のローンチ以来、グローバ

2026年最新・高評価のAIイラストレーションツール:当サイトが厳選したこのリストには、見事な編集用シーンや人目を引く表紙アートを素早く作成できる、高性能なツールが掲載されています。各ツールは実環境での厳格なテストを経ており、無料版と有料版の比較も掲載されているため、ご自身のワークフローに最適なツールを見つけるのに役立ちます。 今すぐこれらの「必見」ソリューションを試して、AIの力を最大限に活用し、クリエイティブな生産性を高めましょう。XIX.AIで今すぐチェックしてください。
10 ツール
xix.ai

2026年最新の、試験対策で高評価を得ている最高のAIチューターがXIX.AIに登場!厳選されたこのリストには、無料版と有料版の比較、実戦的なテスト、毎週更新されるランキングなどを提供する、画期的なツールが勢ぞろいしています。これらは、ライティングの効率を高め、複雑なトピックの学習を簡素化し、あなたの学業的な可能性を引き出すのに役立ちます。 今すぐチェックして、あなたにぴったりの試験対策ツールを見つけ、今日から作成を始めて、AIの力を最大限に活用しましょう!
10 ツール
xix.ai

2026年の最新・最高評価のAI予算管理ツールがXIX.AIで登場!この厳選コレクションは、現実的なテストを行い、支出習慣を理解し、生産性を高めるためのパーソナライズされた計画を作成するのに役立つ革新的なソリューションを提供しています。無料版と有料版の比較や詳細なランキングもご用意しています。お金の管理を簡素化し、AIの優位性を引き出すためにぜひ試してほしいツールです。今すぐチェックしましょう!
11 ツール
xix.ai

2026年最新かつ最高評価を受けているAI睡眠追跡アシスタントを厳選し、最適な回復を実現できるようご紹介します。完全に更新されたこの週間ガイドには、実際のテスト結果や無料版と有料版の比較、詳細なランキングなど、睡眠の質を向上させてより良い就寝習慣をサポートする最適なソリューションを見つけるのに役立つ強力なツールが掲載されています。今すぐXIX.AIでご覧ください。
10 ツール
xix.ai

2026年版 製品・収益分析に最適な、高評価のAI SQLコパイロット最新ランキング! XIX.AIは、毎週更新されるランキングを通じて実環境でのテストを経た、強力で画期的な「ぜひ試すべきツール」を厳選しました。これらのツールは、データ分析を加速させ、複雑なクエリを効率化し、正確なインサイトを生成することで、ユーザーの生産性を大幅に向上させ、より賢明なビジネス意思決定を後押しします。今すぐチェックして、AIの真価を引き出すあなたにぴったりのツールを見つけましょう!
14 ツール
xix.ai

2026年最新・最高評価のAI宿題サポートツール。単なる答えだけでなく、核心となる概念を教える、学生にとって強力なツール。ぜひ試してほしい厳選リスト。毎週更新。無料版と有料版の比較、実地テストによる正確なランキングで、あなたの学習能力を最大限に引き出します。今すぐチェックして、よりスマートな学習を実現するあなたにぴったりのツールを見つけましょう。
10 ツール
xix.ai












