


 Maison
La gamme Xiaomi MiMo-V2.5 bénéficie d'une baisse de prix définitive, avec jusqu'à 99 % de réduction
Alors que la guerre des prix entre les modèles d'IA s'intensifie, Xiaomi a officiellement annoncé le 27 mai que son grand modèle MiMo allait baisser de manière permanente les tarifs de l'API de la série MiMo-V2.5, tout en optimisant le système de facturation afin de réduire encore davantage les coûts d'appel pour les développeurs grâce à des avancées technologiques.
I. Baisses de prix significatives des API — Jusqu'à 99 % de réduction
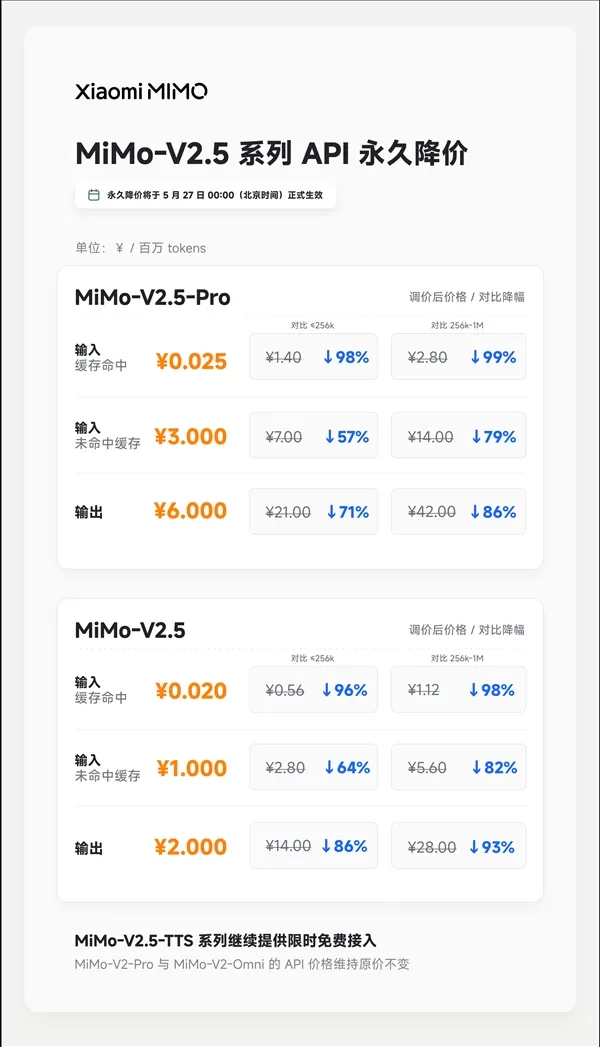
La modification des tarifs est entrée en vigueur à l'échelle mondiale à 00 h 00, heure de Pékin, le 27 mai. Elle s'applique aux deux versions principales, MiMo-V2.5 et MiMo-V2.5Pro, et ne fait plus de distinction en fonction de la longueur de la fenêtre de contexte, ce qui simplifie la structure tarifaire pour une plus grande transparence.
Version du modèle Prix en cas d'accès au cache d'entrée Remise maximale Prix de sortie Remise maximaleMiMo-V2.5Pro0,025 yuan par million de jetons, jusqu'à 99 % de réduction ; sortie : 6 yuans par million de jetons, jusqu'à 86 % de réduction MiMo-V2.5 0,02 yuan par million de jetons, jusqu'à 98 % de réduction ; sortie : 2 yuans par million de jetons, jusqu'à 93 % de réductionII. Mise à niveau du système de facturation — Plus de valeur sans frais supplémentaires
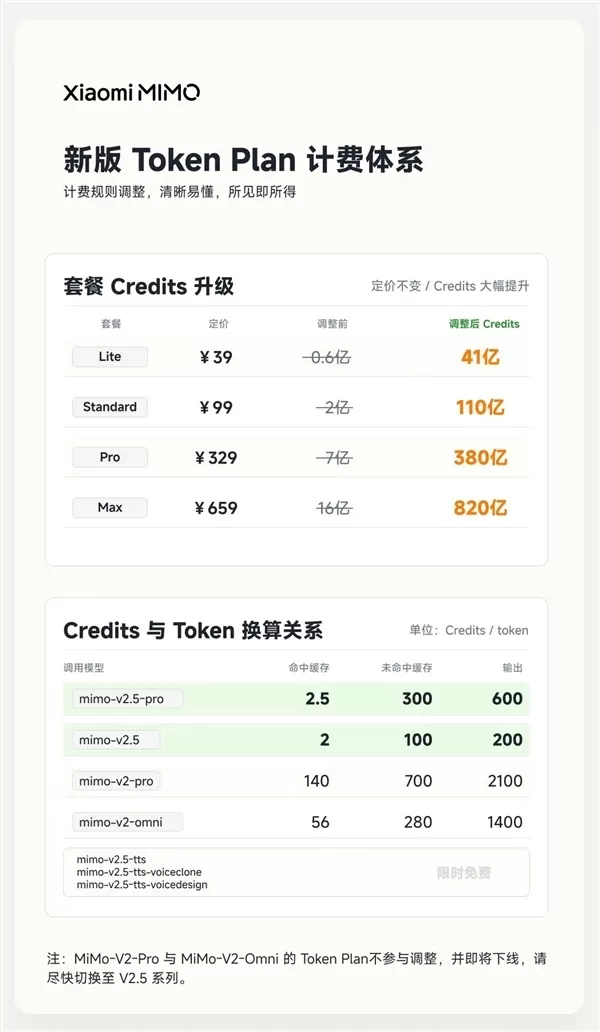
Au-delà des baisses de prix directes sur l'API, Xiaomi a considérablement optimisé son système de facturation Token Plan :
Quota quadruplé : par rapport à la tarification initiale, le quota d'utilisation réel de jetons a été multiplié par 5 à 8.
Règles simplifiées : l'introduction des crédits remplace les anciennes méthodes de facturation complexes, rendant la consommation de jetons et le calcul des coûts plus intuitifs pour les développeurs.
III. Fondements techniques — Comment peut-on continuer à baisser les prix ?
Le communiqué officiel de Xiaomi attribue ces baisses de prix importantes à des avancées techniques dans l'architecture de son système d'inférence sous-jacent :
Optimisation de l'inférence SWA : en tirant parti de SGLang HiCache avec une prise en charge complète du SWA (Sliding Window Attention Mechanism), le transfert de données entre la mémoire du GPU, la mémoire du CPU et le SSD a été réduit à un septième du volume précédent.
Efficacité du cache améliorée : le nombre de tokens pouvant être mis en cache a été multiplié par près de cinq par rapport à la version optimisée précédente, ce qui a permis d'augmenter les taux de réussite du cache et de réduire considérablement le coût par inférence.
Optimisation du débit du cluster : grâce à l'introduction de stratégies de parallélisme expert (MoE) et de regroupement par longueur d'entrée, le débit d'entrée du cluster a fait un bond qualitatif, maintenant une qualité de service élevée tout en réduisant progressivement le coût par token.
L'initiative de Xiaomi est considérée comme une réponse proactive à la concurrence intense qui règne actuellement dans la commercialisation des grands modèles. À mesure que les barrières de prix continuent de baisser, le rapport coût-efficacité de la série MiMo deviendra encore plus prononcé, accélérant l'intégration en profondeur des capacités d'IA dans les secteurs verticaux et les flux de travail des développeurs.
Article connexe
 Stripe va acquérir OpenRouter alors que le routage basé sur des modèles d'IA prend de l'ampleur
Stripe a conclu un accord en vue d’acquérir OpenRouter, une plateforme de routage de modèles d’IA qui permet aux développeurs d’accéder à des centaines de modèles via une interface unique. Cette acqui
Barrett Zoph, ancien chercheur chez OpenAI, revient chez Google pour contribuer au développement de Gemini
Barret Zoph, qui avait auparavant quitté brusquement l’entreprise pour rejoindre OpenAI en raison d’un désaccord avec Miriam Mularati, PDG de Thinking Machines Lab, a une nouvelle fois changé d’employ
Comment Recursive Intelligence a levé 335 millions de dollars en 4 mois, avec une valorisation de 4 milliards de dollars
Les cofondatrices de la start-up Ricursive Intelligence semblaient destinées à devenir cofondatrices.Anna Goldie, PDG, et Azalia Mirhoseini, directrice technique, sont si connues dans le milieu de l’I
Recommandations de sujets spéciaux liés
Conception et art
 Les meilleurs outils d'illustration basés sur l'IA : créez plus rapidement des scènes éditoriales et des illustrations de couverture
Les meilleurs outils d'illustration IA de 2026 : notre sélection regroupe les outils les plus performants pour créer rapidement de superbes scènes éditoriales et des couvertures accrocheuses. Chaque option a été soumise à des tests rigoureux en conditions réelles ; nous vous proposons une comparaison entre les versions gratuites et payantes afin de vous aider à trouver celle qui correspond le mieux à votre flux de travail. Essayez dès aujourd’hui ces solutions incontournables pour exploiter pleinement le potentiel de l’IA et booster votre productivité créative. Découvrez-les dès maintenant sur XIX.AI.
 10 outils
 xix.ai
Éducation et apprentissage
Les meilleurs professeurs particuliers spécialisés en IA pour la préparation aux examens : entraînez-vous en maths, en sciences et en anglais
Les meilleurs tuteurs IA 2026 les mieux notés pour la préparation aux examens sont disponibles ici, sur XIX.AI ! Notre sélection comprend des outils puissants et révolutionnaires qui proposent une comparaison entre les versions gratuites et payantes, des tests concrets et des classements mis à jour chaque semaine. Ils vous aident à améliorer votre efficacité à l'écrit, à simplifier l'apprentissage de sujets complexes et à libérer votre potentiel académique. Découvrez dès maintenant l'outil de préparation aux examens qui vous convient le mieux et commencez à créer dès aujourd'hui pour exploiter pleinement les avantages de l'IA !
10 outils
xix.ai
Finance
Outils de planification budgétaire par IA pour la gestion personnelle des finances
2026 Derniers Meilleurs Outils de Planification Budgétaire par IA les mieux notés pour la gestion personnelle des finances sont ici sur XIX.AI ! Cette collection soigneusement sélectionnée propose des solutions puissantes et révolutionnaires qui vous aident à réaliser des tests concrets, à comprendre vos habitudes de dépenses et à créer des plans personnalisés pour améliorer votre productivité. Profitez d’une comparaison entre versions gratuites et payantes ainsi que de classements détaillés. Des outils incontournables conçus pour simplifier la gestion financière et exploiter pleinement votre avantage grâce à l’IA. Explorez dès maintenant !
11 outils
xix.ai
Santé et bien-être
Assistants de suivi du sommeil par l’IA : améliorez votre récupération grâce à de meilleures habitudes avant le coucher
2026 : Découvrez les meilleurs assistants de suivi du sommeil basés sur l’IA, hautement notés et récemment mis à jour, conçus pour une récupération optimale. Ce guide hebdomadaire entièrement actualisé présente des outils puissants qui offrent des tests en conditions réelles, des comparaisons entre versions gratuites et payantes, ainsi que des classements détaillés afin de vous aider à trouver la solution idéale pour améliorer la qualité du sommeil et favoriser de meilleures habitudes avant le coucher. Explorez-le dès maintenant sur XIX.AI pour tirer parti des avantages offerts par l’IA.
10 outils
xix.ai
Analyse des données
Copilotes SQL basés sur l'IA pour l'analyse des produits et du chiffre d'affaires
2026 : les meilleurs copilotes SQL IA les mieux notés pour l'analyse des produits et du chiffre d'affaires ! XIX.AI a sélectionné une gamme d’outils puissants et révolutionnaires à essayer absolument, qui sont soumis à des tests en conditions réelles via des classements mis à jour chaque semaine. Ces outils aident les utilisateurs à booster considérablement leur productivité en accélérant l’analyse des données, en simplifiant les requêtes complexes et en générant des informations précises permettant de prendre des décisions commerciales plus éclairées. Explorez-les dès maintenant pour découvrir l’outil idéal qui vous permettra de tirer pleinement parti de l’IA !
14 outils
xix.ai
Éducation et apprentissage
Les meilleurs outils d'aide aux devoirs basés sur l'IA qui enseignent : apprenez les concepts, pas seulement les réponses
2026 : les meilleurs outils d'aide aux devoirs basés sur l'IA, les mieux notés, qui enseignent les concepts fondamentaux et ne se contentent pas de fournir des réponses. Des outils puissants pour les élèves. Une sélection incontournable à ne pas manquer. Mise à jour hebdomadaire. Comparaison entre les versions gratuites et payantes. Tests en conditions réelles. Classements précis pour vous aider à exploiter pleinement votre potentiel d'apprentissage. Explorez dès maintenant pour découvrir l'outil idéal qui vous permettra d'étudier plus efficacement.
10 outils
xix.ai

 commentaires (0)
Alors que la guerre des prix entre les modèles d'IA s'intensifie, Xiaomi a officiellement annoncé le 27 mai que son grand modèle MiMo allait baisser de manière permanente les tarifs de l'API de la série MiMo-V2.5, tout en optimisant le système de facturation afin de réduire encore davantage les coûts d'appel pour les développeurs grâce à des avancées technologiques.
I. Baisses de prix significatives des API — Jusqu'à 99 % de réduction
La modification des tarifs est entrée en vigueur à l'échelle mondiale à 00 h 00, heure de Pékin, le 27 mai. Elle s'applique aux deux versions principales, MiMo-V2.5 et MiMo-V2.5Pro, et ne fait plus de distinction en fonction de la longueur de la fenêtre de contexte, ce qui simplifie la structure tarifaire pour une plus grande transparence.
Version du modèle Prix en cas d'accès au cache d'entrée Remise maximale Prix de sortie Remise maximaleMiMo-V2.5Pro0,025 yuan par million de jetons, jusqu'à 99 % de réduction ; sortie : 6 yuans par million de jetons, jusqu'à 86 % de réduction MiMo-V2.5 0,02 yuan par million de jetons, jusqu'à 98 % de réduction ; sortie : 2 yuans par million de jetons, jusqu'à 93 % de réductionII. Mise à niveau du système de facturation — Plus de valeur sans frais supplémentaires
Au-delà des baisses de prix directes sur l'API, Xiaomi a considérablement optimisé son système de facturation Token Plan :
Quota quadruplé : par rapport à la tarification initiale, le quota d'utilisation réel de jetons a été multiplié par 5 à 8.
Règles simplifiées : l'introduction des crédits remplace les anciennes méthodes de facturation complexes, rendant la consommation de jetons et le calcul des coûts plus intuitifs pour les développeurs.
III. Fondements techniques — Comment peut-on continuer à baisser les prix ?
Le communiqué officiel de Xiaomi attribue ces baisses de prix importantes à des avancées techniques dans l'architecture de son système d'inférence sous-jacent :
Optimisation de l'inférence SWA : en tirant parti de SGLang HiCache avec une prise en charge complète du SWA (Sliding Window Attention Mechanism), le transfert de données entre la mémoire du GPU, la mémoire du CPU et le SSD a été réduit à un septième du volume précédent.
Efficacité du cache améliorée : le nombre de tokens pouvant être mis en cache a été multiplié par près de cinq par rapport à la version optimisée précédente, ce qui a permis d'augmenter les taux de réussite du cache et de réduire considérablement le coût par inférence.
Optimisation du débit du cluster : grâce à l'introduction de stratégies de parallélisme expert (MoE) et de regroupement par longueur d'entrée, le débit d'entrée du cluster a fait un bond qualitatif, maintenant une qualité de service élevée tout en réduisant progressivement le coût par token.
L'initiative de Xiaomi est considérée comme une réponse proactive à la concurrence intense qui règne actuellement dans la commercialisation des grands modèles. À mesure que les barrières de prix continuent de baisser, le rapport coût-efficacité de la série MiMo deviendra encore plus prononcé, accélérant l'intégration en profondeur des capacités d'IA dans les secteurs verticaux et les flux de travail des développeurs.








 Stripe va acquérir OpenRouter alors que le routage basé sur des modèles d'IA prend de l'ampleur
Stripe a conclu un accord en vue d’acquérir OpenRouter, une plateforme de routage de modèles d’IA qui permet aux développeurs d’accéder à des centaines de modèles via une interface unique. Cette acqui
 Barrett Zoph, ancien chercheur chez OpenAI, revient chez Google pour contribuer au développement de Gemini
Barret Zoph, qui avait auparavant quitté brusquement l’entreprise pour rejoindre OpenAI en raison d’un désaccord avec Miriam Mularati, PDG de Thinking Machines Lab, a une nouvelle fois changé d’employ
 Comment Recursive Intelligence a levé 335 millions de dollars en 4 mois, avec une valorisation de 4 milliards de dollars
Les cofondatrices de la start-up Ricursive Intelligence semblaient destinées à devenir cofondatrices.Anna Goldie, PDG, et Azalia Mirhoseini, directrice technique, sont si connues dans le milieu de l’I

Les meilleurs outils d'illustration IA de 2026 : notre sélection regroupe les outils les plus performants pour créer rapidement de superbes scènes éditoriales et des couvertures accrocheuses. Chaque option a été soumise à des tests rigoureux en conditions réelles ; nous vous proposons une comparaison entre les versions gratuites et payantes afin de vous aider à trouver celle qui correspond le mieux à votre flux de travail. Essayez dès aujourd’hui ces solutions incontournables pour exploiter pleinement le potentiel de l’IA et booster votre productivité créative. Découvrez-les dès maintenant sur XIX.AI.
10 outils
xix.ai

Les meilleurs tuteurs IA 2026 les mieux notés pour la préparation aux examens sont disponibles ici, sur XIX.AI ! Notre sélection comprend des outils puissants et révolutionnaires qui proposent une comparaison entre les versions gratuites et payantes, des tests concrets et des classements mis à jour chaque semaine. Ils vous aident à améliorer votre efficacité à l'écrit, à simplifier l'apprentissage de sujets complexes et à libérer votre potentiel académique. Découvrez dès maintenant l'outil de préparation aux examens qui vous convient le mieux et commencez à créer dès aujourd'hui pour exploiter pleinement les avantages de l'IA !
10 outils
xix.ai

2026 Derniers Meilleurs Outils de Planification Budgétaire par IA les mieux notés pour la gestion personnelle des finances sont ici sur XIX.AI ! Cette collection soigneusement sélectionnée propose des solutions puissantes et révolutionnaires qui vous aident à réaliser des tests concrets, à comprendre vos habitudes de dépenses et à créer des plans personnalisés pour améliorer votre productivité. Profitez d’une comparaison entre versions gratuites et payantes ainsi que de classements détaillés. Des outils incontournables conçus pour simplifier la gestion financière et exploiter pleinement votre avantage grâce à l’IA. Explorez dès maintenant !
11 outils
xix.ai

2026 : Découvrez les meilleurs assistants de suivi du sommeil basés sur l’IA, hautement notés et récemment mis à jour, conçus pour une récupération optimale. Ce guide hebdomadaire entièrement actualisé présente des outils puissants qui offrent des tests en conditions réelles, des comparaisons entre versions gratuites et payantes, ainsi que des classements détaillés afin de vous aider à trouver la solution idéale pour améliorer la qualité du sommeil et favoriser de meilleures habitudes avant le coucher. Explorez-le dès maintenant sur XIX.AI pour tirer parti des avantages offerts par l’IA.
10 outils
xix.ai

2026 : les meilleurs copilotes SQL IA les mieux notés pour l'analyse des produits et du chiffre d'affaires ! XIX.AI a sélectionné une gamme d’outils puissants et révolutionnaires à essayer absolument, qui sont soumis à des tests en conditions réelles via des classements mis à jour chaque semaine. Ces outils aident les utilisateurs à booster considérablement leur productivité en accélérant l’analyse des données, en simplifiant les requêtes complexes et en générant des informations précises permettant de prendre des décisions commerciales plus éclairées. Explorez-les dès maintenant pour découvrir l’outil idéal qui vous permettra de tirer pleinement parti de l’IA !
14 outils
xix.ai

2026 : les meilleurs outils d'aide aux devoirs basés sur l'IA, les mieux notés, qui enseignent les concepts fondamentaux et ne se contentent pas de fournir des réponses. Des outils puissants pour les élèves. Une sélection incontournable à ne pas manquer. Mise à jour hebdomadaire. Comparaison entre les versions gratuites et payantes. Tests en conditions réelles. Classements précis pour vous aider à exploiter pleinement votre potentiel d'apprentissage. Explorez dès maintenant pour découvrir l'outil idéal qui vous permettra d'étudier plus efficacement.
10 outils
xix.ai












