


 Maison
Qwen3.8-LiveTranslate lance un modèle de traduction en temps réel avec un délai de 2,3s
Qwen3.8-LiveTranslate, le dernier modèle de traduction vocale en temps réel d’Alibaba Qwen, redéfinit l’interprétation simultanée grâce à son architecture Unifiée Interleave. Cette innovation améliore la précision, la fluidité et la concision, réduisant la latence moyenne par caractère (LAAL) de 2,8 à 2,3 secondes – une amélioration critique de 0,5 seconde qui garantit une expérience d’écoute naturelle dans un domaine où même un léger délai peut perturber le flux.
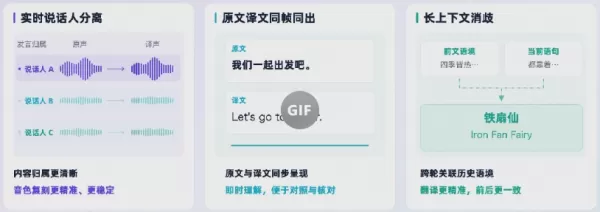
Élargissant le support pour 60 langues, le modèle mis à jour introduit trois améliorations pratiques pour l’interprétation en temps réel. Premièrement, il prend en charge la séparation des locuteurs en temps réel, attribuant avec précision chaque phrase au bon locuteur tout en maintenant une clonage vocal stable, empêchant ainsi les chevauchements ou les confusions entre les locuteurs. Deuxièmement, il affiche le texte source et le texte traduit côte à côte, permettant aux auditeurs de suivre visuellement pendant qu’ils entendent la traduction. Troisièmement, il améliore la désambiguïsation à long contexte, permettant au modèle d’exploiter le contexte antérieur pour une précision accrue – particulièrement pour les noms et la terminologie spécialisée, qui sont des points d’erreur courants.
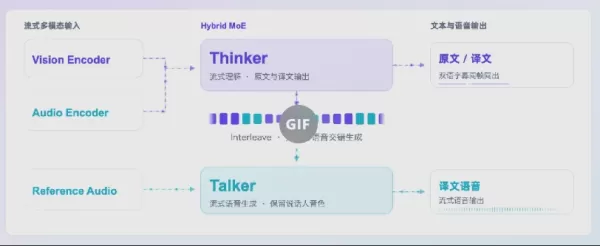
Au cœur de Qwen3.8-LiveTranslate se trouve une conception à double module Thinker–Talker basée sur l’architecture MoE hybride. Le mécanisme Interleave intègre de manière transparente la compréhension en flux continu, la génération de texte et la synthèse vocale dans un seul pipeline. Le Thinker traite la vidéo, l’audio, le texte source et les sorties de traduction en une séquence causale unifiée, les ordonnant chronologiquement pour produire des résultats de bout en bout qui gèrent simultanément la « compréhension » et la « traduction ». Le Talker convertit ensuite le texte traduit, guidé par l’audio original, en parole qui préserve l’identité vocale du locuteur source.
Article connexe
 Pike, psychologue de Harvard : concentrez-vous sur l’ingénierie de la sécurité de l’IA, pas sur les rumeurs d’apocalypse
Le psychologue de Harvard Steven Pinker soutient que les craintes concernant l’extinction humaine par l’intelligence artificielle sont considérablement exagérées, une position qu’il a détaillée dans une lettre ouverte adressée à Quillette et destinée
Le fondateur de Rivian, Mind Robotics, lève 500 millions de dollars pour faire progresser l’IA industrielle
Tandis que le monde de la technologie s’obsède des robots humanoïdes, une startup trace une voie différente — ignorant le battage médiatique tout en obtenant le soutien massif d’un fonds de capital-risque d’élite. Le 12 mars, Mind Robotics, une entre
Comment corriger les Core Web Vitals pour de meilleurs classements SEO ?
Construire un bot d'e-mail personnalisé pour automatiser vos messagesIntroductionConfiguration de l'environnement PythonDéveloppement d'un bot d'envoi d'e-mailsActivation de l'accès pour les applications externesImplémentation de la synthèse voc
Recommandations de sujets spéciaux liés
chatbot
 Outils de chatbot de connaissances IA pour la documentation interne
2026 Dernières Meilleures Outils de Chatbot IA les mieux notés pour la Documentation Interne sont ici sur XIX.AI ! Cette liste soigneusement sélectionnée propose des solutions puissantes et révolutionnaires qui augmentent considérablement la productivité en aidant les équipes à générer rapidement du contenu de haute qualité, rationaliser la création de documentation et surmonner les défis courants d’écriture. Nous effectuons des tests rigoureux en conditions réelles et fournissons une comparaison hebdomadaire gratuite vs payante ainsi que des classements détaillés pour vous aider à trouver l’option incontournable qui correspond le mieux à vos besoins. Explorez dès maintenant pour découvrir votre outil parfait !
 12 outils
 xix.ai
Synthèse vocale
Meilleurs outils d’IA de synthèse vocale : créez des voix off naturelles pour vos vidéos
2026 Derniers Meilleurs Outils de Synthèse Vocale par IA les mieux notés, sélectionnés pour créer des voix off naturelles dans les vidéos. XIX.AI propose des solutions puissantes et révolutionnaires qui améliorent l'efficacité de l'écriture et vous aident à surmonner les blocages créatifs. Nous réalisons des tests en conditions réelles, proposons des comparaisons entre versions gratuites et payantes, et mettons à jour nos classements chaque semaine. Les options incontournables sont mises en avant sur la base d'évaluations rigoureuses. Explorez dès maintenant pour découvrir l'outil parfait afin d'améliorer la qualité de vos vidéos.
9 outils
xix.ai
Finance
Les meilleurs outils de détection des fraudes basés sur l'IA : repérez les comportements suspects avant que les pertes ne s'aggravent
Les meilleurs outils de détection des fraudes basés sur l'IA de 2026, sélectionnés par XIX.AI, offrent des solutions puissantes et révolutionnaires pour repérer rapidement les comportements suspects et éviter des pertes coûteuses. Découvrez une comparaison entre les versions gratuites et payantes, des tests en conditions réelles et des classements détaillés pour vous aider à choisir l'option incontournable qui renforcera l'efficacité de votre sécurité. Explorez dès maintenant pour exploiter pleinement votre avantage en matière d’IA.
10 outils
xix.ai
Santé et bien-être
Les meilleurs compagnons de bien-être basés sur l'IA : réduisez votre stress grâce à un accompagnement quotidien à la pleine conscience
Classement 2026 des meilleurs compagnons de bien-être basés sur l'IA, sélectionnés par des experts. Cette liste triée sur le volet présente des outils puissants et révolutionnaires qui offrent un accompagnement quotidien à la pleine conscience afin d'aider les utilisateurs à réduire leur stress, à améliorer leur concentration et à renforcer leur bien-être général, grâce à des tests menés en conditions réelles. Consultez notre comparatif entre les versions gratuites et payantes pour trouver celle qui vous convient le mieux. Découvrez dès maintenant XIX.AI pour exploiter tout le potentiel de l'IA.
9 outils
xix.ai
Synthèse vocale
Outils d'adaptation du style vocal basés sur l'IA pour une restitution vocale naturelle
Les meilleurs outils d’IA de 2026 pour la personnalisation de la voix, les mieux notés et garantissant un rendu vocal naturel, sont disponibles ici sur XIX.AI. Cette sélection comprend des outils puissants et révolutionnaires qui offrent des timbres de voix hautement personnalisables, parfaits pour optimiser l’efficacité de la rédaction et créer du contenu captivant. Nous effectuons des tests en conditions réelles afin de vous proposer des classements précis, mis à jour chaque semaine, ainsi qu’une comparaison entre les versions gratuites et payantes pour vous aider à choisir celle qui correspond le mieux à vos besoins. Explorez dès maintenant notre sélection pour découvrir l’outil idéal et exploiter pleinement le potentiel de l’IA.
20 outils
xix.ai
Référencement
Outils de suivi du classement par l'IA pour Google, les aperçus générés par l'IA et la visibilité dans les moteurs de réponse
2026 Les derniers meilleurs outils de suivi du classement par IA les mieux notés pour Google, les aperçus d’IA et la visibilité des moteurs de réponse sont disponibles sur XIX.AI. Cette liste soigneusement sélectionnée propose des outils puissants et révolutionnaires, testés rigoureusement dans des conditions réelles pour fournir des données de classement précises. Obtenez une comparaison gratuite entre les versions gratuite et payante, consultez les meilleurs performers et découvrez les options incontournables à essayer pour améliorer la visibilité de votre contenu sur les moteurs de recherche. Explorez dès maintenant pour trouver l’outil parfait adapté à vos besoins.
10 outils
xix.ai

 commentaires (0)
Qwen3.8-LiveTranslate, le dernier modèle de traduction vocale en temps réel d’Alibaba Qwen, redéfinit l’interprétation simultanée grâce à son architecture Unifiée Interleave. Cette innovation améliore la précision, la fluidité et la concision, réduisant la latence moyenne par caractère (LAAL) de 2,8 à 2,3 secondes – une amélioration critique de 0,5 seconde qui garantit une expérience d’écoute naturelle dans un domaine où même un léger délai peut perturber le flux.
Élargissant le support pour 60 langues, le modèle mis à jour introduit trois améliorations pratiques pour l’interprétation en temps réel. Premièrement, il prend en charge la séparation des locuteurs en temps réel, attribuant avec précision chaque phrase au bon locuteur tout en maintenant une clonage vocal stable, empêchant ainsi les chevauchements ou les confusions entre les locuteurs. Deuxièmement, il affiche le texte source et le texte traduit côte à côte, permettant aux auditeurs de suivre visuellement pendant qu’ils entendent la traduction. Troisièmement, il améliore la désambiguïsation à long contexte, permettant au modèle d’exploiter le contexte antérieur pour une précision accrue – particulièrement pour les noms et la terminologie spécialisée, qui sont des points d’erreur courants.
Au cœur de Qwen3.8-LiveTranslate se trouve une conception à double module Thinker–Talker basée sur l’architecture MoE hybride. Le mécanisme Interleave intègre de manière transparente la compréhension en flux continu, la génération de texte et la synthèse vocale dans un seul pipeline. Le Thinker traite la vidéo, l’audio, le texte source et les sorties de traduction en une séquence causale unifiée, les ordonnant chronologiquement pour produire des résultats de bout en bout qui gèrent simultanément la « compréhension » et la « traduction ». Le Talker convertit ensuite le texte traduit, guidé par l’audio original, en parole qui préserve l’identité vocale du locuteur source.








 Pike, psychologue de Harvard : concentrez-vous sur l’ingénierie de la sécurité de l’IA, pas sur les rumeurs d’apocalypse
Le psychologue de Harvard Steven Pinker soutient que les craintes concernant l’extinction humaine par l’intelligence artificielle sont considérablement exagérées, une position qu’il a détaillée dans une lettre ouverte adressée à Quillette et destinée
 Le fondateur de Rivian, Mind Robotics, lève 500 millions de dollars pour faire progresser l’IA industrielle
Tandis que le monde de la technologie s’obsède des robots humanoïdes, une startup trace une voie différente — ignorant le battage médiatique tout en obtenant le soutien massif d’un fonds de capital-risque d’élite. Le 12 mars, Mind Robotics, une entre
 Comment corriger les Core Web Vitals pour de meilleurs classements SEO ?
Construire un bot d'e-mail personnalisé pour automatiser vos messagesIntroductionConfiguration de l'environnement PythonDéveloppement d'un bot d'envoi d'e-mailsActivation de l'accès pour les applications externesImplémentation de la synthèse voc
2026 Dernières Meilleures Outils de Chatbot IA les mieux notés pour la Documentation Interne sont ici sur XIX.AI ! Cette liste soigneusement sélectionnée propose des solutions puissantes et révolutionnaires qui augmentent considérablement la productivité en aidant les équipes à générer rapidement du contenu de haute qualité, rationaliser la création de documentation et surmonner les défis courants d’écriture. Nous effectuons des tests rigoureux en conditions réelles et fournissons une comparaison hebdomadaire gratuite vs payante ainsi que des classements détaillés pour vous aider à trouver l’option incontournable qui correspond le mieux à vos besoins. Explorez dès maintenant pour découvrir votre outil parfait !
12 outils
xix.ai
2026 Derniers Meilleurs Outils de Synthèse Vocale par IA les mieux notés, sélectionnés pour créer des voix off naturelles dans les vidéos. XIX.AI propose des solutions puissantes et révolutionnaires qui améliorent l'efficacité de l'écriture et vous aident à surmonner les blocages créatifs. Nous réalisons des tests en conditions réelles, proposons des comparaisons entre versions gratuites et payantes, et mettons à jour nos classements chaque semaine. Les options incontournables sont mises en avant sur la base d'évaluations rigoureuses. Explorez dès maintenant pour découvrir l'outil parfait afin d'améliorer la qualité de vos vidéos.
9 outils
xix.ai
Les meilleurs outils de détection des fraudes basés sur l'IA de 2026, sélectionnés par XIX.AI, offrent des solutions puissantes et révolutionnaires pour repérer rapidement les comportements suspects et éviter des pertes coûteuses. Découvrez une comparaison entre les versions gratuites et payantes, des tests en conditions réelles et des classements détaillés pour vous aider à choisir l'option incontournable qui renforcera l'efficacité de votre sécurité. Explorez dès maintenant pour exploiter pleinement votre avantage en matière d’IA.
10 outils
xix.ai
Classement 2026 des meilleurs compagnons de bien-être basés sur l'IA, sélectionnés par des experts. Cette liste triée sur le volet présente des outils puissants et révolutionnaires qui offrent un accompagnement quotidien à la pleine conscience afin d'aider les utilisateurs à réduire leur stress, à améliorer leur concentration et à renforcer leur bien-être général, grâce à des tests menés en conditions réelles. Consultez notre comparatif entre les versions gratuites et payantes pour trouver celle qui vous convient le mieux. Découvrez dès maintenant XIX.AI pour exploiter tout le potentiel de l'IA.
9 outils
xix.ai
Les meilleurs outils d’IA de 2026 pour la personnalisation de la voix, les mieux notés et garantissant un rendu vocal naturel, sont disponibles ici sur XIX.AI. Cette sélection comprend des outils puissants et révolutionnaires qui offrent des timbres de voix hautement personnalisables, parfaits pour optimiser l’efficacité de la rédaction et créer du contenu captivant. Nous effectuons des tests en conditions réelles afin de vous proposer des classements précis, mis à jour chaque semaine, ainsi qu’une comparaison entre les versions gratuites et payantes pour vous aider à choisir celle qui correspond le mieux à vos besoins. Explorez dès maintenant notre sélection pour découvrir l’outil idéal et exploiter pleinement le potentiel de l’IA.
20 outils
xix.ai
2026 Les derniers meilleurs outils de suivi du classement par IA les mieux notés pour Google, les aperçus d’IA et la visibilité des moteurs de réponse sont disponibles sur XIX.AI. Cette liste soigneusement sélectionnée propose des outils puissants et révolutionnaires, testés rigoureusement dans des conditions réelles pour fournir des données de classement précises. Obtenez une comparaison gratuite entre les versions gratuite et payante, consultez les meilleurs performers et découvrez les options incontournables à essayer pour améliorer la visibilité de votre contenu sur les moteurs de recherche. Explorez dès maintenant pour trouver l’outil parfait adapté à vos besoins.
10 outils
xix.ai












