


 Maison
GPT-5 d'OpenAI rivalise avec les performances humaines dans diverses professions
Jeudi, OpenAI a dévoilé GDPval, un référentiel révolutionnaire évaluant comment ses modèles d'IA se comparent aux professionnels humains dans divers secteurs d'activité. Cette évaluation constitue une première étape vers la détermination de si les systèmes d'OpenAI peuvent surpasser les humains dans un travail à impact économique – un objectif central dans la quête de l'intelligence artificielle générale (IAG) par l'entreprise.
Selon OpenAI, tant GPT-5 que Claude Opus 4.1 d'Anthropic démontrent une qualité de production approchant celle des spécialistes de l'industrie.
Bien que ces résultats n'impliquent pas un remplacement imminent des emplois humains, ils représentent un suivi de progrès crucial. OpenAI reconnaît que GDPval n'évalue actuellement qu'une fraction des tâches professionnelles réelles, contredisant les prédictions de certains PDG concernant une perturbation massive de l'IA dans les années à venir.
GDPval évalue la performance dans neuf secteurs clés du PIB américain – incluant la santé, la finance, la manufacturing et le gouvernement – testant 44 professions allant du génie logiciel au journalisme.
Pour GDPval-v0, des professionnels ont comparé des rapports générés par l'IA au travail de leurs homologues humains. Une tâche exemple impliquait des banquiers d'investissement analysant les paysages concurrentiels de la livraison du dernier kilomètre contre les versions de l'IA. OpenAI a calculé le "taux de victoire" de chaque modèle par rapport aux productions humaines sur toutes les professions.
Le modèle amélioré GPT-5-high a égalé ou dépassé la production experte 40,6 % du temps, tandis que Claude Opus 4.1 a atteint un taux de parité de 49 % – OpenAI suggère que ce score plus élevé pourrait refléter la présentation visuelle supérieure de Claude plutôt qu'un avantage substantiel.
Connectez-vous avec 10 000+ innovateurs technologiques et de capital-risque à Disrupt 2025
Avec Netflix, Box, a16z, ElevenLabs, Wayve, Sequoia Capital et Elad Gil parmi 250+ leaders du secteur accueillant 200+ sessions axées sur la croissance. Célébrez le 20e anniversaire de TechCrunch tout en acquérant des insights concurrentiels auprès des penseurs les plus éminents de la technologie. Une inscription anticipée avant le 26 septembre permet d'économiser jusqu'à 668 $.
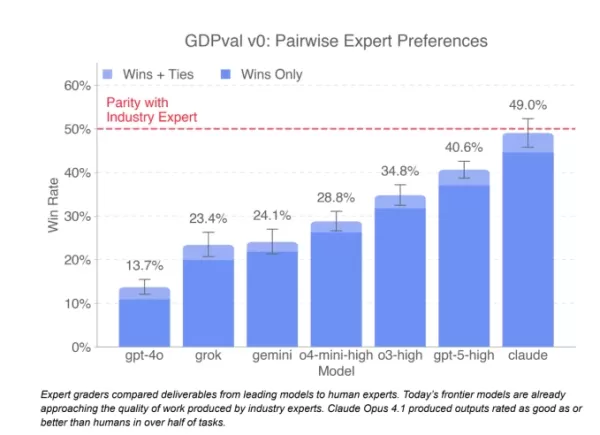
Crédits image : OpenAI OpenAI reconnaît la portée étroite de GDPval-v0 – testant actuellement uniquement la génération de rapports de recherche – et prévoit des itérations futures évaluant des interactions professionnelles plus larges.
Le Dr. Aaron Chatterji, Économiste en chef, a déclaré à TechCrunch que ces résultats indiquent que les professionnels peuvent de plus en plus déléguer des tâches routinières à l'IA, les libérant ainsi pour un travail à plus forte valeur ajoutée.
Tejal Patwardhan, responsable des évaluations, note des progrès rapides : GPT-4o n'a obtenu que 13,7 % il y a quinze mois, tandis que GPT-5 triple presque cette performance – une trajectoire qui devrait se poursuivre.
Alors que des référentiels comme AIME 2025 et GPQA Diamond dominent l'évaluation de l'IA, de nombreux modèles approchent de la saturation sur ces tests académiques. GDPval représente un accent croissant sur des normes d'évaluation pratiques et pertinentes pour l'industrie – bien qu'OpenAI nécessite des tests plus complets pour démontrer de manière concluante une performance de niveau humain dans tous les domaines professionnels.
Article connexe
 L'Armageddon du PHP : OpenAI et les experts de Google dévoilent des failles anciennes, semant la panique sur Internet
L'Agence nationale de sécurité américaine (NSA) a publié mercredi une alerte critique concernant deux vulnérabilités graves dans PHP, pour lesquelles des correctifs ont déjà été publiés par la Fo
Anthropic dévoile Opus 4.6, un générateur de contenu controversé
Les normes d'utilisation universelles d'Anthropic pour Claude interdisent au modèle de générer du contenu sexuellement explicite, notamment de décrire ou de solliciter des rapports sexuels ou des acte
Les aperçus d'IA de Google gagnent du terrain dans les résultats de recherche
Selon le rapport 2026 sur le paysage de l'intelligence artificielle générative de Similarweb, les résumés générés par l'IA de Google sont apparus dans 43 % des recherches aux États-Unis, une hausse significative par rapport aux 15 % enregistrés un an
Recommandations de sujets spéciaux liés
Conception et art
 Les meilleurs outils d'illustration basés sur l'IA : créez plus rapidement des scènes éditoriales et des illustrations de couverture
Les meilleurs outils d'illustration IA de 2026 : notre sélection regroupe les outils les plus performants pour créer rapidement de superbes scènes éditoriales et des couvertures accrocheuses. Chaque option a été soumise à des tests rigoureux en conditions réelles ; nous vous proposons une comparaison entre les versions gratuites et payantes afin de vous aider à trouver celle qui correspond le mieux à votre flux de travail. Essayez dès aujourd’hui ces solutions incontournables pour exploiter pleinement le potentiel de l’IA et booster votre productivité créative. Découvrez-les dès maintenant sur XIX.AI.
 10 outils
 xix.ai
Éducation et apprentissage
Les meilleurs professeurs particuliers spécialisés en IA pour la préparation aux examens : entraînez-vous en maths, en sciences et en anglais
Les meilleurs tuteurs IA 2026 les mieux notés pour la préparation aux examens sont disponibles ici, sur XIX.AI ! Notre sélection comprend des outils puissants et révolutionnaires qui proposent une comparaison entre les versions gratuites et payantes, des tests concrets et des classements mis à jour chaque semaine. Ils vous aident à améliorer votre efficacité à l'écrit, à simplifier l'apprentissage de sujets complexes et à libérer votre potentiel académique. Découvrez dès maintenant l'outil de préparation aux examens qui vous convient le mieux et commencez à créer dès aujourd'hui pour exploiter pleinement les avantages de l'IA !
10 outils
xix.ai
Finance
Outils de planification budgétaire par IA pour la gestion personnelle des finances
2026 Derniers Meilleurs Outils de Planification Budgétaire par IA les mieux notés pour la gestion personnelle des finances sont ici sur XIX.AI ! Cette collection soigneusement sélectionnée propose des solutions puissantes et révolutionnaires qui vous aident à réaliser des tests concrets, à comprendre vos habitudes de dépenses et à créer des plans personnalisés pour améliorer votre productivité. Profitez d’une comparaison entre versions gratuites et payantes ainsi que de classements détaillés. Des outils incontournables conçus pour simplifier la gestion financière et exploiter pleinement votre avantage grâce à l’IA. Explorez dès maintenant !
11 outils
xix.ai
Santé et bien-être
Assistants de suivi du sommeil par l’IA : améliorez votre récupération grâce à de meilleures habitudes avant le coucher
2026 : Découvrez les meilleurs assistants de suivi du sommeil basés sur l’IA, hautement notés et récemment mis à jour, conçus pour une récupération optimale. Ce guide hebdomadaire entièrement actualisé présente des outils puissants qui offrent des tests en conditions réelles, des comparaisons entre versions gratuites et payantes, ainsi que des classements détaillés afin de vous aider à trouver la solution idéale pour améliorer la qualité du sommeil et favoriser de meilleures habitudes avant le coucher. Explorez-le dès maintenant sur XIX.AI pour tirer parti des avantages offerts par l’IA.
10 outils
xix.ai
Analyse des données
Copilotes SQL basés sur l'IA pour l'analyse des produits et du chiffre d'affaires
2026 : les meilleurs copilotes SQL IA les mieux notés pour l'analyse des produits et du chiffre d'affaires ! XIX.AI a sélectionné une gamme d’outils puissants et révolutionnaires à essayer absolument, qui sont soumis à des tests en conditions réelles via des classements mis à jour chaque semaine. Ces outils aident les utilisateurs à booster considérablement leur productivité en accélérant l’analyse des données, en simplifiant les requêtes complexes et en générant des informations précises permettant de prendre des décisions commerciales plus éclairées. Explorez-les dès maintenant pour découvrir l’outil idéal qui vous permettra de tirer pleinement parti de l’IA !
14 outils
xix.ai
Éducation et apprentissage
Les meilleurs outils d'aide aux devoirs basés sur l'IA qui enseignent : apprenez les concepts, pas seulement les réponses
2026 : les meilleurs outils d'aide aux devoirs basés sur l'IA, les mieux notés, qui enseignent les concepts fondamentaux et ne se contentent pas de fournir des réponses. Des outils puissants pour les élèves. Une sélection incontournable à ne pas manquer. Mise à jour hebdomadaire. Comparaison entre les versions gratuites et payantes. Tests en conditions réelles. Classements précis pour vous aider à exploiter pleinement votre potentiel d'apprentissage. Explorez dès maintenant pour découvrir l'outil idéal qui vous permettra d'étudier plus efficacement.
10 outils
xix.ai

 commentaires (0)
Jeudi, OpenAI a dévoilé GDPval, un référentiel révolutionnaire évaluant comment ses modèles d'IA se comparent aux professionnels humains dans divers secteurs d'activité. Cette évaluation constitue une première étape vers la détermination de si les systèmes d'OpenAI peuvent surpasser les humains dans un travail à impact économique – un objectif central dans la quête de l'intelligence artificielle générale (IAG) par l'entreprise.
Selon OpenAI, tant GPT-5 que Claude Opus 4.1 d'Anthropic démontrent une qualité de production approchant celle des spécialistes de l'industrie.
Bien que ces résultats n'impliquent pas un remplacement imminent des emplois humains, ils représentent un suivi de progrès crucial. OpenAI reconnaît que GDPval n'évalue actuellement qu'une fraction des tâches professionnelles réelles, contredisant les prédictions de certains PDG concernant une perturbation massive de l'IA dans les années à venir.
GDPval évalue la performance dans neuf secteurs clés du PIB américain – incluant la santé, la finance, la manufacturing et le gouvernement – testant 44 professions allant du génie logiciel au journalisme.
Pour GDPval-v0, des professionnels ont comparé des rapports générés par l'IA au travail de leurs homologues humains. Une tâche exemple impliquait des banquiers d'investissement analysant les paysages concurrentiels de la livraison du dernier kilomètre contre les versions de l'IA. OpenAI a calculé le "taux de victoire" de chaque modèle par rapport aux productions humaines sur toutes les professions.
Le modèle amélioré GPT-5-high a égalé ou dépassé la production experte 40,6 % du temps, tandis que Claude Opus 4.1 a atteint un taux de parité de 49 % – OpenAI suggère que ce score plus élevé pourrait refléter la présentation visuelle supérieure de Claude plutôt qu'un avantage substantiel.
Connectez-vous avec 10 000+ innovateurs technologiques et de capital-risque à Disrupt 2025
Avec Netflix, Box, a16z, ElevenLabs, Wayve, Sequoia Capital et Elad Gil parmi 250+ leaders du secteur accueillant 200+ sessions axées sur la croissance. Célébrez le 20e anniversaire de TechCrunch tout en acquérant des insights concurrentiels auprès des penseurs les plus éminents de la technologie. Une inscription anticipée avant le 26 septembre permet d'économiser jusqu'à 668 $.
Connectez-vous avec 10 000+ innovateurs technologiques et de capital-risque à Disrupt 2025
Avec Netflix, Box, a16z, ElevenLabs, Wayve, Sequoia Capital et Elad Gil parmi 250+ leaders du secteur accueillant 200+ sessions axées sur la croissance. Célébrez le 20e anniversaire de TechCrunch tout en acquérant des insights concurrentiels auprès des penseurs les plus éminents de la technologie. Une inscription anticipée avant le 26 septembre permet d'économiser jusqu'à 668 $.
OpenAI reconnaît la portée étroite de GDPval-v0 – testant actuellement uniquement la génération de rapports de recherche – et prévoit des itérations futures évaluant des interactions professionnelles plus larges.
Le Dr. Aaron Chatterji, Économiste en chef, a déclaré à TechCrunch que ces résultats indiquent que les professionnels peuvent de plus en plus déléguer des tâches routinières à l'IA, les libérant ainsi pour un travail à plus forte valeur ajoutée.
Tejal Patwardhan, responsable des évaluations, note des progrès rapides : GPT-4o n'a obtenu que 13,7 % il y a quinze mois, tandis que GPT-5 triple presque cette performance – une trajectoire qui devrait se poursuivre.
Alors que des référentiels comme AIME 2025 et GPQA Diamond dominent l'évaluation de l'IA, de nombreux modèles approchent de la saturation sur ces tests académiques. GDPval représente un accent croissant sur des normes d'évaluation pratiques et pertinentes pour l'industrie – bien qu'OpenAI nécessite des tests plus complets pour démontrer de manière concluante une performance de niveau humain dans tous les domaines professionnels.








 L'Armageddon du PHP : OpenAI et les experts de Google dévoilent des failles anciennes, semant la panique sur Internet
L'Agence nationale de sécurité américaine (NSA) a publié mercredi une alerte critique concernant deux vulnérabilités graves dans PHP, pour lesquelles des correctifs ont déjà été publiés par la Fo
 Anthropic dévoile Opus 4.6, un générateur de contenu controversé
Les normes d'utilisation universelles d'Anthropic pour Claude interdisent au modèle de générer du contenu sexuellement explicite, notamment de décrire ou de solliciter des rapports sexuels ou des acte
 Les aperçus d'IA de Google gagnent du terrain dans les résultats de recherche
Selon le rapport 2026 sur le paysage de l'intelligence artificielle générative de Similarweb, les résumés générés par l'IA de Google sont apparus dans 43 % des recherches aux États-Unis, une hausse significative par rapport aux 15 % enregistrés un an

Les meilleurs outils d'illustration IA de 2026 : notre sélection regroupe les outils les plus performants pour créer rapidement de superbes scènes éditoriales et des couvertures accrocheuses. Chaque option a été soumise à des tests rigoureux en conditions réelles ; nous vous proposons une comparaison entre les versions gratuites et payantes afin de vous aider à trouver celle qui correspond le mieux à votre flux de travail. Essayez dès aujourd’hui ces solutions incontournables pour exploiter pleinement le potentiel de l’IA et booster votre productivité créative. Découvrez-les dès maintenant sur XIX.AI.
10 outils
xix.ai

Les meilleurs tuteurs IA 2026 les mieux notés pour la préparation aux examens sont disponibles ici, sur XIX.AI ! Notre sélection comprend des outils puissants et révolutionnaires qui proposent une comparaison entre les versions gratuites et payantes, des tests concrets et des classements mis à jour chaque semaine. Ils vous aident à améliorer votre efficacité à l'écrit, à simplifier l'apprentissage de sujets complexes et à libérer votre potentiel académique. Découvrez dès maintenant l'outil de préparation aux examens qui vous convient le mieux et commencez à créer dès aujourd'hui pour exploiter pleinement les avantages de l'IA !
10 outils
xix.ai

2026 Derniers Meilleurs Outils de Planification Budgétaire par IA les mieux notés pour la gestion personnelle des finances sont ici sur XIX.AI ! Cette collection soigneusement sélectionnée propose des solutions puissantes et révolutionnaires qui vous aident à réaliser des tests concrets, à comprendre vos habitudes de dépenses et à créer des plans personnalisés pour améliorer votre productivité. Profitez d’une comparaison entre versions gratuites et payantes ainsi que de classements détaillés. Des outils incontournables conçus pour simplifier la gestion financière et exploiter pleinement votre avantage grâce à l’IA. Explorez dès maintenant !
11 outils
xix.ai

2026 : Découvrez les meilleurs assistants de suivi du sommeil basés sur l’IA, hautement notés et récemment mis à jour, conçus pour une récupération optimale. Ce guide hebdomadaire entièrement actualisé présente des outils puissants qui offrent des tests en conditions réelles, des comparaisons entre versions gratuites et payantes, ainsi que des classements détaillés afin de vous aider à trouver la solution idéale pour améliorer la qualité du sommeil et favoriser de meilleures habitudes avant le coucher. Explorez-le dès maintenant sur XIX.AI pour tirer parti des avantages offerts par l’IA.
10 outils
xix.ai

2026 : les meilleurs copilotes SQL IA les mieux notés pour l'analyse des produits et du chiffre d'affaires ! XIX.AI a sélectionné une gamme d’outils puissants et révolutionnaires à essayer absolument, qui sont soumis à des tests en conditions réelles via des classements mis à jour chaque semaine. Ces outils aident les utilisateurs à booster considérablement leur productivité en accélérant l’analyse des données, en simplifiant les requêtes complexes et en générant des informations précises permettant de prendre des décisions commerciales plus éclairées. Explorez-les dès maintenant pour découvrir l’outil idéal qui vous permettra de tirer pleinement parti de l’IA !
14 outils
xix.ai

2026 : les meilleurs outils d'aide aux devoirs basés sur l'IA, les mieux notés, qui enseignent les concepts fondamentaux et ne se contentent pas de fournir des réponses. Des outils puissants pour les élèves. Une sélection incontournable à ne pas manquer. Mise à jour hebdomadaire. Comparaison entre les versions gratuites et payantes. Tests en conditions réelles. Classements précis pour vous aider à exploiter pleinement votre potentiel d'apprentissage. Explorez dès maintenant pour découvrir l'outil idéal qui vous permettra d'étudier plus efficacement.
10 outils
xix.ai












