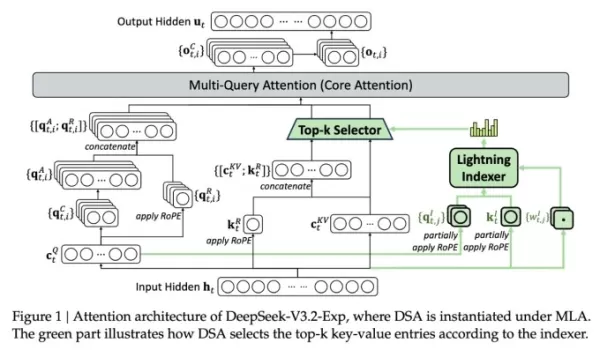
Los investigadores de DeepSeek han publicado V3.2-exp, un modelo con DeepSeek Sparse Attention para reducir los costes de inferencia de contextos largos hasta en un 50%, utilizando un indexador relámpago y un sistema de selección de tokens. De peso abierto sobre Hugging Face, pretende optimizar la eficiencia del transformador.
Al hacer clic en "Aceptar todos los cookies", usted acepta el almacenamiento de cookies en su dispositivo para mejorar la navegación por el sitio, analizar el uso del sitio y ayudar en nuestros esfuerzos de marketing.Política de privacidad Aviso
Al visitar cualquier sitio web, este puede almacenar o recuperar información en su navegador, principalmente en forma de cookies. Esta información puede referirse a usted, sus preferencias o su dispositivo y se usa principalmente para que el sitio funcione como espera. Por lo general, la información no lo identifica directamente, pero puede brindarle una experiencia web más personalizada. Debido a que respetamos su derecho a la privacidad, puede optar por no permitir algunos tipos de cookies. Haga clic en los diferentes títulos de categoría para obtener más información y cambiar nuestros ajustes predeterminados. Sin embargo, bloquear algunos tipos de cookies puede afectar su experiencia en el sitio y los servicios que podemos ofrecer. Política de privacidadDeclaración
Gestionar preferencias
Cookie estrictamente necesario
Siempre activo
Estos cookies son necesarios para que el sitio web funcione y no pueden ser desactivados en nuestros sistemas. Por lo general, solo se establecen en respuesta a acciones que realice usted que equivalen a una solicitud de servicios, como configurar sus preferencias de privacidad, iniciar sesión o completar formularios. Puede configurar su navegador para bloquear estos cookies o alertarle sobre ellos, pero algunas partes del sitio no funcionarán luego. Estos cookies no almacenan ninguna información que permita identificar personalmente.



 Hogar