


 Hogar
Un tribunal indio dictamina que el entrenamiento de OpenAI con noticias no constituye una infracción; una medida cautelar provisional acabaría con los modelos locales
Una sentencia ha zanjado el debate sobre si el entrenamiento de la IA debe pagar por los contenidos informativos en la India, ofreciendo un resultado claro. El 24 de julio, hora local, el Tribunal Superior de Delhi dictaminó que el uso por parte de OpenAI de contenidos de Asian News International (ANI) para entrenar su modelo de inteligencia artificial no constituye una infracción de los derechos de autor.
El juez Amit Bansal expuso dos razones fundamentales en la sentencia. En primer lugar, las acciones de OpenAI entran dentro de la excepción de «uso legítimo» definida en la Ley de Derechos de Autor de la India. En segundo lugar, ANI no aportó al tribunal pruebas que demostraran que las respuestas de ChatGPT copiaban directamente el contenido protegido por derechos de autor de ANI. Estos dos puntos socavaron directamente los fundamentos de la demanda de ANI.
Y lo que es más importante, la sentencia rechazó explícitamente la solicitud de medida cautelar. El juez hizo hincapié en que dictar una medida cautelar provisional en esta fase no favorecería el desarrollo de la inteligencia artificial, sino que, por el contrario, obstaculizaría gravemente los proyectos emergentes de modelos de lenguaje a gran escala en la India. De aplicarse, la medida cautelar también tendría amplias repercusiones negativas en el interés público: los usuarios que utilizan libremente ChatGPT en la India serían los primeros en sentir el impacto. En otras palabras, el tribunal sopesó «proteger a un proveedor de contenidos» frente a «perjudicar a todo el sector y al público» y, en última instancia, se decantó por lo segundo.
No se trata de un caso aislado. Anteriormente, medios de comunicación como The New York Times interpusieron demandas similares contra OpenAI en Estados Unidos, y esos casos siguen en trámite. A medida que disputas similares se desarrollan de forma independiente en diferentes jurisdicciones, la sentencia de la India ha abierto, al menos, una brecha en la acusación de que «el entrenamiento equivale a una infracción».
Artículo relacionado
 Pichai confirma que Gemini 4 de Google ya está en fase de entrenamiento, con una presentación prevista para finales de año
Sundar Pichai, director ejecutivo de Google, confirmó durante la llamada de resultados del segundo trimestre de 2026 de la compañía que el entrenamiento del modelo Gemini4 de próxima generación ha comenzado oficialmente, con Google comprometiendo «un
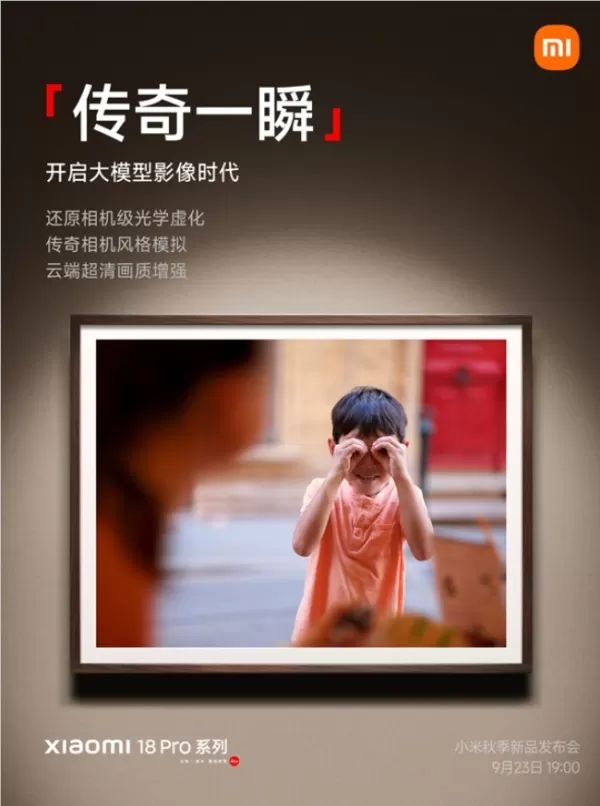
La serie Xiaomi 18 Pro se lanza con desenfoque óptico a nivel de cámara impulsado por un modelo grande de extremo a extremo
Xiaomi ha confirmado que la serie Xiaomi 18 Pro se lanzará el 23 de septiembre a las 19:00 horas, con dos variantes: 18 Pro y 18 Pro Max. La innovación destacada es el nuevo sistema de imagen "Instantáneo Legendario", que aprovecha un modelo grande d
Apple Music etiquetará como música el contenido generado por IA mientras las plataformas musicales abordan el spam de IA
A partir de finales de 2026, Apple Music exigirá etiquetas de transparencia sobre la inteligencia artificial a los proveedores de contenido, pasando de un sistema de divulgación voluntaria a una aplicación estricta. Desde que introdujo estas etiqueta
Recomendaciones de temas especiales relacionados
Diseño y Arte
 Las mejores herramientas de ilustración con IA: crea escenas editoriales y portadas más rápido
Las mejores herramientas de ilustración con IA de 2026: nuestra lista seleccionada incluye las mejores herramientas, diseñadas con gran potencia, para crear rápidamente impresionantes escenas editoriales y llamativas portadas. Cada opción ha sido sometida a rigurosas pruebas en condiciones reales y ofrece una comparación entre las versiones gratuitas y de pago para ayudarte a encontrar la que mejor se adapte a tu flujo de trabajo. Prueba hoy mismo estas soluciones imprescindibles para sacar el máximo partido a la IA y potenciar tu productividad creativa. Descúbrelas ahora en XIX.AI.
 10 herramientas
 xix.ai
Educación y aprendizaje
Los mejores profesores particulares de IA para la preparación de exámenes: practica matemáticas, ciencias e inglés
¡Ya están aquí, en XIX.AI, los mejores tutores de IA para la preparación de exámenes de 2026, con las mejores valoraciones! Nuestra lista seleccionada incluye potentes herramientas revolucionarias que ofrecen comparativas entre versiones gratuitas y de pago, pruebas reales y clasificaciones actualizadas semanalmente. Te ayudan a mejorar tu eficiencia a la hora de escribir, a simplificar el aprendizaje de temas complejos y a desarrollar todo tu potencial académico. ¡Explora ahora mismo para descubrir tu herramienta perfecta de preparación de exámenes y empieza a crear hoy mismo para sacar partido a tu ventaja con la IA!
10 herramientas
xix.ai
Finanzas
Herramientas de planificación presupuestaria con IA para la gestión personal del dinero
2026 Últimas Mejores Herramientas de Planificación Presupuestaria con IA Mejor Valoradas para la Gestión Personal del Dinero están aquí en XIX.AI. Esta colección seleccionada presenta soluciones poderosas y transformadoras que te ayudan a realizar pruebas en el mundo real, comprender tus hábitos de gasto y crear planes personalizados para aumentar la productividad. Disfruta de una comparación entre versiones gratuitas y de pago junto con clasificaciones detalladas. Herramientas imprescindibles diseñadas para simplificar la gestión del dinero y desbloquear tu ventaja con IA. ¡Explóralas ahora!
11 herramientas
xix.ai
Salud y bienestar
Asistentes de seguimiento del sueño basados en IA: mejora tu recuperación con mejores hábitos a la hora de acostarte
Los mejores asistentes de seguimiento del sueño con IA de 2026, seleccionados para una recuperación óptima. Esta guía semanal totalmente actualizada incluye potentes herramientas que ofrecen pruebas en condiciones reales, comparativas entre opciones gratuitas y de pago, y clasificaciones detalladas para ayudarte a encontrar la solución imprescindible que mejora la calidad del sueño y fomenta mejores hábitos a la hora de acostarse. Descúbrelo ahora en XIX.AI y aprovecha todas las ventajas de la IA.
10 herramientas
xix.ai
Análisis de datos
Copilotos de IA y SQL para el análisis de productos e ingresos
¡Los mejores copilotos de IA para SQL mejor valorados de 2026 para el análisis de productos e ingresos! XIX.AI ha seleccionado una potente colección de herramientas revolucionarias que no te puedes perder y que se someten a pruebas en el mundo real a través de clasificaciones que se actualizan semanalmente. Estas herramientas ayudan a los usuarios a aumentar significativamente su productividad al acelerar el análisis de datos, simplificar consultas complejas y generar información precisa para tomar decisiones empresariales más inteligentes. ¡Explora ahora mismo y descubre la herramienta perfecta para sacar el máximo partido a tu ventaja en IA!
14 herramientas
xix.ai
Educación y aprendizaje
Las mejores herramientas de IA para los deberes que realmente enseñan: aprende conceptos, no solo respuestas
2026: los mejores y más valorados asistentes de deberes con IA que enseñan conceptos básicos, no solo respuestas. Potentes herramientas para estudiantes. Una selección imprescindible que debes probar. Actualización semanal. Comparativa entre opciones gratuitas y de pago. Pruebas en el mundo real. Clasificaciones precisas para ayudarte a desarrollar todo tu potencial de aprendizaje. Explora ahora y descubre la herramienta perfecta para estudiar de forma más inteligente.
10 herramientas
xix.ai

 comentario (0)
0/500
Una sentencia ha zanjado el debate sobre si el entrenamiento de la IA debe pagar por los contenidos informativos en la India, ofreciendo un resultado claro. El 24 de julio, hora local, el Tribunal Superior de Delhi dictaminó que el uso por parte de OpenAI de contenidos de Asian News International (ANI) para entrenar su modelo de inteligencia artificial no constituye una infracción de los derechos de autor.
El juez Amit Bansal expuso dos razones fundamentales en la sentencia. En primer lugar, las acciones de OpenAI entran dentro de la excepción de «uso legítimo» definida en la Ley de Derechos de Autor de la India. En segundo lugar, ANI no aportó al tribunal pruebas que demostraran que las respuestas de ChatGPT copiaban directamente el contenido protegido por derechos de autor de ANI. Estos dos puntos socavaron directamente los fundamentos de la demanda de ANI.
Y lo que es más importante, la sentencia rechazó explícitamente la solicitud de medida cautelar. El juez hizo hincapié en que dictar una medida cautelar provisional en esta fase no favorecería el desarrollo de la inteligencia artificial, sino que, por el contrario, obstaculizaría gravemente los proyectos emergentes de modelos de lenguaje a gran escala en la India. De aplicarse, la medida cautelar también tendría amplias repercusiones negativas en el interés público: los usuarios que utilizan libremente ChatGPT en la India serían los primeros en sentir el impacto. En otras palabras, el tribunal sopesó «proteger a un proveedor de contenidos» frente a «perjudicar a todo el sector y al público» y, en última instancia, se decantó por lo segundo.
No se trata de un caso aislado. Anteriormente, medios de comunicación como The New York Times interpusieron demandas similares contra OpenAI en Estados Unidos, y esos casos siguen en trámite. A medida que disputas similares se desarrollan de forma independiente en diferentes jurisdicciones, la sentencia de la India ha abierto, al menos, una brecha en la acusación de que «el entrenamiento equivale a una infracción».








 Pichai confirma que Gemini 4 de Google ya está en fase de entrenamiento, con una presentación prevista para finales de año
Sundar Pichai, director ejecutivo de Google, confirmó durante la llamada de resultados del segundo trimestre de 2026 de la compañía que el entrenamiento del modelo Gemini4 de próxima generación ha comenzado oficialmente, con Google comprometiendo «un
 La serie Xiaomi 18 Pro se lanza con desenfoque óptico a nivel de cámara impulsado por un modelo grande de extremo a extremo
Xiaomi ha confirmado que la serie Xiaomi 18 Pro se lanzará el 23 de septiembre a las 19:00 horas, con dos variantes: 18 Pro y 18 Pro Max. La innovación destacada es el nuevo sistema de imagen "Instantáneo Legendario", que aprovecha un modelo grande d
 Apple Music etiquetará como música el contenido generado por IA mientras las plataformas musicales abordan el spam de IA
A partir de finales de 2026, Apple Music exigirá etiquetas de transparencia sobre la inteligencia artificial a los proveedores de contenido, pasando de un sistema de divulgación voluntaria a una aplicación estricta. Desde que introdujo estas etiqueta

Las mejores herramientas de ilustración con IA de 2026: nuestra lista seleccionada incluye las mejores herramientas, diseñadas con gran potencia, para crear rápidamente impresionantes escenas editoriales y llamativas portadas. Cada opción ha sido sometida a rigurosas pruebas en condiciones reales y ofrece una comparación entre las versiones gratuitas y de pago para ayudarte a encontrar la que mejor se adapte a tu flujo de trabajo. Prueba hoy mismo estas soluciones imprescindibles para sacar el máximo partido a la IA y potenciar tu productividad creativa. Descúbrelas ahora en XIX.AI.
10 herramientas
xix.ai

¡Ya están aquí, en XIX.AI, los mejores tutores de IA para la preparación de exámenes de 2026, con las mejores valoraciones! Nuestra lista seleccionada incluye potentes herramientas revolucionarias que ofrecen comparativas entre versiones gratuitas y de pago, pruebas reales y clasificaciones actualizadas semanalmente. Te ayudan a mejorar tu eficiencia a la hora de escribir, a simplificar el aprendizaje de temas complejos y a desarrollar todo tu potencial académico. ¡Explora ahora mismo para descubrir tu herramienta perfecta de preparación de exámenes y empieza a crear hoy mismo para sacar partido a tu ventaja con la IA!
10 herramientas
xix.ai

2026 Últimas Mejores Herramientas de Planificación Presupuestaria con IA Mejor Valoradas para la Gestión Personal del Dinero están aquí en XIX.AI. Esta colección seleccionada presenta soluciones poderosas y transformadoras que te ayudan a realizar pruebas en el mundo real, comprender tus hábitos de gasto y crear planes personalizados para aumentar la productividad. Disfruta de una comparación entre versiones gratuitas y de pago junto con clasificaciones detalladas. Herramientas imprescindibles diseñadas para simplificar la gestión del dinero y desbloquear tu ventaja con IA. ¡Explóralas ahora!
11 herramientas
xix.ai

Los mejores asistentes de seguimiento del sueño con IA de 2026, seleccionados para una recuperación óptima. Esta guía semanal totalmente actualizada incluye potentes herramientas que ofrecen pruebas en condiciones reales, comparativas entre opciones gratuitas y de pago, y clasificaciones detalladas para ayudarte a encontrar la solución imprescindible que mejora la calidad del sueño y fomenta mejores hábitos a la hora de acostarse. Descúbrelo ahora en XIX.AI y aprovecha todas las ventajas de la IA.
10 herramientas
xix.ai

¡Los mejores copilotos de IA para SQL mejor valorados de 2026 para el análisis de productos e ingresos! XIX.AI ha seleccionado una potente colección de herramientas revolucionarias que no te puedes perder y que se someten a pruebas en el mundo real a través de clasificaciones que se actualizan semanalmente. Estas herramientas ayudan a los usuarios a aumentar significativamente su productividad al acelerar el análisis de datos, simplificar consultas complejas y generar información precisa para tomar decisiones empresariales más inteligentes. ¡Explora ahora mismo y descubre la herramienta perfecta para sacar el máximo partido a tu ventaja en IA!
14 herramientas
xix.ai

2026: los mejores y más valorados asistentes de deberes con IA que enseñan conceptos básicos, no solo respuestas. Potentes herramientas para estudiantes. Una selección imprescindible que debes probar. Actualización semanal. Comparativa entre opciones gratuitas y de pago. Pruebas en el mundo real. Clasificaciones precisas para ayudarte a desarrollar todo tu potencial de aprendizaje. Explora ahora y descubre la herramienta perfecta para estudiar de forma más inteligente.
10 herramientas
xix.ai












