


 Heim
Schüler schafft eine Website für AI Minecraft Build-Off-Herausforderungen
Kreatives KI-Benchmarking mit Minecraft
Da traditionelle KI-Benchmarking-Methoden nicht ausreichen, erkunden Entwickler innovative Ansätze, um die Leistungsfähigkeit generativer KI-Modelle zu bewerten. Eine solche kreative Methode nutzt Minecraft, das beliebte Sandbox-Spiel von Microsoft. Eine Gruppe von Entwicklern hat Minecraft Benchmark, oder MC-Bench, ins Leben gerufen, eine Plattform, auf der KI-Modelle in Wettbewerben antreten, um Minecraft-Bauten basierend auf vorgegebenen Aufgaben zu erstellen.
Auf MC-Bench können Nutzer abstimmen, welche Kreation eines KI-Modells ihnen besser gefällt, und erst nach ihrer Abstimmung erfahren sie, welches Modell welchen Bau erstellt hat. Dieser interaktive Ansatz bindet nicht nur die Gemeinschaft ein, sondern bietet auch eine einzigartige Möglichkeit, KI-Fähigkeiten zu bewerten.
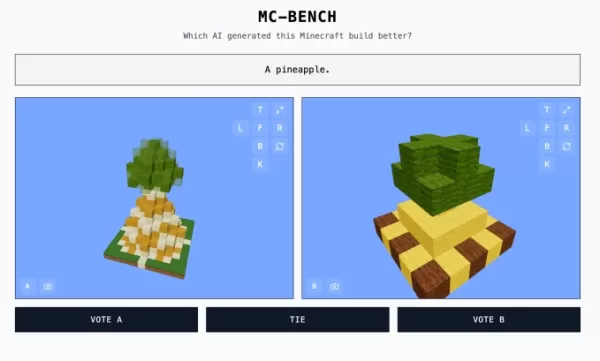
Bildnachweis: Minecraft Benchmark Adi Singh, ein Schüler der 12. Klasse und Initiator von MC-Bench, glaubt, dass die weitreichende Bekanntheit von Minecraft entscheidend ist. Als meistverkauftes Videospiel aller Zeiten ist es vielen vertraut, was es Menschen erleichtert, die Qualität von KI-generierten Bauten zu beurteilen, selbst wenn sie das Spiel nicht selbst gespielt haben. „Minecraft ermöglicht es den Menschen, den Fortschritt [der KI-Entwicklung] viel einfacher zu sehen“, erklärte Singh gegenüber TechCrunch. „Die Menschen sind an Minecraft gewöhnt, an das Aussehen und die Atmosphäre.“
MC-Bench wird von einem Team aus acht freiwilligen Mitwirkenden unterstützt. Unternehmen wie Anthropic, Google, OpenAI und Alibaba haben ihre Produkte für die Durchführung von Benchmark-Aufgaben bereitgestellt, sind aber ansonsten nicht am Projekt beteiligt.
Singh plant, MC-Bench über einfache Bauten hinaus auf komplexere, zielorientierte Aufgaben auszuweiten. „Spiele könnten ein Medium sein, um agentisches Denken zu testen, das sicherer ist als im echten Leben und besser kontrollierbar für Testzwecke, was es in meinen Augen idealer macht“, sagte er.
Weitere Spiele als KI-Benchmarks
Neben Minecraft wurden auch andere Spiele wie Pokémon Red, Street Fighter und Pictionary als experimentelle Benchmarks für KI genutzt. Die Herausforderung beim Benchmarking von KI liegt in ihrer Komplexität, da traditionelle standardisierte Tests oft KI-Modelle begünstigen, die aufgrund ihrer Trainingsmethoden in engen Problemlösungsbereichen wie Auswendiglernen oder einfacher Extrapolation glänzen.
Zum Beispiel kann OpenAI's GPT-4 im LSAT in der 88. Perzentile punkten, hat aber Schwierigkeiten mit einfacheren Aufgaben wie dem Zählen der Rs in „strawberry“. Ähnlich erreichte Anthropic's Claude 3.7 Sonnet eine Genauigkeit von 62,3 % bei einem Software-Engineering-Benchmark, scheitert aber beim Spielen von Pokémon im Vergleich zu den meisten Fünfjährigen.
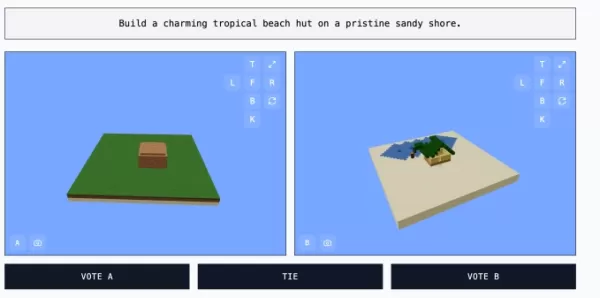
Bildnachweis: Minecraft Benchmark MC-Bench: Mehr als nur ein Programmier-Benchmark
Technisch gesehen ist MC-Bench ein Programmier-Benchmark, da es von KI-Modellen verlangt, Code zu schreiben, um Bauten wie „Frosty der Schneemann“ oder „eine charmante tropische Strandhütte an einem unberührten Sandstrand“ zu erstellen. Der Reiz der Plattform liegt jedoch in ihrer Zugänglichkeit. Es ist für Nutzer einfacher, die visuelle Qualität eines Baus zu bewerten, als Code zu analysieren, was die Reichweite des Projekts und das Potenzial für die Datensammlung zur Modellleistung erweitert.
Die Debatte darüber, ob diese Bewertungen die tatsächliche Nützlichkeit von KI widerspiegeln, geht weiter. Singh glaubt jedoch, dass sie ein starker Indikator sind. „Die aktuelle Rangliste spiegelt meine eigene Erfahrung mit der Nutzung dieser Modelle ziemlich genau wider, was bei vielen reinen Text-Benchmarks nicht der Fall ist“, sagte er. „Vielleicht könnte [MC-Bench] für Unternehmen nützlich sein, um zu wissen, ob sie in die richtige Richtung gehen.“
Verwandter Artikel
 Apple Smart Glasses könnten auf der WWDC27 vorgestellt werden und dabei den Schutz der Privatsphäre in den Mittelpunkt stellen
Bloombergs Mark Gurman berichtet, dass Apples Smart Glasses mit dem Codenamen N50 im Juni 2027 auf der WWDC27 vorgestellt werden sollen, wobei ein Verkaufsstart im Herbst 2027 erwartet wird. Ursprünglich für Ende dieses Jahres und Anfang 2027 geplant
Inside Details Exposed About Next-Gen Gemini: Strained Computing Power, Internal Teams Disagreed on Development Priorities and Resource Allocation
Berichten zufolge wurde der Start des hocherwarteten Next-Generation-Gemini-Modells von Google verschoben. Interne Uneinigkeiten über Entwicklungsprioritäten und Ressourcenallokation, kombiniert mit begrenzter Rechenkapazität und komplexen Genehmigun
OpenAI entkräftet Bedenken bezüglich des verlangsamen Wachstums und erklärt, dass mehrere Geschäftsbereiche ihre Expansion beschleunigen
Als Reaktion auf externe Kritik bezüglich des nachlassenden Umsatzwachstums und verpasster interner Zielvorgaben gab der KI-Pionier OpenAI am Dienstag, den 28. April, eine selbstbewusste Erklärung ab. Das Unternehmen präzisierte, dass seine Verbrauch
Empfehlungen zu verwandten Spezialthemen
Musikkomposition
 Die besten KI-Tools zum Komponieren von Melodien für Songentwürfe
2026 Neueste Besten Top-Bewerteten KI-Melodie-Schreibtools für Songentwürfe! XIX.AI hat eine hochleistungsfähige, bahnbrechende Kollektion zusammengestellt, die strengen Praxistests unterzogen wurde, um das beste Schreiberlebnis zu liefern. Sie finden detaillierte kostenlose versus kostenpflichtige Vergleiche, präzise Ranglisten und unbedingt auszuprobierende Optionen, die darauf ausgelegt sind, Ihnen zu helfen, beeindruckende Songentwürfe mühelos zu erstellen und Ihre kreative Produktivität erheblich zu steigern. Entdecken Sie jetzt Ihr perfektes Tool!
 8 Tools
 xix.ai
Chatbot
Die besten KI-gestützten Gesprächstrainingstools für Vorstellungsgesprächspraxis
2026 Neueste Besten Top-bewerteten KI-Konversationstrainer-Tools für Vorstellungsgesprächspraxis sind hier auf XIX.AI! Diese kuratierte Sammlung enthält leistungsstarke, bahnbrechende Tools, die strengen Praxistests unterzogen wurden, um präzises Feedback zu liefern. Sie finden einen Vergleich zwischen kostenlosen und kostenpflichtigen Optionen sowie detaillierte Rankings, die Ihnen helfen, die empfehlenswerte Option zu wählen, die Ihr Selbstvertrauen und Ihre Fähigkeiten verbessert. Entdecken Sie jetzt Ihr perfektes Tool für den Erfolg im Vorstellungsgespräch!
12 Tools
xix.ai
Design & Kunst
Die besten KI-Tools für den Stiltransfer für kreative Experimente
Die besten und am besten bewerteten KI-Tools für den Stiltransfer im Jahr 2026 – ideal für kreative Experimente! XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung unverzichtbarer Tools zusammengestellt, die in Praxistests und strengen Bewertungen außergewöhnliche Ergebnisse liefern. Diese Top-Lösungen helfen Kreativen dabei, ihre Produktivität deutlich zu steigern, indem sie die Erstellung von Inhalten beschleunigen und unendliche kreative Möglichkeiten eröffnen. Entdecken Sie jetzt Ihr perfektes Tool und legen Sie noch heute los!
9 Tools
xix.ai
Comic-Erstellung
Die besten KI-Tools für Sprechblasen zum visuellen Geschichtenerzählen
Die besten und am besten bewerteten KI-Tools für Sprechblasen zum visuellen Storytelling des Jahres 2026 finden Sie hier auf XIX.AI! Diese sorgfältig zusammengestellte Sammlung umfasst leistungsstarke, bahnbrechende Tools, die Kreativen dabei helfen, ihre Produktivität zu steigern und kreative Blockaden zu überwinden. Holen Sie sich einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, sehen Sie sich Praxistests an und werfen Sie einen Blick auf die aktuellen Rankings, um die unverzichtbaren Lösungen zu finden, die sich perfekt für die Gestaltung fesselnder visueller Erzählungen eignen. Stöbern Sie jetzt und entdecken Sie Ihr ideales Tool!
10 Tools
xix.ai
Besprechungsassistent
Die besten Tools zur Zusammenfassung von KI-Meetings: Entscheidungen und Folgemaßnahmen übersichtlich nachverfolgen
Die besten und am besten bewerteten KI-Tools zur Zusammenfassung von Besprechungen im Jahr 2026 für eine übersichtliche Nachverfolgung von Entscheidungen und müheloses Follow-up. Diese sorgfältig zusammengestellte Liste präsentiert leistungsstarke, bahnbrechende Lösungen, die die Produktivität drastisch steigern, indem sie Besprechungsnotizen automatisieren, wichtige Aktionspunkte identifizieren und die Teamkoordination projektübergreifend optimieren. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten sowie Praxistests und wöchentlich aktualisierte Rankings, die Ihnen helfen, das perfekte Tool zu finden. Entdecken Sie es jetzt und nutzen Sie Ihren KI-Vorteil!
9 Tools
xix.ai
Datenanalyse
Die besten Tools für die KI-gestützte Datenreinigung: Fehlende Werte und Duplikate schnell beheben
2026 – Die neuesten, besten und am höchsten bewerteten Tools für die Reinigung von KI-Daten, um fehlende Werte sowie Duplikate schnell zu beheben. Diese sorgfältig zusammengestellte Liste präsentiert leistungsstarke Lösungen, die die Produktivität erheblich steigern. Jedes Tool wurde in der Praxis gründlich getestet, um seine Zuverlässigkeit zu gewährleisten. Holen Sie sich einen kostenlosen Vergleich zwischen kostenloser und kostenpflichtiger Variante und entdecken Sie das für Ihre Bedürfnisse beste Tool. Entdecken Sie es jetzt auf XIX.AI, um Ihren Vorteil in der KI-Branche zu erlangen.
11 Tools
xix.ai

 Kommentare (27)
![DouglasMartinez]()
Interesting approach! Using Minecraft for AI benchmarking sounds way more engaging than standard tests. Wonder if this could lead to AI that actually helps design game worlds? The student's project is a cool example of how gaming and AI research can mix. Hope they share the results! 🎮
![RaymondGreen]()
高校生がAI建築チャレンジのサイトを作ったのか…!Minecraftの世界でAIの創造性を測るってアイデア、すごく面白いな。でも、これって結局マイクロソフトのプロモーションみたいなものじゃないの?AIがどんどんゲーム内に溶け込んでいくの、ちょっと怖い気もする😅 未来のゲームはすべてAIが作っちゃうのかな?
![NicholasYoung]()
AIが建築対決するなんて面白すぎる!🏗️ Minecraftでベンチマークを取る発想が新鮮だけど、これってゲームバランス崩さないのかな?ちょっと心配…
![JamesMiller]()
É sempre incrível ver jovens inovando com IA! Alguém já testou se esses desafios do Minecraft realmente conseguem medir bem a criatividade dos modelos? Ou será que é só mais uma moda passageira? 😅
![RalphRoberts]()
这个高中生用Minecraft来测试AI生成建筑也太有创意了吧!😂 传统AI评测标准太死板了,确实需要这种更直观有趣的方式。不过我很好奇评判标准是什么,是美观度还是还原度?也想试试看用我的世界来测试Stable Diffusion效果
![JasonJohnson]()
This high school kid building an AI Minecraft challenge site is wild! 🧱 Makes me wonder how far AI can push creativity in games. Could it outbuild my epic castle? 😎
Kreatives KI-Benchmarking mit Minecraft
Da traditionelle KI-Benchmarking-Methoden nicht ausreichen, erkunden Entwickler innovative Ansätze, um die Leistungsfähigkeit generativer KI-Modelle zu bewerten. Eine solche kreative Methode nutzt Minecraft, das beliebte Sandbox-Spiel von Microsoft. Eine Gruppe von Entwicklern hat Minecraft Benchmark, oder MC-Bench, ins Leben gerufen, eine Plattform, auf der KI-Modelle in Wettbewerben antreten, um Minecraft-Bauten basierend auf vorgegebenen Aufgaben zu erstellen.
Auf MC-Bench können Nutzer abstimmen, welche Kreation eines KI-Modells ihnen besser gefällt, und erst nach ihrer Abstimmung erfahren sie, welches Modell welchen Bau erstellt hat. Dieser interaktive Ansatz bindet nicht nur die Gemeinschaft ein, sondern bietet auch eine einzigartige Möglichkeit, KI-Fähigkeiten zu bewerten.
Adi Singh, ein Schüler der 12. Klasse und Initiator von MC-Bench, glaubt, dass die weitreichende Bekanntheit von Minecraft entscheidend ist. Als meistverkauftes Videospiel aller Zeiten ist es vielen vertraut, was es Menschen erleichtert, die Qualität von KI-generierten Bauten zu beurteilen, selbst wenn sie das Spiel nicht selbst gespielt haben. „Minecraft ermöglicht es den Menschen, den Fortschritt [der KI-Entwicklung] viel einfacher zu sehen“, erklärte Singh gegenüber TechCrunch. „Die Menschen sind an Minecraft gewöhnt, an das Aussehen und die Atmosphäre.“
MC-Bench wird von einem Team aus acht freiwilligen Mitwirkenden unterstützt. Unternehmen wie Anthropic, Google, OpenAI und Alibaba haben ihre Produkte für die Durchführung von Benchmark-Aufgaben bereitgestellt, sind aber ansonsten nicht am Projekt beteiligt.
Singh plant, MC-Bench über einfache Bauten hinaus auf komplexere, zielorientierte Aufgaben auszuweiten. „Spiele könnten ein Medium sein, um agentisches Denken zu testen, das sicherer ist als im echten Leben und besser kontrollierbar für Testzwecke, was es in meinen Augen idealer macht“, sagte er.
Weitere Spiele als KI-Benchmarks
Neben Minecraft wurden auch andere Spiele wie Pokémon Red, Street Fighter und Pictionary als experimentelle Benchmarks für KI genutzt. Die Herausforderung beim Benchmarking von KI liegt in ihrer Komplexität, da traditionelle standardisierte Tests oft KI-Modelle begünstigen, die aufgrund ihrer Trainingsmethoden in engen Problemlösungsbereichen wie Auswendiglernen oder einfacher Extrapolation glänzen.
Zum Beispiel kann OpenAI's GPT-4 im LSAT in der 88. Perzentile punkten, hat aber Schwierigkeiten mit einfacheren Aufgaben wie dem Zählen der Rs in „strawberry“. Ähnlich erreichte Anthropic's Claude 3.7 Sonnet eine Genauigkeit von 62,3 % bei einem Software-Engineering-Benchmark, scheitert aber beim Spielen von Pokémon im Vergleich zu den meisten Fünfjährigen.
MC-Bench: Mehr als nur ein Programmier-Benchmark
Technisch gesehen ist MC-Bench ein Programmier-Benchmark, da es von KI-Modellen verlangt, Code zu schreiben, um Bauten wie „Frosty der Schneemann“ oder „eine charmante tropische Strandhütte an einem unberührten Sandstrand“ zu erstellen. Der Reiz der Plattform liegt jedoch in ihrer Zugänglichkeit. Es ist für Nutzer einfacher, die visuelle Qualität eines Baus zu bewerten, als Code zu analysieren, was die Reichweite des Projekts und das Potenzial für die Datensammlung zur Modellleistung erweitert.
Die Debatte darüber, ob diese Bewertungen die tatsächliche Nützlichkeit von KI widerspiegeln, geht weiter. Singh glaubt jedoch, dass sie ein starker Indikator sind. „Die aktuelle Rangliste spiegelt meine eigene Erfahrung mit der Nutzung dieser Modelle ziemlich genau wider, was bei vielen reinen Text-Benchmarks nicht der Fall ist“, sagte er. „Vielleicht könnte [MC-Bench] für Unternehmen nützlich sein, um zu wissen, ob sie in die richtige Richtung gehen.“








 Apple Smart Glasses könnten auf der WWDC27 vorgestellt werden und dabei den Schutz der Privatsphäre in den Mittelpunkt stellen
Bloombergs Mark Gurman berichtet, dass Apples Smart Glasses mit dem Codenamen N50 im Juni 2027 auf der WWDC27 vorgestellt werden sollen, wobei ein Verkaufsstart im Herbst 2027 erwartet wird. Ursprünglich für Ende dieses Jahres und Anfang 2027 geplant
 Inside Details Exposed About Next-Gen Gemini: Strained Computing Power, Internal Teams Disagreed on Development Priorities and Resource Allocation
Berichten zufolge wurde der Start des hocherwarteten Next-Generation-Gemini-Modells von Google verschoben. Interne Uneinigkeiten über Entwicklungsprioritäten und Ressourcenallokation, kombiniert mit begrenzter Rechenkapazität und komplexen Genehmigun
 OpenAI entkräftet Bedenken bezüglich des verlangsamen Wachstums und erklärt, dass mehrere Geschäftsbereiche ihre Expansion beschleunigen
Als Reaktion auf externe Kritik bezüglich des nachlassenden Umsatzwachstums und verpasster interner Zielvorgaben gab der KI-Pionier OpenAI am Dienstag, den 28. April, eine selbstbewusste Erklärung ab. Das Unternehmen präzisierte, dass seine Verbrauch

2026 Neueste Besten Top-Bewerteten KI-Melodie-Schreibtools für Songentwürfe! XIX.AI hat eine hochleistungsfähige, bahnbrechende Kollektion zusammengestellt, die strengen Praxistests unterzogen wurde, um das beste Schreiberlebnis zu liefern. Sie finden detaillierte kostenlose versus kostenpflichtige Vergleiche, präzise Ranglisten und unbedingt auszuprobierende Optionen, die darauf ausgelegt sind, Ihnen zu helfen, beeindruckende Songentwürfe mühelos zu erstellen und Ihre kreative Produktivität erheblich zu steigern. Entdecken Sie jetzt Ihr perfektes Tool!
8 Tools
xix.ai

2026 Neueste Besten Top-bewerteten KI-Konversationstrainer-Tools für Vorstellungsgesprächspraxis sind hier auf XIX.AI! Diese kuratierte Sammlung enthält leistungsstarke, bahnbrechende Tools, die strengen Praxistests unterzogen wurden, um präzises Feedback zu liefern. Sie finden einen Vergleich zwischen kostenlosen und kostenpflichtigen Optionen sowie detaillierte Rankings, die Ihnen helfen, die empfehlenswerte Option zu wählen, die Ihr Selbstvertrauen und Ihre Fähigkeiten verbessert. Entdecken Sie jetzt Ihr perfektes Tool für den Erfolg im Vorstellungsgespräch!
12 Tools
xix.ai

Die besten und am besten bewerteten KI-Tools für den Stiltransfer im Jahr 2026 – ideal für kreative Experimente! XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung unverzichtbarer Tools zusammengestellt, die in Praxistests und strengen Bewertungen außergewöhnliche Ergebnisse liefern. Diese Top-Lösungen helfen Kreativen dabei, ihre Produktivität deutlich zu steigern, indem sie die Erstellung von Inhalten beschleunigen und unendliche kreative Möglichkeiten eröffnen. Entdecken Sie jetzt Ihr perfektes Tool und legen Sie noch heute los!
9 Tools
xix.ai

Die besten und am besten bewerteten KI-Tools für Sprechblasen zum visuellen Storytelling des Jahres 2026 finden Sie hier auf XIX.AI! Diese sorgfältig zusammengestellte Sammlung umfasst leistungsstarke, bahnbrechende Tools, die Kreativen dabei helfen, ihre Produktivität zu steigern und kreative Blockaden zu überwinden. Holen Sie sich einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, sehen Sie sich Praxistests an und werfen Sie einen Blick auf die aktuellen Rankings, um die unverzichtbaren Lösungen zu finden, die sich perfekt für die Gestaltung fesselnder visueller Erzählungen eignen. Stöbern Sie jetzt und entdecken Sie Ihr ideales Tool!
10 Tools
xix.ai

Die besten und am besten bewerteten KI-Tools zur Zusammenfassung von Besprechungen im Jahr 2026 für eine übersichtliche Nachverfolgung von Entscheidungen und müheloses Follow-up. Diese sorgfältig zusammengestellte Liste präsentiert leistungsstarke, bahnbrechende Lösungen, die die Produktivität drastisch steigern, indem sie Besprechungsnotizen automatisieren, wichtige Aktionspunkte identifizieren und die Teamkoordination projektübergreifend optimieren. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten sowie Praxistests und wöchentlich aktualisierte Rankings, die Ihnen helfen, das perfekte Tool zu finden. Entdecken Sie es jetzt und nutzen Sie Ihren KI-Vorteil!
9 Tools
xix.ai

2026 – Die neuesten, besten und am höchsten bewerteten Tools für die Reinigung von KI-Daten, um fehlende Werte sowie Duplikate schnell zu beheben. Diese sorgfältig zusammengestellte Liste präsentiert leistungsstarke Lösungen, die die Produktivität erheblich steigern. Jedes Tool wurde in der Praxis gründlich getestet, um seine Zuverlässigkeit zu gewährleisten. Holen Sie sich einen kostenlosen Vergleich zwischen kostenloser und kostenpflichtiger Variante und entdecken Sie das für Ihre Bedürfnisse beste Tool. Entdecken Sie es jetzt auf XIX.AI, um Ihren Vorteil in der KI-Branche zu erlangen.
11 Tools
xix.ai

Interesting approach! Using Minecraft for AI benchmarking sounds way more engaging than standard tests. Wonder if this could lead to AI that actually helps design game worlds? The student's project is a cool example of how gaming and AI research can mix. Hope they share the results! 🎮
高校生がAI建築チャレンジのサイトを作ったのか…!Minecraftの世界でAIの創造性を測るってアイデア、すごく面白いな。でも、これって結局マイクロソフトのプロモーションみたいなものじゃないの?AIがどんどんゲーム内に溶け込んでいくの、ちょっと怖い気もする😅 未来のゲームはすべてAIが作っちゃうのかな?
AIが建築対決するなんて面白すぎる!🏗️ Minecraftでベンチマークを取る発想が新鮮だけど、これってゲームバランス崩さないのかな?ちょっと心配…
É sempre incrível ver jovens inovando com IA! Alguém já testou se esses desafios do Minecraft realmente conseguem medir bem a criatividade dos modelos? Ou será que é só mais uma moda passageira? 😅
这个高中生用Minecraft来测试AI生成建筑也太有创意了吧!😂 传统AI评测标准太死板了,确实需要这种更直观有趣的方式。不过我很好奇评判标准是什么,是美观度还是还原度?也想试试看用我的世界来测试Stable Diffusion效果
This high school kid building an AI Minecraft challenge site is wild! 🧱 Makes me wonder how far AI can push creativity in games. Could it outbuild my epic castle? 😎












