


 Heim
NVIDIA stellt das einheitliche Audio-Intelligenzmodell Nemotron-Labs-Audex-30B-A3B vor
Während multimodale große Modelle rasch voranschreiten, werden die Fähigkeiten zur Audiobearbeitung häufig beeinträchtigt – viele Modelle verbessern das Audioverständnis auf Kosten der Textlogik. Um dies zu adressieren, haben NVIDIA-Forscher Nemotron-Labs-Audex-30B-A3B (Audex) eingeführt, ein einheitliches Audio-Text-Großes Sprachmodell, das darauf ausgelegt ist, diese Lücke zu schließen.
Audex verwendet ein schlankes und effizientes Design, das auf einer robusten reinen Text-Mixture-of-Experts-(MoE)-Architektur basiert. Durch die Nutzung eines einzigen Transformer-Decoders verarbeitet es Text und quantisierte Audiokenne gleichzeitig. Dieser Ansatz projiziert Audioeingaben in den Text-Embedding-Raum und gewährleistet so eine nahtlose Integration in bestehende LLM-Infrastrukturen für multimodale Aufgaben sowie eine echte tiefe Integration.
Das Training umfasste umfangreiche Datensätze mit 157,4 Milliarden Audiokennen und 320,5 Milliarden Texttoken. Durch mehrstufiges überwachtes Training, reinen Text-Cascade-Verstärkungslernen und wissensbasierte Wissensdistillation in mehreren Domänen erreicht Audex branchenführende Leistungen im Audioverständnis, Spracherkennung, Übersetzung und Generierung. Entscheidend ist, dass es die Kernfähigkeiten des ursprünglichen LLMs in Bezug auf Schlussfolgerung, Ausrichtung, Wissensabruf und Langtextverarbeitung mit minimaler Beeinträchtigung bewahrt.
Als Open-Source-Modell markiert Audex einen bedeutenden Meilenstein für den Bereich der Sprachtechnologie. Jenseits theoretischer Forschung bietet es eine ausgereifte Lösung für Entwickler, um direkt zu evaluieren und bereitzustellen. Für diejenigen, die komplexe Audiointeraktionen verwalten, bietet Audex eine ausgewogene Option, die die Leistung verbessert und gleichzeitig neue Wege für die Forschung zur multimodalen Intelligenz eröffnet.
Verwandter Artikel
 Fireworks AI stellt FireRouter mit Opus vor: Reduziert die Encodierungskosten um 57 % bei minimaler Genauigkeitsverlust
Fireworks AI hat FireRouter mit Opus eingeführt, das erste cache-bewusste Routing-System der Branche, das speziell für die Claude-Opus-Serie entwickelt wurde. Jetzt über einen serverlosen Endpunkt verfügbar, durchlief dieses unabhängige Routing-Model
Wie man Core Web Vitals für Mobile SEO behebt
Lokales SEO verbessern: Aufbau Ihrer Google-Entitäts-Cloud-Drive-StacksInhaltsverzeichnis:EinführungVerständnis von Google Entity Cloud StackingHauptvorteile von Google Entity Cloud StackingErste Schritte mit Google Entity Cloud Stacks 4.1. Opti
Moonshot AI sammelt über 3,5 Milliarden US-Dollar in der Serie F ein und erreicht eine Bewertung von 35 Milliarden US-Dollar.
Moonshot AIs Kimi hat erfolgreich seine Series-F-Finanzierungsrunde abgeschlossen und dabei mehr als 3,5 Milliarden US-Dollar gesichert, was einer Bewertung nach der Finanzierung von 35 Milliarden US-Dollar entspricht, wie Sci-Tech Daily berichtet.G
Empfehlungen zu verwandten Spezialthemen
Chatbot
 KI-basierte Live-Chat-Routing-Tools für E-Commerce-Warteschlangen, VIP-Kunden und Rückgabeanfragen
2026: Die neuesten, besten und am besten bewerteten KI-Live-Chat-Routing-Tools für E-Commerce-Warteschlangen, VIP-Käufer und Rückgabeanfragen. Diese sorgfältig zusammengestellte Liste enthält leistungsstarke, bahnbrechende Lösungen, die in Praxistests die Produktivität drastisch gesteigert haben. Sie umfasst einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten sowie detaillierte Rankings, die Ihnen helfen, die perfekte Lösung zu finden. XIX.AI sticht als vertrauenswürdiger Anbieter in diesem Bereich hervor. Entdecken Sie das Angebot jetzt und sichern Sie sich Ihren KI-Vorteil!
 9 Tools
 xix.ai
Schreiben
Die besten KI-Tools zur Textbearbeitung für ESL-Autoren: Tonfall, Grammatik und Lesefluss verbessern
Die besten und am besten bewerteten KI-Korrekturtools für ESL-Autoren des Jahres 2026 finden Sie hier auf XIX.AI! Diese sorgfältig zusammengestellte Liste enthält leistungsstarke, bahnbrechende Tools, die in der Praxis getestet wurden, um ihre Genauigkeit zu gewährleisten. Hier finden Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten sowie detaillierte Rankings, die Ihnen dabei helfen, die Lösung zu finden, die Sie unbedingt ausprobieren sollten, um Ihren Schreibstil, Ihre Grammatik und den Lesefluss perfekt zu verbessern. Entdecken Sie die Tools jetzt und sichern Sie sich Ihren KI-Vorteil!
9 Tools
xix.ai
Softwareentwicklung
Die besten KI-Tools zur Fehlerklassifizierung für Entwicklerteams
Die besten und am besten bewerteten KI-Tools zur Fehlertriage für Entwicklerteams im Jahr 2026! XIX.AI hat eine leistungsstarke, bahnbrechende Auswahl an Tools zusammengestellt, die Sie unbedingt ausprobieren sollten. Diese Tools durchlaufen strenge Praxistests, um eine genaue Fehleranalyse und eine effiziente Fehlerbehebung zu gewährleisten. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten sowie detaillierte Rankings, die Ihnen helfen, die perfekte Lösung zu finden, mit der Sie die Produktivität Ihres Teams deutlich steigern können. Entdecken Sie die Tools jetzt und sichern Sie sich Ihren KI-Wettbewerbsvorteil!
9 Tools
xix.ai
Bildbearbeitung
Die besten KI-Porträtoptimierer: Beleuchtung, Hautton und Schärfe verbessern
2026: Die neuesten, besten und am besten bewerteten KI-Porträtoptimierer, ausgewählt für ultimative Bildqualität. Diese leistungsstarken Tools liefern bahnbrechende Ergebnisse, indem sie Beleuchtung, Hautton und Schärfe mühelos verbessern – perfekt für Kreative, die Fotos schnell optimieren müssen. XIX.AI bietet einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten sowie Praxistests und wöchentlich aktualisierte Ranglisten. Entdecken Sie noch heute das perfekte Tool, um Ihren KI-Vorteil zu nutzen. Jetzt entdecken!
7 Tools
xix.ai
Schreiben
KI-basierte Tools zur Erstellung technischer Dokumentationen für API-Handbücher, Versionshinweise und Einführungsunterlagen
2026: Die neuesten, besten und am besten bewerteten KI-Tools für technische Dokumentation – für API-Anleitungen, Versionshinweise und Onboarding-Dokumente. Diese sorgfältig zusammengestellte Liste enthält leistungsstarke, bahnbrechende Lösungen, die die Erstellung von Inhalten optimieren, die Effizienz beim Verfassen von Texten steigern und in allen Projektphasen Zeit sparen. XIX.AI bietet wöchentlich aktualisierte Rankings sowie Vergleichsergebnisse zwischen kostenlosen und kostenpflichtigen Angeboten, die auf Praxistests basieren. Entdecken Sie jetzt Ihr perfektes Tool und nutzen Sie Ihren KI-Vorteil.
10 Tools
xix.ai
Design
Tools zur Erstellung von Wireframes für KI-Dashboards für B2B-Produktteams
Die besten KI-Tools für das Wireframing von Dashboards für B2B-Produktteams im Jahr 2026! XIX.AI hat eine Liste der besten leistungsstarken, bahnbrechenden Tools zusammengestellt, die strengen Praxistests unterzogen wurden und außergewöhnliche Ergebnisse liefern. Sie finden detaillierte Vergleichsinformationen zu kostenlosen und kostenpflichtigen Angeboten sowie wöchentlich aktualisierte Rankings, die aufzeigen, welche Optionen den größten Nutzen für die Optimierung von Produktdesign-Workflows und die Steigerung der Gesamtproduktivität bieten. Besonders empfehlenswerte Optionen sind deutlich hervorgehoben, damit Sie Ihren KI-Vorteil voll ausschöpfen können. Entdecken Sie sie jetzt!
11 Tools
xix.ai

 Kommentare (0)
Während multimodale große Modelle rasch voranschreiten, werden die Fähigkeiten zur Audiobearbeitung häufig beeinträchtigt – viele Modelle verbessern das Audioverständnis auf Kosten der Textlogik. Um dies zu adressieren, haben NVIDIA-Forscher Nemotron-Labs-Audex-30B-A3B (Audex) eingeführt, ein einheitliches Audio-Text-Großes Sprachmodell, das darauf ausgelegt ist, diese Lücke zu schließen.
Audex verwendet ein schlankes und effizientes Design, das auf einer robusten reinen Text-Mixture-of-Experts-(MoE)-Architektur basiert. Durch die Nutzung eines einzigen Transformer-Decoders verarbeitet es Text und quantisierte Audiokenne gleichzeitig. Dieser Ansatz projiziert Audioeingaben in den Text-Embedding-Raum und gewährleistet so eine nahtlose Integration in bestehende LLM-Infrastrukturen für multimodale Aufgaben sowie eine echte tiefe Integration.
Das Training umfasste umfangreiche Datensätze mit 157,4 Milliarden Audiokennen und 320,5 Milliarden Texttoken. Durch mehrstufiges überwachtes Training, reinen Text-Cascade-Verstärkungslernen und wissensbasierte Wissensdistillation in mehreren Domänen erreicht Audex branchenführende Leistungen im Audioverständnis, Spracherkennung, Übersetzung und Generierung. Entscheidend ist, dass es die Kernfähigkeiten des ursprünglichen LLMs in Bezug auf Schlussfolgerung, Ausrichtung, Wissensabruf und Langtextverarbeitung mit minimaler Beeinträchtigung bewahrt.
Als Open-Source-Modell markiert Audex einen bedeutenden Meilenstein für den Bereich der Sprachtechnologie. Jenseits theoretischer Forschung bietet es eine ausgereifte Lösung für Entwickler, um direkt zu evaluieren und bereitzustellen. Für diejenigen, die komplexe Audiointeraktionen verwalten, bietet Audex eine ausgewogene Option, die die Leistung verbessert und gleichzeitig neue Wege für die Forschung zur multimodalen Intelligenz eröffnet.








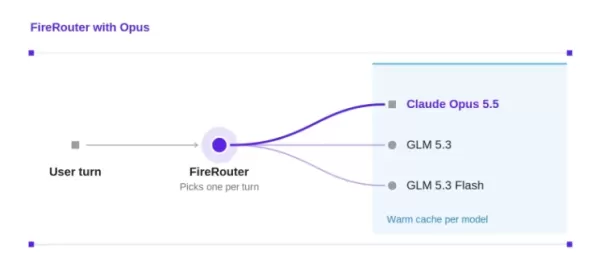 Fireworks AI stellt FireRouter mit Opus vor: Reduziert die Encodierungskosten um 57 % bei minimaler Genauigkeitsverlust
Fireworks AI hat FireRouter mit Opus eingeführt, das erste cache-bewusste Routing-System der Branche, das speziell für die Claude-Opus-Serie entwickelt wurde. Jetzt über einen serverlosen Endpunkt verfügbar, durchlief dieses unabhängige Routing-Model
 Wie man Core Web Vitals für Mobile SEO behebt
Lokales SEO verbessern: Aufbau Ihrer Google-Entitäts-Cloud-Drive-StacksInhaltsverzeichnis:EinführungVerständnis von Google Entity Cloud StackingHauptvorteile von Google Entity Cloud StackingErste Schritte mit Google Entity Cloud Stacks 4.1. Opti
 Moonshot AI sammelt über 3,5 Milliarden US-Dollar in der Serie F ein und erreicht eine Bewertung von 35 Milliarden US-Dollar.
Moonshot AIs Kimi hat erfolgreich seine Series-F-Finanzierungsrunde abgeschlossen und dabei mehr als 3,5 Milliarden US-Dollar gesichert, was einer Bewertung nach der Finanzierung von 35 Milliarden US-Dollar entspricht, wie Sci-Tech Daily berichtet.G
2026: Die neuesten, besten und am besten bewerteten KI-Live-Chat-Routing-Tools für E-Commerce-Warteschlangen, VIP-Käufer und Rückgabeanfragen. Diese sorgfältig zusammengestellte Liste enthält leistungsstarke, bahnbrechende Lösungen, die in Praxistests die Produktivität drastisch gesteigert haben. Sie umfasst einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten sowie detaillierte Rankings, die Ihnen helfen, die perfekte Lösung zu finden. XIX.AI sticht als vertrauenswürdiger Anbieter in diesem Bereich hervor. Entdecken Sie das Angebot jetzt und sichern Sie sich Ihren KI-Vorteil!
9 Tools
xix.ai
Die besten und am besten bewerteten KI-Korrekturtools für ESL-Autoren des Jahres 2026 finden Sie hier auf XIX.AI! Diese sorgfältig zusammengestellte Liste enthält leistungsstarke, bahnbrechende Tools, die in der Praxis getestet wurden, um ihre Genauigkeit zu gewährleisten. Hier finden Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten sowie detaillierte Rankings, die Ihnen dabei helfen, die Lösung zu finden, die Sie unbedingt ausprobieren sollten, um Ihren Schreibstil, Ihre Grammatik und den Lesefluss perfekt zu verbessern. Entdecken Sie die Tools jetzt und sichern Sie sich Ihren KI-Vorteil!
9 Tools
xix.ai
Die besten und am besten bewerteten KI-Tools zur Fehlertriage für Entwicklerteams im Jahr 2026! XIX.AI hat eine leistungsstarke, bahnbrechende Auswahl an Tools zusammengestellt, die Sie unbedingt ausprobieren sollten. Diese Tools durchlaufen strenge Praxistests, um eine genaue Fehleranalyse und eine effiziente Fehlerbehebung zu gewährleisten. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten sowie detaillierte Rankings, die Ihnen helfen, die perfekte Lösung zu finden, mit der Sie die Produktivität Ihres Teams deutlich steigern können. Entdecken Sie die Tools jetzt und sichern Sie sich Ihren KI-Wettbewerbsvorteil!
9 Tools
xix.ai
2026: Die neuesten, besten und am besten bewerteten KI-Porträtoptimierer, ausgewählt für ultimative Bildqualität. Diese leistungsstarken Tools liefern bahnbrechende Ergebnisse, indem sie Beleuchtung, Hautton und Schärfe mühelos verbessern – perfekt für Kreative, die Fotos schnell optimieren müssen. XIX.AI bietet einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten sowie Praxistests und wöchentlich aktualisierte Ranglisten. Entdecken Sie noch heute das perfekte Tool, um Ihren KI-Vorteil zu nutzen. Jetzt entdecken!
7 Tools
xix.ai
2026: Die neuesten, besten und am besten bewerteten KI-Tools für technische Dokumentation – für API-Anleitungen, Versionshinweise und Onboarding-Dokumente. Diese sorgfältig zusammengestellte Liste enthält leistungsstarke, bahnbrechende Lösungen, die die Erstellung von Inhalten optimieren, die Effizienz beim Verfassen von Texten steigern und in allen Projektphasen Zeit sparen. XIX.AI bietet wöchentlich aktualisierte Rankings sowie Vergleichsergebnisse zwischen kostenlosen und kostenpflichtigen Angeboten, die auf Praxistests basieren. Entdecken Sie jetzt Ihr perfektes Tool und nutzen Sie Ihren KI-Vorteil.
10 Tools
xix.ai
Die besten KI-Tools für das Wireframing von Dashboards für B2B-Produktteams im Jahr 2026! XIX.AI hat eine Liste der besten leistungsstarken, bahnbrechenden Tools zusammengestellt, die strengen Praxistests unterzogen wurden und außergewöhnliche Ergebnisse liefern. Sie finden detaillierte Vergleichsinformationen zu kostenlosen und kostenpflichtigen Angeboten sowie wöchentlich aktualisierte Rankings, die aufzeigen, welche Optionen den größten Nutzen für die Optimierung von Produktdesign-Workflows und die Steigerung der Gesamtproduktivität bieten. Besonders empfehlenswerte Optionen sind deutlich hervorgehoben, damit Sie Ihren KI-Vorteil voll ausschöpfen können. Entdecken Sie sie jetzt!
11 Tools
xix.ai












