


 Heim
Liquid AI veröffentlicht das hybride Expertenmodell LFM2.5 als Open-Source-Software für Edge-AI
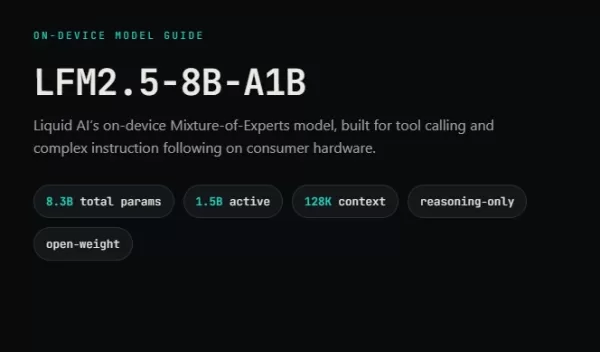
Das KI-Startup Liquid AI hat heute sein neuestes großes Edge-Modell, LFM2.5-8B-A1B , offiziell veröffentlicht und als Open Source zur Verfügung gestellt. Das Modell wurde für den Aufruf von Tools und die Ausführung komplexer Anweisungen auf handelsüblicher Hardware entwickelt und steigert die Leistung bei Schlussfolgerungen und Inferenz auf Edge-Geräten, während die Rechenkosten extrem niedrig bleiben.
Architektonisch basiert es auf einem spärlichen „Mixture-of-Experts“-Design (MoE) mit insgesamt 8,3 Milliarden Parametern. Dank dieser Spärlichkeit werden pro Token nur 1,5 Milliarden Parameter aktiviert, was einen reibungslosen lokalen Betrieb auf Smartphones, Laptops und ähnlichen Geräten ermöglicht.
Erweiterter Kontext und stärkere Schlussfolgerungsfähigkeit
Im Vergleich zu seinem Vorgänger erweitert LFM2.5 das Kontextfenster von 32K auf 128K Token und erhöht die Vortrainingsdaten von 12T auf 38T Token. Als reines Inferenzmodell erzeugt es eine explizite Argumentationskette, bevor es die endgültige Antwort liefert. Sein hochkomprimiertes Vokabular verarbeitet effizient neun Sprachen, darunter Chinesisch und Arabisch.
Um logische Endlosschleifen und Halluzinationen bei langen Schlussfolgerungen zu reduzieren, wandte das Entwicklungsteam während des Trainings zweistufiges Reinforcement Learning (RL) an. Die Präferenzoptimierung reduziert effektiv „Endlosschleifen“ bei langkettigen Schlussfolgerungen, während ein spezieller Anti-Halluzinations-Belohnungsmechanismus es dem Modell ermöglicht, Fragen außerhalb seiner Wissensbasis aktiv abzulehnen.
Leistungsstarke Edge-Performance und breite Ökosystemunterstützung
In puncto Leistung hat LFM2.5 explosive Fortschritte erzielt. Seine Ergebnisse bei Benchmarks für logisches Schlussfolgern und Anti-Halluzination übertreffen seinen Vorgänger bei weitem, und es kann sogar mit größeren Modellen beim Befolgen von Anweisungen mithalten. Beim Aufrufen von Tools gibt das Modell standardmäßig effiziente Python-Funktionsaufrufe aus und unterstützt den nahtlosen Wechsel zum JSON-Format über Systemaufforderungen.
Das Modell wurde am Tag der Veröffentlichung von den wichtigsten Inferenz-Frameworks vollständig unterstützt, darunter llama.cpp, MLX, vLLM und SGLang. In Hardwaretests erreichte es Dekodierungsgeschwindigkeiten von bis zu 253 Byte pro Sekunde auf dem M5 Max-Chip und etwa 30 Byte pro Sekunde auf Mobilgeräten, wodurch Datenschutz und Effizienz für Edge-Bereitstellungen perfekt in Einklang gebracht werden.
Verwandter Artikel
 DeepMind-CEO Hassabis: Ich schlafe sechs Stunden pro Tag und fühle mich normalerweise gegen 1 Uhr nachts energiegeladen.
Fortune hat kürzlich ein Interview mit Demis Hassabis, dem CEO von Google DeepMind, veröffentlicht, das seinen unkonventionellen Ansatz zu Erholung und Produktivität offenbart. Hassabis gab bekannt, dass er sehr wenig schläft und seine wachen Stunden
OpenAI und Anthropic kämpfen trotz Umsatzrückgängen um Marktanteile
Obwohl jüngste Berichte darauf hindeuten, dass OpenAI seine Umsatzziele verfehlt hat, was an diesem Dienstag Druck auf die Technologieaktien ausübte, zeigen sich private Investoren in KI-Labore weiter
Einhaltung der Vorschriften für autonome Fahrzeuge in Kalifornien: Eine neue Ära von Bußgeldern, Geofences und 1 Million Meilen
Guident betreibt einen AuveTech-Shuttle in Südflorida und verwaltet mithilfe seiner Fernüberwachungstechnologie eine vier Meilen lange Strecke in West Palm Beach sowie eine eine Meile lange Strecke in
Empfehlungen zu verwandten Spezialthemen
Musikkomposition
 KI-Tools zur Stim-Trennung für die Remix-Produktion, die Vorbereitung von Samples und Karaoke-Master
Die besten und am besten bewerteten KI-Tools zur Stem-Trennung des Jahres 2026 – speziell ausgewählt für Remix-Produktionen, die Vorbereitung von Samples und Karaoke-Masters. Diese leistungsstarken, bahnbrechenden Tools haben sich in der Praxis bewährt und bieten präzise Audioisolierung, wodurch die Produktivität erheblich gesteigert wird. XIX.AI stellt einen wöchentlich aktualisierten Vergleichsleitfaden zwischen kostenlosen und kostenpflichtigen Lösungen bereit, der Ihnen hilft, die für Ihre Anforderungen passende Lösung zu finden, die Sie unbedingt ausprobieren sollten. Entdecken Sie ihn jetzt und sichern Sie sich Ihren KI-Vorteil.
 8 Tools
 xix.ai
Datenanalyse
KI-basierte SQL-Copiloten für Umsatz-Dashboards, Kanalanalysen sowie Produktmetriken
2026: Die neuesten und besten AI-SQL-Copiloten – alle in der Rangliste ganz oben! XIX.AI sammelt eine leistungsstarke Auswahl an Tools, die wöchentlich mit aktualisierten Tests aus der Praxis erweitert wird. Mit diesen unverzichtbaren Werkzeugen können Sie präzise Umsatzübersichten erstellen, Verkaufsprozesse analysieren sowie Produktmetriken schnell überwachen und so Ihre Produktivität erheblich steigern. Entdecken Sie jetzt das perfekte Tool für datenbasierte Entscheidungsfindung! 238 Zeichen
9 Tools
xix.ai
Musikkomposition
Die besten KI-Tools zum Komponieren von Melodien für Songentwürfe
2026 Neueste Besten Top-Bewerteten KI-Melodie-Schreibtools für Songentwürfe! XIX.AI hat eine hochleistungsfähige, bahnbrechende Kollektion zusammengestellt, die strengen Praxistests unterzogen wurde, um das beste Schreiberlebnis zu liefern. Sie finden detaillierte kostenlose versus kostenpflichtige Vergleiche, präzise Ranglisten und unbedingt auszuprobierende Optionen, die darauf ausgelegt sind, Ihnen zu helfen, beeindruckende Songentwürfe mühelos zu erstellen und Ihre kreative Produktivität erheblich zu steigern. Entdecken Sie jetzt Ihr perfektes Tool!
8 Tools
xix.ai
Chatbot
Die besten KI-gestützten Gesprächstrainingstools für Vorstellungsgesprächspraxis
2026 Neueste Besten Top-bewerteten KI-Konversationstrainer-Tools für Vorstellungsgesprächspraxis sind hier auf XIX.AI! Diese kuratierte Sammlung enthält leistungsstarke, bahnbrechende Tools, die strengen Praxistests unterzogen wurden, um präzises Feedback zu liefern. Sie finden einen Vergleich zwischen kostenlosen und kostenpflichtigen Optionen sowie detaillierte Rankings, die Ihnen helfen, die empfehlenswerte Option zu wählen, die Ihr Selbstvertrauen und Ihre Fähigkeiten verbessert. Entdecken Sie jetzt Ihr perfektes Tool für den Erfolg im Vorstellungsgespräch!
12 Tools
xix.ai
Design & Kunst
Die besten KI-Tools für den Stiltransfer für kreative Experimente
Die besten und am besten bewerteten KI-Tools für den Stiltransfer im Jahr 2026 – ideal für kreative Experimente! XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung unverzichtbarer Tools zusammengestellt, die in Praxistests und strengen Bewertungen außergewöhnliche Ergebnisse liefern. Diese Top-Lösungen helfen Kreativen dabei, ihre Produktivität deutlich zu steigern, indem sie die Erstellung von Inhalten beschleunigen und unendliche kreative Möglichkeiten eröffnen. Entdecken Sie jetzt Ihr perfektes Tool und legen Sie noch heute los!
9 Tools
xix.ai
Comic-Erstellung
Die besten KI-Tools für Sprechblasen zum visuellen Geschichtenerzählen
Die besten und am besten bewerteten KI-Tools für Sprechblasen zum visuellen Storytelling des Jahres 2026 finden Sie hier auf XIX.AI! Diese sorgfältig zusammengestellte Sammlung umfasst leistungsstarke, bahnbrechende Tools, die Kreativen dabei helfen, ihre Produktivität zu steigern und kreative Blockaden zu überwinden. Holen Sie sich einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, sehen Sie sich Praxistests an und werfen Sie einen Blick auf die aktuellen Rankings, um die unverzichtbaren Lösungen zu finden, die sich perfekt für die Gestaltung fesselnder visueller Erzählungen eignen. Stöbern Sie jetzt und entdecken Sie Ihr ideales Tool!
10 Tools
xix.ai

 Kommentare (1)
![AlbertWilson]()
Finally, an open-source model that actually runs on my laptop without melting it. No more cloud dependence? Count me in. 😏
Das KI-Startup Liquid AI hat heute sein neuestes großes Edge-Modell,
Architektonisch basiert es auf einem spärlichen „Mixture-of-Experts“-Design (MoE) mit insgesamt 8,3 Milliarden Parametern. Dank dieser Spärlichkeit werden pro Token nur 1,5 Milliarden Parameter aktiviert, was einen reibungslosen lokalen Betrieb auf Smartphones, Laptops und ähnlichen Geräten ermöglicht.
Erweiterter Kontext und stärkere Schlussfolgerungsfähigkeit
Im Vergleich zu seinem Vorgänger erweitert LFM2.5 das Kontextfenster von 32K auf 128K Token und erhöht die Vortrainingsdaten von 12T auf 38T Token. Als reines Inferenzmodell erzeugt es eine explizite Argumentationskette, bevor es die endgültige Antwort liefert. Sein hochkomprimiertes Vokabular verarbeitet effizient neun Sprachen, darunter Chinesisch und Arabisch.
Um logische Endlosschleifen und Halluzinationen bei langen Schlussfolgerungen zu reduzieren, wandte das Entwicklungsteam während des Trainings zweistufiges Reinforcement Learning (RL) an. Die Präferenzoptimierung reduziert effektiv „Endlosschleifen“ bei langkettigen Schlussfolgerungen, während ein spezieller Anti-Halluzinations-Belohnungsmechanismus es dem Modell ermöglicht, Fragen außerhalb seiner Wissensbasis aktiv abzulehnen.
Leistungsstarke Edge-Performance und breite Ökosystemunterstützung
In puncto Leistung hat LFM2.5 explosive Fortschritte erzielt. Seine Ergebnisse bei Benchmarks für logisches Schlussfolgern und Anti-Halluzination übertreffen seinen Vorgänger bei weitem, und es kann sogar mit größeren Modellen beim Befolgen von Anweisungen mithalten. Beim Aufrufen von Tools gibt das Modell standardmäßig effiziente Python-Funktionsaufrufe aus und unterstützt den nahtlosen Wechsel zum JSON-Format über Systemaufforderungen.
Das Modell wurde am Tag der Veröffentlichung von den wichtigsten Inferenz-Frameworks vollständig unterstützt, darunter llama.cpp, MLX, vLLM und SGLang. In Hardwaretests erreichte es Dekodierungsgeschwindigkeiten von bis zu 253 Byte pro Sekunde auf dem M5 Max-Chip und etwa 30 Byte pro Sekunde auf Mobilgeräten, wodurch Datenschutz und Effizienz für Edge-Bereitstellungen perfekt in Einklang gebracht werden.








 DeepMind-CEO Hassabis: Ich schlafe sechs Stunden pro Tag und fühle mich normalerweise gegen 1 Uhr nachts energiegeladen.
Fortune hat kürzlich ein Interview mit Demis Hassabis, dem CEO von Google DeepMind, veröffentlicht, das seinen unkonventionellen Ansatz zu Erholung und Produktivität offenbart. Hassabis gab bekannt, dass er sehr wenig schläft und seine wachen Stunden
 OpenAI und Anthropic kämpfen trotz Umsatzrückgängen um Marktanteile
Obwohl jüngste Berichte darauf hindeuten, dass OpenAI seine Umsatzziele verfehlt hat, was an diesem Dienstag Druck auf die Technologieaktien ausübte, zeigen sich private Investoren in KI-Labore weiter
Einhaltung der Vorschriften für autonome Fahrzeuge in Kalifornien: Eine neue Ära von Bußgeldern, Geofences und 1 Million Meilen
Guident betreibt einen AuveTech-Shuttle in Südflorida und verwaltet mithilfe seiner Fernüberwachungstechnologie eine vier Meilen lange Strecke in West Palm Beach sowie eine eine Meile lange Strecke in

Die besten und am besten bewerteten KI-Tools zur Stem-Trennung des Jahres 2026 – speziell ausgewählt für Remix-Produktionen, die Vorbereitung von Samples und Karaoke-Masters. Diese leistungsstarken, bahnbrechenden Tools haben sich in der Praxis bewährt und bieten präzise Audioisolierung, wodurch die Produktivität erheblich gesteigert wird. XIX.AI stellt einen wöchentlich aktualisierten Vergleichsleitfaden zwischen kostenlosen und kostenpflichtigen Lösungen bereit, der Ihnen hilft, die für Ihre Anforderungen passende Lösung zu finden, die Sie unbedingt ausprobieren sollten. Entdecken Sie ihn jetzt und sichern Sie sich Ihren KI-Vorteil.
8 Tools
xix.ai

2026: Die neuesten und besten AI-SQL-Copiloten – alle in der Rangliste ganz oben! XIX.AI sammelt eine leistungsstarke Auswahl an Tools, die wöchentlich mit aktualisierten Tests aus der Praxis erweitert wird. Mit diesen unverzichtbaren Werkzeugen können Sie präzise Umsatzübersichten erstellen, Verkaufsprozesse analysieren sowie Produktmetriken schnell überwachen und so Ihre Produktivität erheblich steigern. Entdecken Sie jetzt das perfekte Tool für datenbasierte Entscheidungsfindung! 238 Zeichen
9 Tools
xix.ai

2026 Neueste Besten Top-Bewerteten KI-Melodie-Schreibtools für Songentwürfe! XIX.AI hat eine hochleistungsfähige, bahnbrechende Kollektion zusammengestellt, die strengen Praxistests unterzogen wurde, um das beste Schreiberlebnis zu liefern. Sie finden detaillierte kostenlose versus kostenpflichtige Vergleiche, präzise Ranglisten und unbedingt auszuprobierende Optionen, die darauf ausgelegt sind, Ihnen zu helfen, beeindruckende Songentwürfe mühelos zu erstellen und Ihre kreative Produktivität erheblich zu steigern. Entdecken Sie jetzt Ihr perfektes Tool!
8 Tools
xix.ai

2026 Neueste Besten Top-bewerteten KI-Konversationstrainer-Tools für Vorstellungsgesprächspraxis sind hier auf XIX.AI! Diese kuratierte Sammlung enthält leistungsstarke, bahnbrechende Tools, die strengen Praxistests unterzogen wurden, um präzises Feedback zu liefern. Sie finden einen Vergleich zwischen kostenlosen und kostenpflichtigen Optionen sowie detaillierte Rankings, die Ihnen helfen, die empfehlenswerte Option zu wählen, die Ihr Selbstvertrauen und Ihre Fähigkeiten verbessert. Entdecken Sie jetzt Ihr perfektes Tool für den Erfolg im Vorstellungsgespräch!
12 Tools
xix.ai

Die besten und am besten bewerteten KI-Tools für den Stiltransfer im Jahr 2026 – ideal für kreative Experimente! XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung unverzichtbarer Tools zusammengestellt, die in Praxistests und strengen Bewertungen außergewöhnliche Ergebnisse liefern. Diese Top-Lösungen helfen Kreativen dabei, ihre Produktivität deutlich zu steigern, indem sie die Erstellung von Inhalten beschleunigen und unendliche kreative Möglichkeiten eröffnen. Entdecken Sie jetzt Ihr perfektes Tool und legen Sie noch heute los!
9 Tools
xix.ai

Die besten und am besten bewerteten KI-Tools für Sprechblasen zum visuellen Storytelling des Jahres 2026 finden Sie hier auf XIX.AI! Diese sorgfältig zusammengestellte Sammlung umfasst leistungsstarke, bahnbrechende Tools, die Kreativen dabei helfen, ihre Produktivität zu steigern und kreative Blockaden zu überwinden. Holen Sie sich einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, sehen Sie sich Praxistests an und werfen Sie einen Blick auf die aktuellen Rankings, um die unverzichtbaren Lösungen zu finden, die sich perfekt für die Gestaltung fesselnder visueller Erzählungen eignen. Stöbern Sie jetzt und entdecken Sie Ihr ideales Tool!
10 Tools
xix.ai

Finally, an open-source model that actually runs on my laptop without melting it. No more cloud dependence? Count me in. 😏












