


 首页

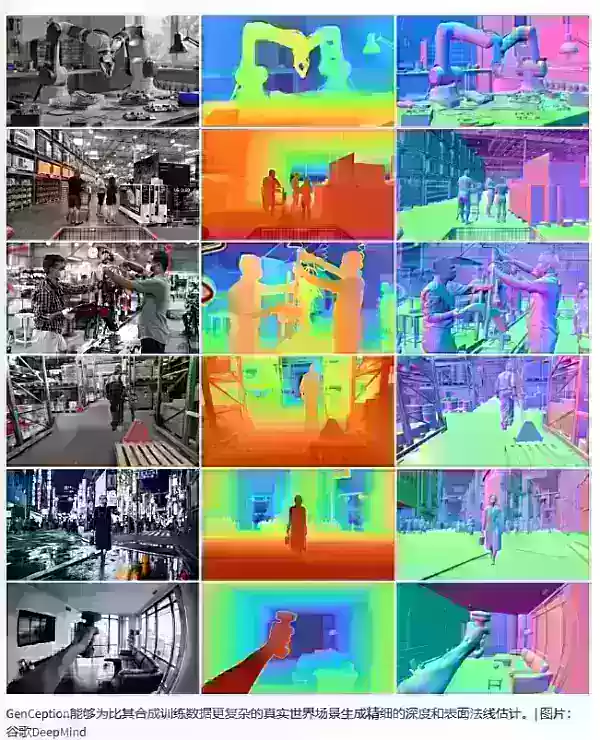
Google DeepMind 发布了 GenCeption 模型,该模型基于预训练的视频生成模型 Wan2.1 构建,在深度估计、图像分割以及 3D 姿态估计方面均展现出接近甚至超越传统模型的性能。其训练仅需 7,500 个合成视频,远少于常规模型,且具备处理现实世界多人物场景的能力。不过,对于每段 81 帧的视频,其推理速度仍存在瓶颈,需要 6 到 10 秒才能完成处理。
评论 (0)
0/300






