首页

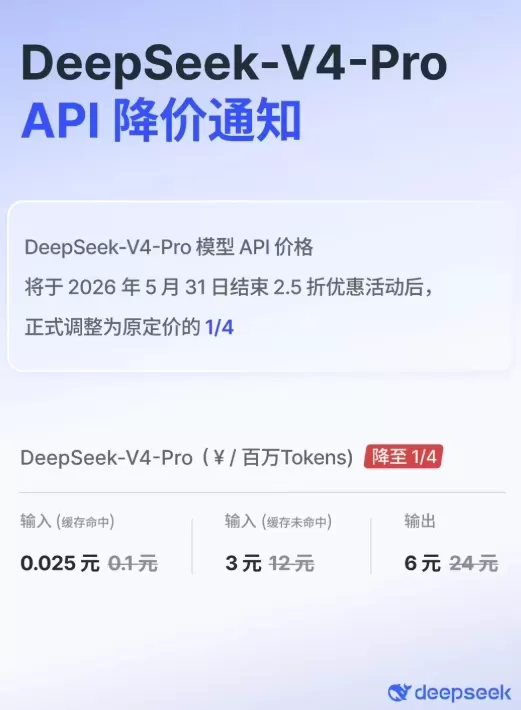
从6月3日起,腾讯云大幅降低了DeepSeek V4大型模型的价格。专业版本的推理成本下降了75%,缓存使用成本减少了97.5%,而Flash模型的缓存成本则下降了90%。这些基于MoE架构、拥有1.6万亿个参数的模型能够支持100万令牌级别的上下文处理。这一举措旨在降低创新门槛,进一步加剧云服务领域中AI应用的竞争态势。
评论 (0)
0/300