首頁

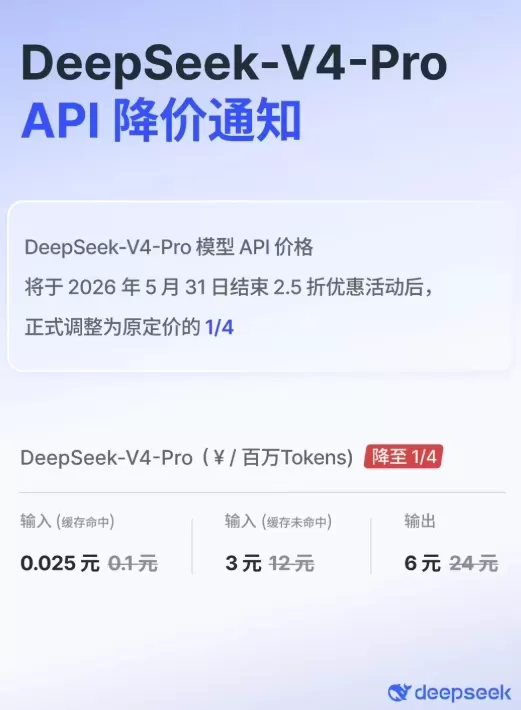
從6月3日起,騰訊雲大幅降低了DeepSeek V4大型模型的價格。專業版本的推理成本下降了75%,快取使用成本減少了97.5%,而Flash模型的快取成本則下降了90%。這些基於MoE架構、擁有1.6萬億個引數的模型能夠支援100萬令牌級別的上下文處理。這一舉措旨在降低創新門檻,進一步加劇雲服務領域中AI應用的競爭態勢。
評論 (0)
0/300