


 首页
字节跳动发布Lance 3B:一款集视觉与语言理解及生成于一体的统一模型
字节跳动研究院已正式将旗下原生统一多模态大模型“Lance”开源。
尽管人工智能行业通常依赖于拥有数千亿甚至数万亿参数的模型,或是由独立组件组合而成的模型,但Lance却代表了一项重大突破。 它在仅拥有3B(30亿)个激活参数这一极其轻量级的规模下,仍能提供完整的功能,有效弥合了“理解模型(VLM)”与“生成模型(DiT/Diffusion)”之间的技术鸿沟。
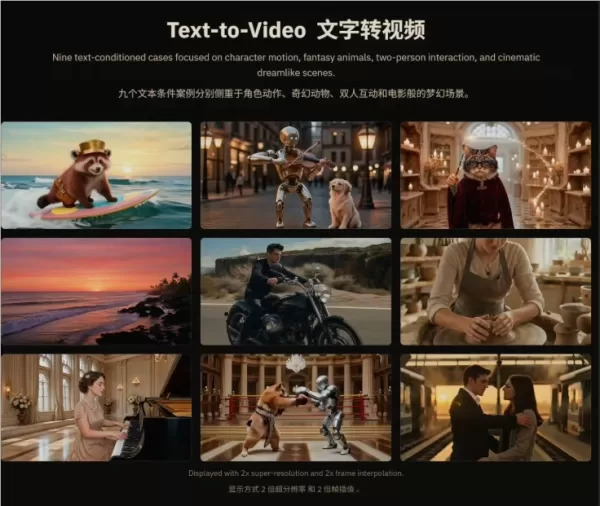
主要亮点:
原生统一:该模型并非拼凑而成,而是从零开始构建,将图像和视频的理解、生成以及跨模态编辑整合到单一系统中。
全面性能:单一模型可无缝处理 $X rightarrow T$(文本/视频理解)、$X rightarrow I$(图像生成/编辑)和 $X rightarrow V$(视频生成/编辑)这三项核心输出任务。
开源且免费:采用许可范围极广的Apache 2.0许可证发布。权重模型已在Hugging Face上完全开放,整个流程仅需128块A100 GPU即可运行,成本适中。
技术解析:它如何在相互矛盾的需求之间实现“同步”?
在传统的人工智能架构中,“理解”与“生成”能力往往存在矛盾:理解任务需要过滤噪声以提取高级语义特征,而生成任务则侧重于低级纹理、几何结构和时间动态。
为解决这一行业性挑战,Lance 采用了巧妙的“共享上下文 + 并行能力解耦”设计:
1. 统一交织序列与双流专家架构
所有文本、图像和视频输入首先被分词并转换为统一的“交错序列”。随后,该序列由双流 MoE(多专家)架构进行处理,使专门负责“理解”和“生成”的专家模块能够独立运行,从而有效解决了能力冲突。
理解侧:文本令牌和视觉输入利用 Qwen2.5-VL 的嵌入层和 ViT 编码器,准确提取高级语义视觉令牌。
生成侧:视觉输入通过 Wan2.2 强大的 3D 因果 VAE 进行压缩,实现 $16 倍$ 的空间下采样和 $4 倍$ 的时间下采样,从而保留了详细的动态连续表示。
2. MaPE(模态感知旋转位置编码)
长序列中混合的视觉令牌(图像、文本和视频)可能导致“边界混淆”幻觉。Lance 引入了 MaPE 机制,该机制为不同的模态组添加了固定的时间偏移量。这种优雅的设计能够在不破坏图像和视频内部结构及时间顺序的前提下,实现强大的空间和时间边界识别。
[Unified Interleaved Sequence] ──► [MaPE Modal Boundary Isolation] ──► [Dual-Stream Expert Architecture (MoE)]
四阶段极限训练:128张GPU的“精简之战”
与大型企业动用数千块GPU的“蛮力美学”形成鲜明对比,Lance的训练过程展现了极高的资金利用效率。整个生命周期严格限制在最多128块GPU的预算内,并经历四个紧密衔接的阶段:
第一阶段:预训练(1.5T 令牌)——处理 10 亿张图像-文本对和 1.4 亿个视频-文本对,为多模态理解奠定坚实基础。
第二阶段:连续训练(3000亿令牌)——整合编辑、主题驱动生成及多模态理解数据,以激发多任务协同效应。
第三阶段:监督式微调(720亿令牌)——大规模注入人类指令,重点关注指令遵循与视觉身份一致性。
第四阶段:强化学习(GRPO算法)——利用基于群组的相对策略优化,并特别采用PaddleOCR作为奖励模型,专门解决文本渲染不准确以及文本与图像对齐错误等AI问题。
卓越成果:3B模型在多个领域击败7B巨头
得益于跨任务数据协同(模型在学习生成时深化理解,在学习理解时提升生成能力),3B规模的Lance在各项基准测试中均表现卓越:
视频生成(VBench):得分85.11分! 它超越了TUNA(84.06)等同类全能型模型,并优于HunyuanVideo(83.33)和Wan2.1-T2V(83.69)等专业视频生成模型。
图像生成(GenEval):得分0.90,稳居全球开源模型前列。
视频理解(MVBench):得分62.0分,显著超过了专用理解模型Show-o2(7B,55.7分),而该模型的规模是Lance的两倍。
行业震动:多模态应用的部署成本将大幅下降
Lance的开源发布将对行业产生重大颠覆,特别是对于AI短片、智能代理(Agent)协作和交互式媒体等蓬勃发展的领域。
此前,要开发一款既能理解剧本、生成分镜,又能实时修改视觉效果并保持角色一致性的AI工具,必须部署、调度并拼接多个大型模型(分别用于VLM语义处理、Diffusion图像生成和时序视频处理)。 这不仅导致系统延迟,更让开发人员在管道对齐方面头疼不已。
如今,Lance3B 仅凭单一模型便实现了“左眼观察、右眼编辑、双手创作”的效果
相关文章
 像Ditto这样的Z世代约会应用抛弃了滑动匹配,转而采用AI配对
这一代年轻成年人对依赖滑动手势的约会平台感到极度厌倦,以至于他们愿意尝试几乎任何替代方案,包括由人工智能驱动的配对服务。从加州大学伯克利分校毕业后,Ditto 联合创始人 Allen Wang 和 Eric Liu 着手开展一项使命,旨在为他们同龄人提供一种解决方案,使他们能够在不必每周花费数小时应对 Tinder 和 Hinge 等应用混乱机制的情况下建立联系。“作为 Z 世代的一员,我们直接观察到人们互动方式的转变,”Wang 向 TechCrunch 解释道。“我们注意到,用户厌倦了无休止
Infosys执行副总裁在人工智能应用及与OpenAI的合作方面取得突破
巴拉克里什纳(巴利)·D.R.,印孚瑟斯执行副总裁兼人工智能及行业垂直领域全球服务负责人Infosys执行副总裁巴拉克里什纳(巴利)·D·R. 谈成功应用AI的企业与在规模化应用方面举步维艰的企业有何不同,以及该公司与OpenAI的合作企业人工智能的采用已超越实验阶段,但许多组织仍陷于前景可观的试点项目与实现可衡量商业价值这一挑战之间。数据分散、遗留系统、不断演变的治理机制以及职责归属不清,这些因
港股高开,AI概念股MiniMax等暴跌近9%
2026年3月11日,香港人工智能行业遭遇突然低迷。与热门开源智能体OpenClaw(昵称“龙虾”)相关的股票在经历大幅上涨后急剧下跌。MiniMax近期创下市值新高,此次领跌,跌幅高达8.77%。核心原因:关键行业面临“泄露”风险市场恐慌源于对OpenClaw安全性的监管担忧。国家互联网应急中心就其安全部署发布了专项警告。有关部门指出,对于金融和能源等关键行业,该智能体存在泄露核心业务数据、商业机密和代码库的风险。在最坏情况下,可能引发系统全面瘫痪,给企业造成严重经济损失。专家警告:更
相关专题推荐
会议助理
 最佳 AI 议程制定工具:几分钟内更高效地规划每周例会
“2026年最新最佳AI议程生成器”页面精选了一系列广受好评的工具,让规划每周团队同步会议变得轻而易举。这些强大的解决方案可帮助您在短短几分钟内创建条理清晰、高效的议程,从而节省宝贵时间并提升工作效率。XIX.AI 确保所有入选工具均经过严格的实际应用测试。 获取免费版与付费版的对比指南,探索那些能带来颠覆性成果的必试选项。立即探索,找到能让您的工作流程更加顺畅的完美工具!
 15 个工具
 xix.ai
商业
最佳初创企业AI商业计划工具
2026 年最新最佳顶级评分 AI 商业计划工具,专为初创企业打造!XIX.AI 精心策划了一套强大且具颠覆性的必试工具合集,这些工具均经过现实世界测试,并每周更新排名。这些顶级解决方案帮助初创企业起草无懈可击的商业计划,提升生产力,并充分发挥其 AI 优势。立即探索,发现最适合您的工具!
9 个工具
xix.ai
营销
最适合受众研究的AI用户画像构建工具
2026年最新、最受欢迎、评价最高的受众研究AI用户画像构建工具现已登陆XIX.AI!这份精心筛选的清单汇集了功能强大、具有颠覆性的工具,通过详细的免费版与付费版对比,助您开展实际测试并创建精准的受众画像。 您将发现这些必试的工具,它们不仅能提升写作效率,还能在营销策略中助您发挥AI的独特优势。立即探索,找到最适合您的工具!
9 个工具
xix.ai
视频创作
适用于 SaaS 产品营销的 AI 演示视频工具
2026年最新、最受欢迎的SaaS产品营销AI演示视频工具,由XIX.AI精心精选。这些功能强大、具有革命性的解决方案可帮助营销人员快速创建高质量的视频内容,提高写作效率,并优化营销工作流程。 这里为您提供免费版与付费版的对比分析、实际测试结果以及每周更新的排行榜。立即探索,找到最适合提升SaaS销售额的理想工具!
9 个工具
xix.ai
提示词
用于提升输出质量的 AI 提示词测试工具
2026 年最新最佳顶级 AI 提示词测试工具,提升输出质量!XIX.AI 精心策划了一套强大且颠覆性的工具合集,这些工具均经过严格的真实世界测试,以确保始终如一的高品质结果。您将找到详细的免费与付费对比分析、全面排名以及专家指导,帮助您识别那些能显著提升工作效率的必试方案。立即探索,释放您的 AI 优势!
11 个工具
xix.ai
商业
用于产品定位的 AI 客户洞察工具
2026年最前沿、最优秀、评分最高的用于产品定位的AI客户洞察工具!XIX.AI精心挑选了一系列功能强大且具有颠覆性意义的工具,这些工具均经过实际应用测试,并会每周更新排名。它们能够帮助您快速掌握客户需求,从而提升写作效率,创作出最优的SEO内容,还能高效地撰写完美的社交媒体文案,避免浪费时间。立即探索,找到最适合您的工具,发挥您的AI优势。
10 个工具
xix.ai

 评论 (0)
0/500
字节跳动研究院已正式将旗下原生统一多模态大模型“Lance”开源。
尽管人工智能行业通常依赖于拥有数千亿甚至数万亿参数的模型,或是由独立组件组合而成的模型,但Lance却代表了一项重大突破。 它在仅拥有3B(30亿)个激活参数这一极其轻量级的规模下,仍能提供完整的功能,有效弥合了“理解模型(VLM)”与“生成模型(DiT/Diffusion)”之间的技术鸿沟。
主要亮点:
原生统一:该模型并非拼凑而成,而是从零开始构建,将图像和视频的理解、生成以及跨模态编辑整合到单一系统中。
全面性能:单一模型可无缝处理 $X rightarrow T$(文本/视频理解)、$X rightarrow I$(图像生成/编辑)和 $X rightarrow V$(视频生成/编辑)这三项核心输出任务。
开源且免费:采用许可范围极广的Apache 2.0许可证发布。权重模型已在Hugging Face上完全开放,整个流程仅需128块A100 GPU即可运行,成本适中。
技术解析:它如何在相互矛盾的需求之间实现“同步”?
在传统的人工智能架构中,“理解”与“生成”能力往往存在矛盾:理解任务需要过滤噪声以提取高级语义特征,而生成任务则侧重于低级纹理、几何结构和时间动态。
为解决这一行业性挑战,Lance 采用了巧妙的“共享上下文 + 并行能力解耦”设计:
1. 统一交织序列与双流专家架构
所有文本、图像和视频输入首先被分词并转换为统一的“交错序列”。随后,该序列由双流 MoE(多专家)架构进行处理,使专门负责“理解”和“生成”的专家模块能够独立运行,从而有效解决了能力冲突。
理解侧:文本令牌和视觉输入利用 Qwen2.5-VL 的嵌入层和 ViT 编码器,准确提取高级语义视觉令牌。
生成侧:视觉输入通过 Wan2.2 强大的 3D 因果 VAE 进行压缩,实现 $16 倍$ 的空间下采样和 $4 倍$ 的时间下采样,从而保留了详细的动态连续表示。
2. MaPE(模态感知旋转位置编码)
长序列中混合的视觉令牌(图像、文本和视频)可能导致“边界混淆”幻觉。Lance 引入了 MaPE 机制,该机制为不同的模态组添加了固定的时间偏移量。这种优雅的设计能够在不破坏图像和视频内部结构及时间顺序的前提下,实现强大的空间和时间边界识别。
[Unified Interleaved Sequence] ──► [MaPE Modal Boundary Isolation] ──► [Dual-Stream Expert Architecture (MoE)]
四阶段极限训练:128张GPU的“精简之战”
与大型企业动用数千块GPU的“蛮力美学”形成鲜明对比,Lance的训练过程展现了极高的资金利用效率。整个生命周期严格限制在最多128块GPU的预算内,并经历四个紧密衔接的阶段:
第一阶段:预训练(1.5T 令牌)——处理 10 亿张图像-文本对和 1.4 亿个视频-文本对,为多模态理解奠定坚实基础。
第二阶段:连续训练(3000亿令牌)——整合编辑、主题驱动生成及多模态理解数据,以激发多任务协同效应。
第三阶段:监督式微调(720亿令牌)——大规模注入人类指令,重点关注指令遵循与视觉身份一致性。
第四阶段:强化学习(GRPO算法)——利用基于群组的相对策略优化,并特别采用PaddleOCR作为奖励模型,专门解决文本渲染不准确以及文本与图像对齐错误等AI问题。
卓越成果:3B模型在多个领域击败7B巨头
得益于跨任务数据协同(模型在学习生成时深化理解,在学习理解时提升生成能力),3B规模的Lance在各项基准测试中均表现卓越:
视频生成(VBench):得分85.11分! 它超越了TUNA(84.06)等同类全能型模型,并优于HunyuanVideo(83.33)和Wan2.1-T2V(83.69)等专业视频生成模型。
图像生成(GenEval):得分0.90,稳居全球开源模型前列。
视频理解(MVBench):得分62.0分,显著超过了专用理解模型Show-o2(7B,55.7分),而该模型的规模是Lance的两倍。
行业震动:多模态应用的部署成本将大幅下降
Lance的开源发布将对行业产生重大颠覆,特别是对于AI短片、智能代理(Agent)协作和交互式媒体等蓬勃发展的领域。
此前,要开发一款既能理解剧本、生成分镜,又能实时修改视觉效果并保持角色一致性的AI工具,必须部署、调度并拼接多个大型模型(分别用于VLM语义处理、Diffusion图像生成和时序视频处理)。 这不仅导致系统延迟,更让开发人员在管道对齐方面头疼不已。
如今,Lance3B 仅凭单一模型便实现了“左眼观察、右眼编辑、双手创作”的效果








 像Ditto这样的Z世代约会应用抛弃了滑动匹配,转而采用AI配对
这一代年轻成年人对依赖滑动手势的约会平台感到极度厌倦,以至于他们愿意尝试几乎任何替代方案,包括由人工智能驱动的配对服务。从加州大学伯克利分校毕业后,Ditto 联合创始人 Allen Wang 和 Eric Liu 着手开展一项使命,旨在为他们同龄人提供一种解决方案,使他们能够在不必每周花费数小时应对 Tinder 和 Hinge 等应用混乱机制的情况下建立联系。“作为 Z 世代的一员,我们直接观察到人们互动方式的转变,”Wang 向 TechCrunch 解释道。“我们注意到,用户厌倦了无休止
 Infosys执行副总裁在人工智能应用及与OpenAI的合作方面取得突破
巴拉克里什纳(巴利)·D.R.,印孚瑟斯执行副总裁兼人工智能及行业垂直领域全球服务负责人Infosys执行副总裁巴拉克里什纳(巴利)·D·R. 谈成功应用AI的企业与在规模化应用方面举步维艰的企业有何不同,以及该公司与OpenAI的合作企业人工智能的采用已超越实验阶段,但许多组织仍陷于前景可观的试点项目与实现可衡量商业价值这一挑战之间。数据分散、遗留系统、不断演变的治理机制以及职责归属不清,这些因
 港股高开,AI概念股MiniMax等暴跌近9%
2026年3月11日,香港人工智能行业遭遇突然低迷。与热门开源智能体OpenClaw(昵称“龙虾”)相关的股票在经历大幅上涨后急剧下跌。MiniMax近期创下市值新高,此次领跌,跌幅高达8.77%。核心原因:关键行业面临“泄露”风险市场恐慌源于对OpenClaw安全性的监管担忧。国家互联网应急中心就其安全部署发布了专项警告。有关部门指出,对于金融和能源等关键行业,该智能体存在泄露核心业务数据、商业机密和代码库的风险。在最坏情况下,可能引发系统全面瘫痪,给企业造成严重经济损失。专家警告:更
“2026年最新最佳AI议程生成器”页面精选了一系列广受好评的工具,让规划每周团队同步会议变得轻而易举。这些强大的解决方案可帮助您在短短几分钟内创建条理清晰、高效的议程,从而节省宝贵时间并提升工作效率。XIX.AI 确保所有入选工具均经过严格的实际应用测试。 获取免费版与付费版的对比指南,探索那些能带来颠覆性成果的必试选项。立即探索,找到能让您的工作流程更加顺畅的完美工具!
15 个工具
xix.ai
2026 年最新最佳顶级评分 AI 商业计划工具,专为初创企业打造!XIX.AI 精心策划了一套强大且具颠覆性的必试工具合集,这些工具均经过现实世界测试,并每周更新排名。这些顶级解决方案帮助初创企业起草无懈可击的商业计划,提升生产力,并充分发挥其 AI 优势。立即探索,发现最适合您的工具!
9 个工具
xix.ai
2026年最新、最受欢迎、评价最高的受众研究AI用户画像构建工具现已登陆XIX.AI!这份精心筛选的清单汇集了功能强大、具有颠覆性的工具,通过详细的免费版与付费版对比,助您开展实际测试并创建精准的受众画像。 您将发现这些必试的工具,它们不仅能提升写作效率,还能在营销策略中助您发挥AI的独特优势。立即探索,找到最适合您的工具!
9 个工具
xix.ai
2026年最新、最受欢迎的SaaS产品营销AI演示视频工具,由XIX.AI精心精选。这些功能强大、具有革命性的解决方案可帮助营销人员快速创建高质量的视频内容,提高写作效率,并优化营销工作流程。 这里为您提供免费版与付费版的对比分析、实际测试结果以及每周更新的排行榜。立即探索,找到最适合提升SaaS销售额的理想工具!
9 个工具
xix.ai
2026 年最新最佳顶级 AI 提示词测试工具,提升输出质量!XIX.AI 精心策划了一套强大且颠覆性的工具合集,这些工具均经过严格的真实世界测试,以确保始终如一的高品质结果。您将找到详细的免费与付费对比分析、全面排名以及专家指导,帮助您识别那些能显著提升工作效率的必试方案。立即探索,释放您的 AI 优势!
11 个工具
xix.ai
2026年最前沿、最优秀、评分最高的用于产品定位的AI客户洞察工具!XIX.AI精心挑选了一系列功能强大且具有颠覆性意义的工具,这些工具均经过实际应用测试,并会每周更新排名。它们能够帮助您快速掌握客户需求,从而提升写作效率,创作出最优的SEO内容,还能高效地撰写完美的社交媒体文案,避免浪费时间。立即探索,找到最适合您的工具,发挥您的AI优势。
10 个工具
xix.ai












