


 首页
AI学者在Alphago的国际象棋胜利背后获得了Turing奖的技术
在过去十年中,人工智能以其进步令人眼花缭乱,特别是在一种技术中,计算机通过随机选择并从结果中学习。这种方法,被称为强化学习,在实现人工智能的卓越成就中发挥了关键作用。
以谷歌DeepMind的AlphaZero程序为例,该程序在2016年启动,到2018年已掌握了国际象棋、将棋和围棋等复杂游戏。同样,AlphaStar使用这种方法在视频游戏《星际争霸II》中达到了“大师”级别。这些成就凸显了强化学习的强大力量。
周三,该领域庆祝了一个重要的里程碑,两位人工智能学者因其在推进强化学习方面的开创性工作而受到表彰。马萨诸塞大学阿默斯特分校名誉教授安德鲁·G·巴托和加拿大阿尔伯塔大学教授理查德·S·萨顿获得了计算机协会(ACM)颁发的2025年图灵奖。
强化学习先驱的认可
ACM赞扬巴托和萨顿为强化学习奠定了基础,称他们“提出了主要思想,构建了数学基础,并开发了重要算法”。这一殊荣伴随着100万美元的奖金,常被视为计算机行业的诺贝尔奖等价物。
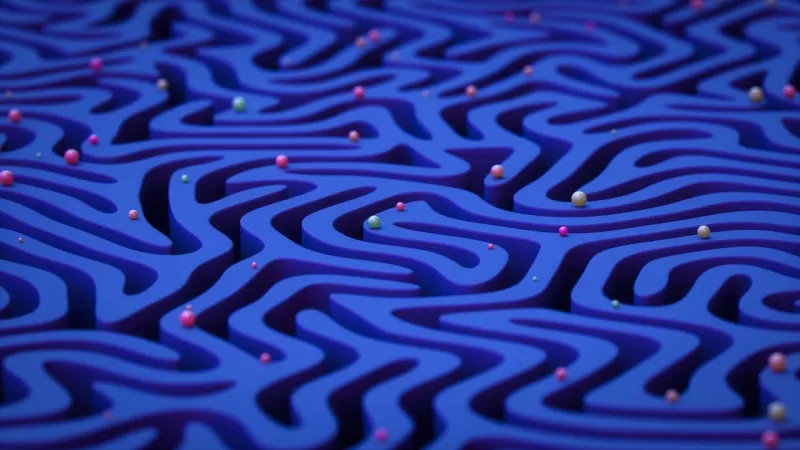
强化学习可以比作老鼠在迷宫中寻找奶酪。老鼠学会哪些路径通向进步,哪些是死胡同。同样,神经科学家认为,智能生物,如老鼠,会发展出一种“内部世界模型”来指导其行动。
萨顿和巴托提出,计算机也可以发展这样的内部模型。在强化学习中,计算机收集关于其环境的数据——无论是迷宫还是棋盘——并最初随机行动。它以奖励或惩罚的形式接收反馈,这有助于它估计不同行动的结果。基于这些估计,程序会制定一个“策略”来指导未来的决策,平衡探索新行动与利用已知成功行动的关系。
探索与利用的角色
强化学习的核心在于探索新可能性与利用已知策略之间的微妙平衡。单一方法不足以成功。
对于希望深入研究的读者,萨顿和巴托2018年的教科书是宝贵的资源。
值得注意的是,“强化学习”一词有时被OpenAI等公司以不同方式使用,他们采用“基于人类反馈的强化学习”(RLHF)来优化大型语言模型如GPT的输出。然而,这与萨顿和巴托开发的方法有所不同。
强化学习作为一种思维理论
萨顿在2017年至2023年间担任DeepMind杰出研究科学家,他认为强化学习不仅仅是一种技术,而是一种“思维理论”。他表达了对人工智能缺乏计算理论的担忧,坚称“强化学习是智能的第一个计算理论”。
除了技术应用,强化学习还可能揭示创造力和自由玩耍作为智能表达的作用。萨顿和巴托强调了玩耍在学习中的作用,指出好奇心驱动探索。萨顿强调,玩耍可能涉及设定一些暂时无用的目标,但这些目标可能在未来证明有益。
“玩耍是一件大事,”萨顿评论道,指出其在学习和智能更广泛背景中的重要角色。
强化学习的旅程,从巴托和萨顿的奠基工作到其在游戏及更广泛领域的应用,继续推动人工智能所能实现的边界。
相关文章
 Meta 在用户强烈反对后取消了 AI 照片编辑功能
Meta,这家社交媒体巨头,再次卷入关于人工智能与用户隐私之间微妙平衡的公开辩论。据 TechCrunch 报道,Meta 的 Superintelligence Labs 本周早些时候推出了一款新的 AI 图像生成器 Muse Image。然而,一个备受好评的关键功能——允许用户通过“@”符号标记来修改和生成来自公开 Instagram 账户的图像——由于缺乏适当的通知机制,立即引发了用户以及 CAA 等机构的强烈反对。面对强烈的批评,Meta 迅速撤销了该决定,并于周五通过博客文章宣布将
DeepMind首席执行官哈西里斯:我每天睡六个小时,通常在凌晨1点左右感到精力充沛。
Fortune 最近刊登了对谷歌 DeepMind 首席执行官 Demis Hassabis 的采访,揭示了他对休息和生产力的非传统方法。Hassabis 透露,他睡眠时间非常少,将清醒时间划分为两个不同的工作阶段。关于他的睡眠习惯,Hassabis 表示:“我目标睡六小时,但我的习惯非同寻常。我可以在白天有效运作。”他强调,睡眠少于六小时会对大脑健康产生负面影响。Hassabis 于 2010 年联合创立了 DeepMind(后被谷歌收购),并因其在蛋白质结构预测方面的开创性工作荣获 20
尽管营收未达预期,OpenAI与Anthropic仍在争夺市场份额
尽管近期有报道称OpenAI未达营收目标,给本周二的科技股带来压力,但私营人工智能实验室的投资者仍表现坚韧。经验丰富的投资者已确认,尽管媒体报道负面,他们仍不会减少投资。分析师认为当前的人工智能竞赛仍处于早期阶段,因此不会出现“赢家通吃”的局面。尽管高昂的计算成本给营收带来压力,但实验室可通过提高订阅费来提升盈利能力。行业格局正发生微妙变化与OpenAI不同,其竞争对手Anthropic获得了强有
相关专题推荐
视频创作
 适用于 Reels、Shorts 及产品发布活动的 AI 短视频吸睛点生成器
2026年最新最全的AI短视频开场白生成器,适用于Reels、Shorts及产品发布活动!XIX.AI精选了经过实际测试、效果惊人且必试的顶级工具,这些工具将彻底改变游戏规则。本页面每周更新,提供免费与付费版本的对比排名,助您找到提升内容创意和生产力的完美解决方案。 立即探索,释放您的AI优势!
 11 个工具
 xix.ai
写作
适用于长篇写作的AI文章大纲工具
2026年最新最佳、评分最高的人工智能文章大纲工具,专为长文写作打造!这份精心挑选的合集收录了功能强大、具有革命性意义的工具,它们能生成准确、结构清晰的大纲,并经过实际测试验证,可显著提升写作效率。XIX.AI 便是这份精英精选中的成员之一。 获取免费版与付费版的对比指南,助您选择最适合的工具。立即探索,释放您的AI优势!
9 个工具
xix.ai
聊天机器人
用于语言练习、面试准备和日常流利度的最佳 AI 角色扮演聊天应用
2026 年最新最佳顶级评分 AI 角色扮演聊天应用,用于语言练习、面试准备和日常流利度!XIX.AI 精心策划了一个强大的变革性合集,提供免费与付费对比、真实世界测试以及每周更新的排名。这些必试工具可帮助您提升写作技能,克服流利度挑战,并提高所有日常场景下的沟通效率。立即探索,发现您语言成长的完美工具!
10 个工具
xix.ai
音乐创作
用于混音制作、采样准备及卡拉OK母带处理的 AI 声部分离工具
2026年最新、最优秀且评分最高的AI音轨分离工具汇总,专为混音制作、采样准备以及卡拉OK音频处理而设计。这些功能强大的创新工具经过实际测试,能够实现精准的音频分离,显著提升工作效率。XIX.AI每周都会更新免费的付费产品对比指南,帮助您找到最适合自身需求的工具。立即探索,发挥您的AI优势。
8 个工具
xix.ai
数据分析
用于收入看板、转化漏斗分析及产品指标分析的 AI SQL 助手
2026年最新最优秀的AI SQL辅助工具排名揭晓!XIX.AI精心挑选了一系列功能强大的工具,这些工具会定期更新,并通过真实的场景测试来验证其性能。使用这些值得尝试的工具,您可以快速生成精准的收入分析报表、分析销售流程,并追踪产品各项指标,从而大幅提升工作效率。立即探索,找到最适合您的数据驱动决策工具!238个字符
9 个工具
xix.ai
音乐创作
最佳用于歌曲草稿的 AI 旋律创作工具
2026 年最新最佳顶级评分 AI 旋律创作工具,助力歌曲草稿创作!XIX.AI 精心策划了一套极具影响力且经过严格真实世界测试的变革性合集,旨在提供最佳的创作体验。您可以找到详细的免费与付费版对比、精准的排名以及必试选项,这些工具旨在帮助您轻松创作出令人惊艳的歌曲草稿,并显著提升您的创意生产力。立即探索,发现您的完美工具!
8 个工具
xix.ai

 评论 (12)
0/500
![NicholasAdams]()
This reinforcement learning stuff is wild! AlphaGo beating chess champs? Mind blown 🤯. Makes me wonder how far AI can push human limits—scary but exciting!
![GeorgeTaylor]()
Mind-blowing how reinforcement learning led to AlphaGo's chess win! 🤯 Makes me wonder what other games AI will conquer next.
![ArthurBrown]()
The AI Scholars Awarded Turing Prize really blew my mind! The way they used reinforcement learning to make AlphaGo win at chess is just genius. It's like watching a sci-fi movie come to life. I wish I understood the tech better, but it's still super cool! 🤓
![EdwardTaylor]()
AlphaGoのチェス勝利の背後にある技術でAI Scholarsがチューリング賞を受賞したのは驚きです!強化学習がAIをこれほどの高みに押し上げたのを見るのは魅力的です。ただ、時々技術的な内容が難しすぎることがありますが、それでも人間の創意工夫の証です。境界を押し広げ続けてください!🧠
![WalterSanchez]()
The AI Scholars winning the Turing Prize for the technique behind AlphaGo's chess victory is mind-blowing! It's fascinating to see how reinforcement learning has propelled AI to such heights. The only thing is, it's a bit too technical for me at times, but still, it's a testament to human ingenuity. Keep pushing the boundaries! 🧠
![WillieJackson]()
¡Los académicos de IA que recibieron el Premio Turing por la técnica detrás de la victoria de AlphaGo en el ajedrez me dejaron asombrado! Usar el aprendizaje por refuerzo para ganar es genial. Me gustaría entender mejor la tecnología, pero aún así es muy cool! 🤓
在过去十年中,人工智能以其进步令人眼花缭乱,特别是在一种技术中,计算机通过随机选择并从结果中学习。这种方法,被称为强化学习,在实现人工智能的卓越成就中发挥了关键作用。
以谷歌DeepMind的AlphaZero程序为例,该程序在2016年启动,到2018年已掌握了国际象棋、将棋和围棋等复杂游戏。同样,AlphaStar使用这种方法在视频游戏《星际争霸II》中达到了“大师”级别。这些成就凸显了强化学习的强大力量。
周三,该领域庆祝了一个重要的里程碑,两位人工智能学者因其在推进强化学习方面的开创性工作而受到表彰。马萨诸塞大学阿默斯特分校名誉教授安德鲁·G·巴托和加拿大阿尔伯塔大学教授理查德·S·萨顿获得了计算机协会(ACM)颁发的2025年图灵奖。
强化学习先驱的认可
ACM赞扬巴托和萨顿为强化学习奠定了基础,称他们“提出了主要思想,构建了数学基础,并开发了重要算法”。这一殊荣伴随着100万美元的奖金,常被视为计算机行业的诺贝尔奖等价物。
强化学习可以比作老鼠在迷宫中寻找奶酪。老鼠学会哪些路径通向进步,哪些是死胡同。同样,神经科学家认为,智能生物,如老鼠,会发展出一种“内部世界模型”来指导其行动。
萨顿和巴托提出,计算机也可以发展这样的内部模型。在强化学习中,计算机收集关于其环境的数据——无论是迷宫还是棋盘——并最初随机行动。它以奖励或惩罚的形式接收反馈,这有助于它估计不同行动的结果。基于这些估计,程序会制定一个“策略”来指导未来的决策,平衡探索新行动与利用已知成功行动的关系。
探索与利用的角色
强化学习的核心在于探索新可能性与利用已知策略之间的微妙平衡。单一方法不足以成功。
对于希望深入研究的读者,萨顿和巴托2018年的教科书是宝贵的资源。
值得注意的是,“强化学习”一词有时被OpenAI等公司以不同方式使用,他们采用“基于人类反馈的强化学习”(RLHF)来优化大型语言模型如GPT的输出。然而,这与萨顿和巴托开发的方法有所不同。
强化学习作为一种思维理论
萨顿在2017年至2023年间担任DeepMind杰出研究科学家,他认为强化学习不仅仅是一种技术,而是一种“思维理论”。他表达了对人工智能缺乏计算理论的担忧,坚称“强化学习是智能的第一个计算理论”。
除了技术应用,强化学习还可能揭示创造力和自由玩耍作为智能表达的作用。萨顿和巴托强调了玩耍在学习中的作用,指出好奇心驱动探索。萨顿强调,玩耍可能涉及设定一些暂时无用的目标,但这些目标可能在未来证明有益。
“玩耍是一件大事,”萨顿评论道,指出其在学习和智能更广泛背景中的重要角色。
强化学习的旅程,从巴托和萨顿的奠基工作到其在游戏及更广泛领域的应用,继续推动人工智能所能实现的边界。








 Meta 在用户强烈反对后取消了 AI 照片编辑功能
Meta,这家社交媒体巨头,再次卷入关于人工智能与用户隐私之间微妙平衡的公开辩论。据 TechCrunch 报道,Meta 的 Superintelligence Labs 本周早些时候推出了一款新的 AI 图像生成器 Muse Image。然而,一个备受好评的关键功能——允许用户通过“@”符号标记来修改和生成来自公开 Instagram 账户的图像——由于缺乏适当的通知机制,立即引发了用户以及 CAA 等机构的强烈反对。面对强烈的批评,Meta 迅速撤销了该决定,并于周五通过博客文章宣布将
 DeepMind首席执行官哈西里斯:我每天睡六个小时,通常在凌晨1点左右感到精力充沛。
Fortune 最近刊登了对谷歌 DeepMind 首席执行官 Demis Hassabis 的采访,揭示了他对休息和生产力的非传统方法。Hassabis 透露,他睡眠时间非常少,将清醒时间划分为两个不同的工作阶段。关于他的睡眠习惯,Hassabis 表示:“我目标睡六小时,但我的习惯非同寻常。我可以在白天有效运作。”他强调,睡眠少于六小时会对大脑健康产生负面影响。Hassabis 于 2010 年联合创立了 DeepMind(后被谷歌收购),并因其在蛋白质结构预测方面的开创性工作荣获 20
 尽管营收未达预期,OpenAI与Anthropic仍在争夺市场份额
尽管近期有报道称OpenAI未达营收目标,给本周二的科技股带来压力,但私营人工智能实验室的投资者仍表现坚韧。经验丰富的投资者已确认,尽管媒体报道负面,他们仍不会减少投资。分析师认为当前的人工智能竞赛仍处于早期阶段,因此不会出现“赢家通吃”的局面。尽管高昂的计算成本给营收带来压力,但实验室可通过提高订阅费来提升盈利能力。行业格局正发生微妙变化与OpenAI不同,其竞争对手Anthropic获得了强有
2026年最新最全的AI短视频开场白生成器,适用于Reels、Shorts及产品发布活动!XIX.AI精选了经过实际测试、效果惊人且必试的顶级工具,这些工具将彻底改变游戏规则。本页面每周更新,提供免费与付费版本的对比排名,助您找到提升内容创意和生产力的完美解决方案。 立即探索,释放您的AI优势!
11 个工具
xix.ai
2026年最新最佳、评分最高的人工智能文章大纲工具,专为长文写作打造!这份精心挑选的合集收录了功能强大、具有革命性意义的工具,它们能生成准确、结构清晰的大纲,并经过实际测试验证,可显著提升写作效率。XIX.AI 便是这份精英精选中的成员之一。 获取免费版与付费版的对比指南,助您选择最适合的工具。立即探索,释放您的AI优势!
9 个工具
xix.ai
2026 年最新最佳顶级评分 AI 角色扮演聊天应用,用于语言练习、面试准备和日常流利度!XIX.AI 精心策划了一个强大的变革性合集,提供免费与付费对比、真实世界测试以及每周更新的排名。这些必试工具可帮助您提升写作技能,克服流利度挑战,并提高所有日常场景下的沟通效率。立即探索,发现您语言成长的完美工具!
10 个工具
xix.ai
2026年最新、最优秀且评分最高的AI音轨分离工具汇总,专为混音制作、采样准备以及卡拉OK音频处理而设计。这些功能强大的创新工具经过实际测试,能够实现精准的音频分离,显著提升工作效率。XIX.AI每周都会更新免费的付费产品对比指南,帮助您找到最适合自身需求的工具。立即探索,发挥您的AI优势。
8 个工具
xix.ai

2026年最新最优秀的AI SQL辅助工具排名揭晓!XIX.AI精心挑选了一系列功能强大的工具,这些工具会定期更新,并通过真实的场景测试来验证其性能。使用这些值得尝试的工具,您可以快速生成精准的收入分析报表、分析销售流程,并追踪产品各项指标,从而大幅提升工作效率。立即探索,找到最适合您的数据驱动决策工具!238个字符
9 个工具
xix.ai

2026 年最新最佳顶级评分 AI 旋律创作工具,助力歌曲草稿创作!XIX.AI 精心策划了一套极具影响力且经过严格真实世界测试的变革性合集,旨在提供最佳的创作体验。您可以找到详细的免费与付费版对比、精准的排名以及必试选项,这些工具旨在帮助您轻松创作出令人惊艳的歌曲草稿,并显著提升您的创意生产力。立即探索,发现您的完美工具!
8 个工具
xix.ai

This reinforcement learning stuff is wild! AlphaGo beating chess champs? Mind blown 🤯. Makes me wonder how far AI can push human limits—scary but exciting!
Mind-blowing how reinforcement learning led to AlphaGo's chess win! 🤯 Makes me wonder what other games AI will conquer next.
The AI Scholars Awarded Turing Prize really blew my mind! The way they used reinforcement learning to make AlphaGo win at chess is just genius. It's like watching a sci-fi movie come to life. I wish I understood the tech better, but it's still super cool! 🤓
AlphaGoのチェス勝利の背後にある技術でAI Scholarsがチューリング賞を受賞したのは驚きです!強化学習がAIをこれほどの高みに押し上げたのを見るのは魅力的です。ただ、時々技術的な内容が難しすぎることがありますが、それでも人間の創意工夫の証です。境界を押し広げ続けてください!🧠
The AI Scholars winning the Turing Prize for the technique behind AlphaGo's chess victory is mind-blowing! It's fascinating to see how reinforcement learning has propelled AI to such heights. The only thing is, it's a bit too technical for me at times, but still, it's a testament to human ingenuity. Keep pushing the boundaries! 🧠
¡Los académicos de IA que recibieron el Premio Turing por la técnica detrás de la victoria de AlphaGo en el ajedrez me dejaron asombrado! Usar el aprendizaje por refuerzo para ganar es genial. Me gustaría entender mejor la tecnología, pero aún así es muy cool! 🤓












