


 Lar
A metacognição pode ser a chave para acabar com as alucinações em modelos de grande porte
As alucinações de modelos de grande porte — em que a IA apresenta erros factuais com absoluta confiança — há muito tempo constituem um desafio central no setor de IA. Essa questão se torna especialmente crítica em áreas de alto risco, como a saúde e o direito.
Durante anos, o setor adotou principalmente duas estratégias para combater as alucinações: uma é expandir maciçamente os dados de treinamento, na tentativa de tornar a IA “onisciente”; a outra é criar mecanismos defensivos, incentivando a IA a “ficar em silêncio” quando houver incerteza. Mas ambas as abordagens apresentam limitações claras. A primeira não consegue abranger todos os fatos existentes, deixando lacunas. A segunda frequentemente resulta em um alto “custo de utilidade”: no esforço para eliminar erros, a IA acaba se recusando a responder a muitas perguntas corretas, prejudicando significativamente a experiência do usuário.
Recentemente, um artigo de autoria conjunta do Google Research e da Universidade de Tel Aviv oferece uma nova perspectiva sobre esse dilema: a metacognição. O estudo sugere que a chave para resolver as alucinações não é forçar a IA a nunca cometer erros, mas capacitá-la a “saber o que sabe — e o que não sabe”.
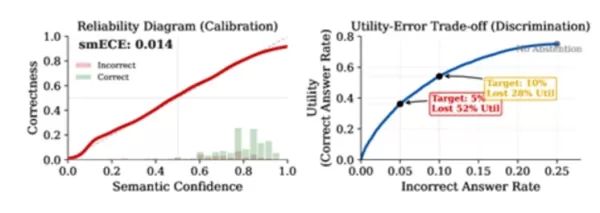
Figura: A diferença entre calibração e poder discriminativo. A parte esquerda mostra um modelo bem calibrado (linha vermelha próxima à diagonal), enquanto a direita revela a dura realidade — mesmo com calibração perfeita, reduzir a taxa de erro de 25% para 5% exige sacrificar 52% das respostas corretas.
O artigo redefine as alucinações: a questão central não é se as respostas da IA estão erradas, mas se elas induzem os usuários ao erro com um tom de confiança quando o sistema está incerto. Os pesquisadores argumentam que a IA deve possuir a capacidade de “incerteza fiel”. Ou seja, quando o estado interno do modelo sinaliza hesitação ou baixa confiança, sua linguagem deve refletir cautela e reserva — em vez de fingir afirmar fatos absolutos.
Metacognição refere-se à consciência da IA sobre seus próprios processos cognitivos. Isso exige que modelos de grande porte percebam com sensibilidade seus estados internos e, com base nessa percepção, expressem honestamente seus níveis de confiança. Na era dos agentes de IA, essa capacidade é especialmente vital. Um sistema de IA sem metacognição é como um piloto sem painel de instrumentos — ele não consegue determinar quando recorrer a ferramentas externas, nem verificar a confiabilidade dos resultados de pesquisa, tornando-se propenso ao uso indevido de ferramentas e até mesmo a um “voo às cegas”.
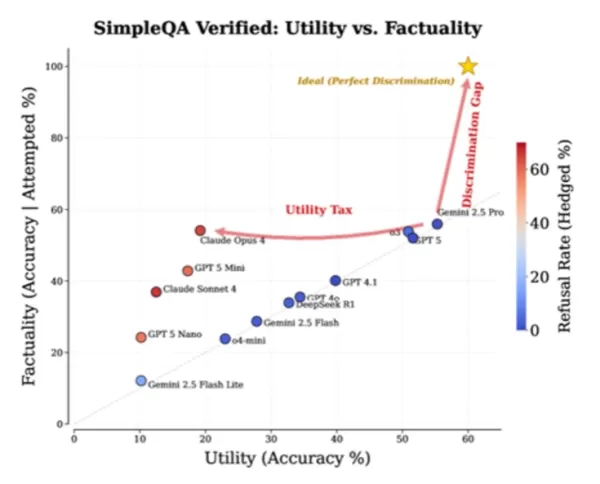
Figura: Desempenho real dos principais modelos no SimpleQA Verified. A estrela de cinco pontas no canto superior direito marca a meta ideal; “Discrimination Gap” indica a distância entre os modelos atuais e esse ideal, enquanto “Utility Tax” mostra o custo que o Claude Opus4 paga para alcançar alta precisão.
É claro que a implementação dessa abordagem traz desafios significativos. Por exemplo, como distinguir a “verdadeira metacognição” da “demonstração deliberada de incerteza” e como evitar os efeitos negativos do RLHF (Aprendizado por Reforço a partir do Feedback Humano) — já que os seres humanos tendem a preferir respostas confiantes, o que, de certa forma, na verdade incentiva a IA a aprender a fingir confiança.
Para o futuro do desenvolvimento da IA, o estudo oferece recomendações práticas: as métricas de avaliação para tecnologias anti-alucinação não devem mais se concentrar exclusivamente na precisão, mas, em vez disso, avaliar o equilíbrio entre “utilidade e taxa de erro”. A IA não precisa se tornar uma máquina infalível, mas deve possuir uma qualidade profissional básica: a capacidade de distinguir honestamente entre “tenho certeza” e “estou supondo”. Essa consciência clara dos limites de seu próprio conhecimento é o caminho essencial para melhorar a credibilidade e o valor da IA no mundo real.
Artigo relacionado
 MiniMax 2.5 lidera o uso global com receita mensal superior a US$ 150 milhões; versão principal M3 prevista para lançamento no primeiro semestre
Os grandes modelos de linguagem chineses estão gerando um impulso intenso em todo o ecossistema global de desenvolvedores, impulsionados por sua reputação de eficiência de custos e excelência em engenharia.Até 3 de março de 2026, os dados do OpenRou
O Muse da Meta supera o ChatGPT no lançamento inicial para dispositivos móveis
Novos dados sugerem que o mais recente aplicativo de IA da Meta, o Muse, pode se tornar o próximo grande sucesso do gigante das redes sociais. De acordo com estimativas recentes da Appfigures, o Muse foi baixado em dispositivos móveis mais vezes em s
TechCrunch Disrupt 2026: Kareem Amin, da Clay, fala sobre a ascensão do engenheiro de GTM
Há dois anos, os engenheiros de GTM eram praticamente inexistentes na maioria das organizações. Hoje, essa função está ganhando espaço em todo o setor de tecnologia, com profissionais utilizando IA e
Recomendações de tópicos especiais relacionados
Design e Arte
 As melhores ferramentas de ilustração com IA: crie cenas editoriais e capas de forma mais rápida
As melhores ferramentas de ilustração com IA de 2026: nossa lista selecionada apresenta as melhores ferramentas, com design robusto, para criar rapidamente cenas editoriais impressionantes e capas atraentes. Cada opção passou por rigorosos testes práticos, oferecendo uma comparação entre versões gratuitas e pagas para ajudar você a encontrar a opção perfeita para o seu fluxo de trabalho. Experimente hoje mesmo essas soluções imperdíveis para aproveitar ao máximo as vantagens da IA e impulsionar sua produtividade criativa. Explore agora no XIX.AI.
 10 ferramentas
 xix.ai
Educação e Aprendizagem
Os melhores professores particulares especializados em IA para preparação para exames: pratique matemática, ciências e inglês
Os melhores tutores de IA para preparação para exames de 2026, com as melhores avaliações, estão aqui no XIX.AI! Nossa lista cuidadosamente selecionada apresenta ferramentas poderosas e revolucionárias que oferecem comparação entre versões gratuitas e pagas, testes práticos e rankings atualizados semanalmente. Elas ajudam a aumentar sua eficiência na redação, simplificar o aprendizado de tópicos complexos e liberar seu potencial acadêmico. Explore agora para descobrir sua ferramenta perfeita de preparação para exames e comece a criar hoje mesmo para aproveitar toda a vantagem da IA!
10 ferramentas
xix.ai
Financiar
Ferramentas de planejamento orçamentário com IA para gestão financeira pessoal
As melhores e mais bem avaliadas ferramentas de planejamento orçamentário com IA para gestão financeira pessoal de 2026 estão aqui no XIX.AI! Esta seleção especial apresenta soluções poderosas e revolucionárias que ajudam você a realizar testes na prática, entender hábitos de consumo e criar planos personalizados para aumentar a produtividade. Confira uma comparação entre versões gratuitas e pagas, além de rankings detalhados. Ferramentas imperdíveis, projetadas para simplificar a gestão financeira e explorar o potencial da IA. Explore agora!
11 ferramentas
xix.ai
Saúde e Bem-Estar
Assistentes de rastreamento do sono com IA: melhore sua recuperação adotando hábitos mais adequados antes de dormir
2026 – Os melhores assistentes de rastreamento do sono com inteligência artificial mais bem avaliados, selecionados para proporcionar uma recuperação máxima. Este guia semanal completamente atualizado apresenta ferramentas poderosas que incluem testes reais, comparações entre versões gratuitas e pagas, além de classificações detalhadas, visando ajudá-lo a encontrar a solução ideal para melhorar a qualidade do sono e fomentar hábitos noturnos mais saudáveis. Explore agora em XIX.AI e aproveite todas as vantagens oferecidas pela inteligência artificial.
10 ferramentas
xix.ai
Análise de dados
Copilotos de IA em SQL para análise de produtos e receitas
2026: Os melhores e mais bem avaliados copilotos de IA para SQL em análise de produtos e receitas! A XIX.AI selecionou um conjunto poderoso e revolucionário de ferramentas imperdíveis, que passam por testes práticos por meio de rankings atualizados semanalmente. Essas ferramentas ajudam os usuários a aumentar significativamente a produtividade, acelerando a análise de dados, simplificando consultas complexas e gerando insights precisos para impulsionar decisões de negócios mais inteligentes. Explore agora e descubra a ferramenta perfeita para aproveitar ao máximo o potencial da IA!
14 ferramentas
xix.ai
Educação e Aprendizagem
Os melhores auxiliares de tarefas escolares com IA que ensinam: aprenda conceitos, não apenas respostas
2026: Os melhores e mais bem avaliados auxiliares de tarefas com IA que ensinam conceitos fundamentais, não apenas respostas. Ferramentas poderosas para estudantes. Lista selecionada que você não pode deixar de conferir. Atualizada semanalmente. Comparação entre versões gratuitas e pagas. Testes em situações reais. Rankings precisos para ajudar você a atingir todo o seu potencial de aprendizado. Explore agora e descubra a ferramenta perfeita para estudar de forma mais inteligente.
10 ferramentas
xix.ai

 Comentários (0)
As alucinações de modelos de grande porte — em que a IA apresenta erros factuais com absoluta confiança — há muito tempo constituem um desafio central no setor de IA. Essa questão se torna especialmente crítica em áreas de alto risco, como a saúde e o direito.
Durante anos, o setor adotou principalmente duas estratégias para combater as alucinações: uma é expandir maciçamente os dados de treinamento, na tentativa de tornar a IA “onisciente”; a outra é criar mecanismos defensivos, incentivando a IA a “ficar em silêncio” quando houver incerteza. Mas ambas as abordagens apresentam limitações claras. A primeira não consegue abranger todos os fatos existentes, deixando lacunas. A segunda frequentemente resulta em um alto “custo de utilidade”: no esforço para eliminar erros, a IA acaba se recusando a responder a muitas perguntas corretas, prejudicando significativamente a experiência do usuário.
Recentemente, um artigo de autoria conjunta do Google Research e da Universidade de Tel Aviv oferece uma nova perspectiva sobre esse dilema: a metacognição. O estudo sugere que a chave para resolver as alucinações não é forçar a IA a nunca cometer erros, mas capacitá-la a “saber o que sabe — e o que não sabe”.
Figura: A diferença entre calibração e poder discriminativo. A parte esquerda mostra um modelo bem calibrado (linha vermelha próxima à diagonal), enquanto a direita revela a dura realidade — mesmo com calibração perfeita, reduzir a taxa de erro de 25% para 5% exige sacrificar 52% das respostas corretas.
O artigo redefine as alucinações: a questão central não é se as respostas da IA estão erradas, mas se elas induzem os usuários ao erro com um tom de confiança quando o sistema está incerto. Os pesquisadores argumentam que a IA deve possuir a capacidade de “incerteza fiel”. Ou seja, quando o estado interno do modelo sinaliza hesitação ou baixa confiança, sua linguagem deve refletir cautela e reserva — em vez de fingir afirmar fatos absolutos.
Metacognição refere-se à consciência da IA sobre seus próprios processos cognitivos. Isso exige que modelos de grande porte percebam com sensibilidade seus estados internos e, com base nessa percepção, expressem honestamente seus níveis de confiança. Na era dos agentes de IA, essa capacidade é especialmente vital. Um sistema de IA sem metacognição é como um piloto sem painel de instrumentos — ele não consegue determinar quando recorrer a ferramentas externas, nem verificar a confiabilidade dos resultados de pesquisa, tornando-se propenso ao uso indevido de ferramentas e até mesmo a um “voo às cegas”.
Figura: Desempenho real dos principais modelos no SimpleQA Verified. A estrela de cinco pontas no canto superior direito marca a meta ideal; “Discrimination Gap” indica a distância entre os modelos atuais e esse ideal, enquanto “Utility Tax” mostra o custo que o Claude Opus4 paga para alcançar alta precisão.
É claro que a implementação dessa abordagem traz desafios significativos. Por exemplo, como distinguir a “verdadeira metacognição” da “demonstração deliberada de incerteza” e como evitar os efeitos negativos do RLHF (Aprendizado por Reforço a partir do Feedback Humano) — já que os seres humanos tendem a preferir respostas confiantes, o que, de certa forma, na verdade incentiva a IA a aprender a fingir confiança.
Para o futuro do desenvolvimento da IA, o estudo oferece recomendações práticas: as métricas de avaliação para tecnologias anti-alucinação não devem mais se concentrar exclusivamente na precisão, mas, em vez disso, avaliar o equilíbrio entre “utilidade e taxa de erro”. A IA não precisa se tornar uma máquina infalível, mas deve possuir uma qualidade profissional básica: a capacidade de distinguir honestamente entre “tenho certeza” e “estou supondo”. Essa consciência clara dos limites de seu próprio conhecimento é o caminho essencial para melhorar a credibilidade e o valor da IA no mundo real.








 MiniMax 2.5 lidera o uso global com receita mensal superior a US$ 150 milhões; versão principal M3 prevista para lançamento no primeiro semestre
Os grandes modelos de linguagem chineses estão gerando um impulso intenso em todo o ecossistema global de desenvolvedores, impulsionados por sua reputação de eficiência de custos e excelência em engenharia.Até 3 de março de 2026, os dados do OpenRou
 O Muse da Meta supera o ChatGPT no lançamento inicial para dispositivos móveis
Novos dados sugerem que o mais recente aplicativo de IA da Meta, o Muse, pode se tornar o próximo grande sucesso do gigante das redes sociais. De acordo com estimativas recentes da Appfigures, o Muse foi baixado em dispositivos móveis mais vezes em s
 TechCrunch Disrupt 2026: Kareem Amin, da Clay, fala sobre a ascensão do engenheiro de GTM
Há dois anos, os engenheiros de GTM eram praticamente inexistentes na maioria das organizações. Hoje, essa função está ganhando espaço em todo o setor de tecnologia, com profissionais utilizando IA e

As melhores ferramentas de ilustração com IA de 2026: nossa lista selecionada apresenta as melhores ferramentas, com design robusto, para criar rapidamente cenas editoriais impressionantes e capas atraentes. Cada opção passou por rigorosos testes práticos, oferecendo uma comparação entre versões gratuitas e pagas para ajudar você a encontrar a opção perfeita para o seu fluxo de trabalho. Experimente hoje mesmo essas soluções imperdíveis para aproveitar ao máximo as vantagens da IA e impulsionar sua produtividade criativa. Explore agora no XIX.AI.
10 ferramentas
xix.ai

Os melhores tutores de IA para preparação para exames de 2026, com as melhores avaliações, estão aqui no XIX.AI! Nossa lista cuidadosamente selecionada apresenta ferramentas poderosas e revolucionárias que oferecem comparação entre versões gratuitas e pagas, testes práticos e rankings atualizados semanalmente. Elas ajudam a aumentar sua eficiência na redação, simplificar o aprendizado de tópicos complexos e liberar seu potencial acadêmico. Explore agora para descobrir sua ferramenta perfeita de preparação para exames e comece a criar hoje mesmo para aproveitar toda a vantagem da IA!
10 ferramentas
xix.ai

As melhores e mais bem avaliadas ferramentas de planejamento orçamentário com IA para gestão financeira pessoal de 2026 estão aqui no XIX.AI! Esta seleção especial apresenta soluções poderosas e revolucionárias que ajudam você a realizar testes na prática, entender hábitos de consumo e criar planos personalizados para aumentar a produtividade. Confira uma comparação entre versões gratuitas e pagas, além de rankings detalhados. Ferramentas imperdíveis, projetadas para simplificar a gestão financeira e explorar o potencial da IA. Explore agora!
11 ferramentas
xix.ai

2026 – Os melhores assistentes de rastreamento do sono com inteligência artificial mais bem avaliados, selecionados para proporcionar uma recuperação máxima. Este guia semanal completamente atualizado apresenta ferramentas poderosas que incluem testes reais, comparações entre versões gratuitas e pagas, além de classificações detalhadas, visando ajudá-lo a encontrar a solução ideal para melhorar a qualidade do sono e fomentar hábitos noturnos mais saudáveis. Explore agora em XIX.AI e aproveite todas as vantagens oferecidas pela inteligência artificial.
10 ferramentas
xix.ai

2026: Os melhores e mais bem avaliados copilotos de IA para SQL em análise de produtos e receitas! A XIX.AI selecionou um conjunto poderoso e revolucionário de ferramentas imperdíveis, que passam por testes práticos por meio de rankings atualizados semanalmente. Essas ferramentas ajudam os usuários a aumentar significativamente a produtividade, acelerando a análise de dados, simplificando consultas complexas e gerando insights precisos para impulsionar decisões de negócios mais inteligentes. Explore agora e descubra a ferramenta perfeita para aproveitar ao máximo o potencial da IA!
14 ferramentas
xix.ai

2026: Os melhores e mais bem avaliados auxiliares de tarefas com IA que ensinam conceitos fundamentais, não apenas respostas. Ferramentas poderosas para estudantes. Lista selecionada que você não pode deixar de conferir. Atualizada semanalmente. Comparação entre versões gratuitas e pagas. Testes em situações reais. Rankings precisos para ajudar você a atingir todo o seu potencial de aprendizado. Explore agora e descubra a ferramenta perfeita para estudar de forma mais inteligente.
10 ferramentas
xix.ai












