


 Lar
Preço do cache de entrada da API DeepSeek reduzido para um décimo do valor original
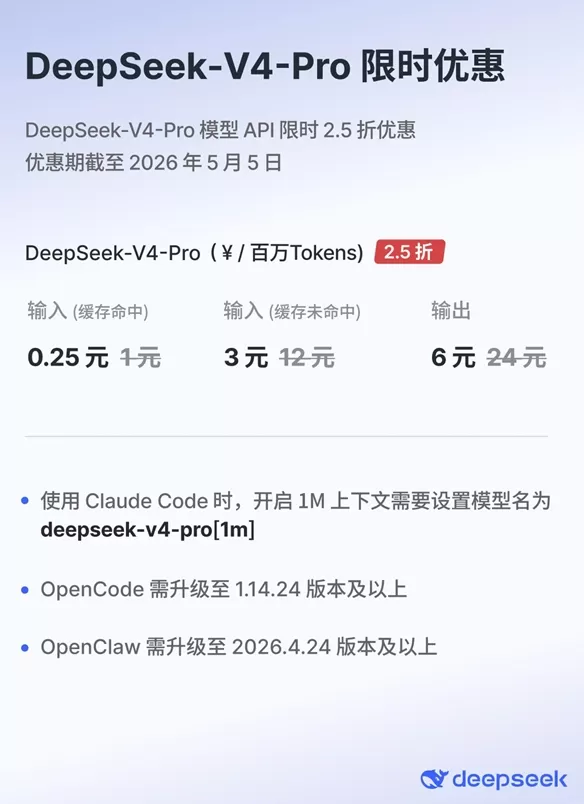
O DeepSeek, principal modelo de linguagem de grande porte do mercado nacional, anunciou recentemente uma redução significativa nos preços, diminuindo o custo por acerto no cache de entrada em todas as séries de API para um décimo da tarifa original. Essa medida marca uma nova fase na gestão de custos da IA nacional, com o objetivo de atrair mais desenvolvedores e empresas ao oferecer uma excelente relação custo-benefício.
Reduções de preço essenciais abordam os pontos críticos do setor
Este ajuste de preço abrange toda a série V4-Pro e V4-Flash. O preço do cache de entrada para o V4-Pro foi reduzido para 0,1 RMB por milhão de tokens e, com uma promoção por tempo limitado, o pagamento efetivo é de apenas 0,025 RMB. Em comparação com concorrentes internacionais, o preço do cache de entrada é de apenas 1/700 do GPT-5.5 Pro, demonstrando forte competitividade no mercado.
Além dos cenários de acerto de cache, os preços para cenários de falha de cache e saída também foram reduzidos para um quarto do preço original. Essa estratégia de preços visa precisamente casos de uso de alta frequência, como bases de conhecimento RAG, atendimento inteligente ao cliente e análise de documentos, com potencial para reduzir os custos operacionais das empresas em mais de 90%.
A capacidade do DeepSeek de reduzir significativamente os preços decorre de sua arquitetura de atenção esparsa desenvolvida internamente. Essa tecnologia suporta o processamento de contextos ultralongos de até 160 mil caracteres, melhorando a eficiência no tratamento de textos longos e, ao mesmo tempo, reduzindo efetivamente o consumo de energia de computação e os custos de armazenamento subjacentes.
Artigo relacionado
 O ex-pesquisador da OpenAI, Barrett Zoph, retorna ao Google para apoiar o desenvolvimento do Gemini
Barret Zoph, que anteriormente havia deixado a empresa de forma repentina e se juntado à OpenAI devido a um desentendimento com a CEO da Thinking Machines Lab, Miriam Mularati, mudou de emprego mais u
Como a Recursive Intelligence levantou US$ 335 milhões com uma avaliação de US$ 4 bilhões em 4 meses
As cofundadoras da startup Ricursive Intelligence pareciam destinadas a serem cofundadoras.Anna Goldie, CEO, e Azalia Mirhoseini, CTO, são tão conhecidas na comunidade de IA que estavam entre os engen
A corrida pela IA não vai esperar, nem esse desconto de 25% do TechCrunch Disrupt
Todo fundador que está trabalhando com IA neste momento faz a mesma pergunta: será que estamos avançando rápido o suficiente e de forma eficaz o suficiente? O TechCrunch Disrupt 2026 coloca você na me
Recomendações de tópicos especiais relacionados
Design e Arte
 As melhores ferramentas de ilustração com IA: crie cenas editoriais e capas de forma mais rápida
As melhores ferramentas de ilustração com IA de 2026: nossa lista selecionada apresenta as melhores ferramentas, com design robusto, para criar rapidamente cenas editoriais impressionantes e capas atraentes. Cada opção passou por rigorosos testes práticos, oferecendo uma comparação entre versões gratuitas e pagas para ajudar você a encontrar a opção perfeita para o seu fluxo de trabalho. Experimente hoje mesmo essas soluções imperdíveis para aproveitar ao máximo as vantagens da IA e impulsionar sua produtividade criativa. Explore agora no XIX.AI.
 10 ferramentas
 xix.ai
Educação e Aprendizagem
Os melhores professores particulares especializados em IA para preparação para exames: pratique matemática, ciências e inglês
Os melhores tutores de IA para preparação para exames de 2026, com as melhores avaliações, estão aqui no XIX.AI! Nossa lista cuidadosamente selecionada apresenta ferramentas poderosas e revolucionárias que oferecem comparação entre versões gratuitas e pagas, testes práticos e rankings atualizados semanalmente. Elas ajudam a aumentar sua eficiência na redação, simplificar o aprendizado de tópicos complexos e liberar seu potencial acadêmico. Explore agora para descobrir sua ferramenta perfeita de preparação para exames e comece a criar hoje mesmo para aproveitar toda a vantagem da IA!
10 ferramentas
xix.ai
Financiar
Ferramentas de planejamento orçamentário com IA para gestão financeira pessoal
As melhores e mais bem avaliadas ferramentas de planejamento orçamentário com IA para gestão financeira pessoal de 2026 estão aqui no XIX.AI! Esta seleção especial apresenta soluções poderosas e revolucionárias que ajudam você a realizar testes na prática, entender hábitos de consumo e criar planos personalizados para aumentar a produtividade. Confira uma comparação entre versões gratuitas e pagas, além de rankings detalhados. Ferramentas imperdíveis, projetadas para simplificar a gestão financeira e explorar o potencial da IA. Explore agora!
11 ferramentas
xix.ai
Saúde e Bem-Estar
Assistentes de rastreamento do sono com IA: melhore sua recuperação adotando hábitos mais adequados antes de dormir
2026 – Os melhores assistentes de rastreamento do sono com inteligência artificial mais bem avaliados, selecionados para proporcionar uma recuperação máxima. Este guia semanal completamente atualizado apresenta ferramentas poderosas que incluem testes reais, comparações entre versões gratuitas e pagas, além de classificações detalhadas, visando ajudá-lo a encontrar a solução ideal para melhorar a qualidade do sono e fomentar hábitos noturnos mais saudáveis. Explore agora em XIX.AI e aproveite todas as vantagens oferecidas pela inteligência artificial.
10 ferramentas
xix.ai
Análise de dados
Copilotos de IA em SQL para análise de produtos e receitas
2026: Os melhores e mais bem avaliados copilotos de IA para SQL em análise de produtos e receitas! A XIX.AI selecionou um conjunto poderoso e revolucionário de ferramentas imperdíveis, que passam por testes práticos por meio de rankings atualizados semanalmente. Essas ferramentas ajudam os usuários a aumentar significativamente a produtividade, acelerando a análise de dados, simplificando consultas complexas e gerando insights precisos para impulsionar decisões de negócios mais inteligentes. Explore agora e descubra a ferramenta perfeita para aproveitar ao máximo o potencial da IA!
14 ferramentas
xix.ai
Educação e Aprendizagem
Os melhores auxiliares de tarefas escolares com IA que ensinam: aprenda conceitos, não apenas respostas
2026: Os melhores e mais bem avaliados auxiliares de tarefas com IA que ensinam conceitos fundamentais, não apenas respostas. Ferramentas poderosas para estudantes. Lista selecionada que você não pode deixar de conferir. Atualizada semanalmente. Comparação entre versões gratuitas e pagas. Testes em situações reais. Rankings precisos para ajudar você a atingir todo o seu potencial de aprendizado. Explore agora e descubra a ferramenta perfeita para estudar de forma mais inteligente.
10 ferramentas
xix.ai

 Comentários (0)
O DeepSeek, principal modelo de linguagem de grande porte do mercado nacional, anunciou recentemente uma redução significativa nos preços, diminuindo o custo por acerto no cache de entrada em todas as séries de API para um décimo da tarifa original. Essa medida marca uma nova fase na gestão de custos da IA nacional, com o objetivo de atrair mais desenvolvedores e empresas ao oferecer uma excelente relação custo-benefício.
Reduções de preço essenciais abordam os pontos críticos do setor
Este ajuste de preço abrange toda a série V4-Pro e V4-Flash. O preço do cache de entrada para o V4-Pro foi reduzido para 0,1 RMB por milhão de tokens e, com uma promoção por tempo limitado, o pagamento efetivo é de apenas 0,025 RMB. Em comparação com concorrentes internacionais, o preço do cache de entrada é de apenas 1/700 do GPT-5.5 Pro, demonstrando forte competitividade no mercado.
Além dos cenários de acerto de cache, os preços para cenários de falha de cache e saída também foram reduzidos para um quarto do preço original. Essa estratégia de preços visa precisamente casos de uso de alta frequência, como bases de conhecimento RAG, atendimento inteligente ao cliente e análise de documentos, com potencial para reduzir os custos operacionais das empresas em mais de 90%.
A capacidade do DeepSeek de reduzir significativamente os preços decorre de sua arquitetura de atenção esparsa desenvolvida internamente. Essa tecnologia suporta o processamento de contextos ultralongos de até 160 mil caracteres, melhorando a eficiência no tratamento de textos longos e, ao mesmo tempo, reduzindo efetivamente o consumo de energia de computação e os custos de armazenamento subjacentes.








 O ex-pesquisador da OpenAI, Barrett Zoph, retorna ao Google para apoiar o desenvolvimento do Gemini
Barret Zoph, que anteriormente havia deixado a empresa de forma repentina e se juntado à OpenAI devido a um desentendimento com a CEO da Thinking Machines Lab, Miriam Mularati, mudou de emprego mais u
 Como a Recursive Intelligence levantou US$ 335 milhões com uma avaliação de US$ 4 bilhões em 4 meses
As cofundadoras da startup Ricursive Intelligence pareciam destinadas a serem cofundadoras.Anna Goldie, CEO, e Azalia Mirhoseini, CTO, são tão conhecidas na comunidade de IA que estavam entre os engen
 A corrida pela IA não vai esperar, nem esse desconto de 25% do TechCrunch Disrupt
Todo fundador que está trabalhando com IA neste momento faz a mesma pergunta: será que estamos avançando rápido o suficiente e de forma eficaz o suficiente? O TechCrunch Disrupt 2026 coloca você na me

As melhores ferramentas de ilustração com IA de 2026: nossa lista selecionada apresenta as melhores ferramentas, com design robusto, para criar rapidamente cenas editoriais impressionantes e capas atraentes. Cada opção passou por rigorosos testes práticos, oferecendo uma comparação entre versões gratuitas e pagas para ajudar você a encontrar a opção perfeita para o seu fluxo de trabalho. Experimente hoje mesmo essas soluções imperdíveis para aproveitar ao máximo as vantagens da IA e impulsionar sua produtividade criativa. Explore agora no XIX.AI.
10 ferramentas
xix.ai

Os melhores tutores de IA para preparação para exames de 2026, com as melhores avaliações, estão aqui no XIX.AI! Nossa lista cuidadosamente selecionada apresenta ferramentas poderosas e revolucionárias que oferecem comparação entre versões gratuitas e pagas, testes práticos e rankings atualizados semanalmente. Elas ajudam a aumentar sua eficiência na redação, simplificar o aprendizado de tópicos complexos e liberar seu potencial acadêmico. Explore agora para descobrir sua ferramenta perfeita de preparação para exames e comece a criar hoje mesmo para aproveitar toda a vantagem da IA!
10 ferramentas
xix.ai

As melhores e mais bem avaliadas ferramentas de planejamento orçamentário com IA para gestão financeira pessoal de 2026 estão aqui no XIX.AI! Esta seleção especial apresenta soluções poderosas e revolucionárias que ajudam você a realizar testes na prática, entender hábitos de consumo e criar planos personalizados para aumentar a produtividade. Confira uma comparação entre versões gratuitas e pagas, além de rankings detalhados. Ferramentas imperdíveis, projetadas para simplificar a gestão financeira e explorar o potencial da IA. Explore agora!
11 ferramentas
xix.ai

2026 – Os melhores assistentes de rastreamento do sono com inteligência artificial mais bem avaliados, selecionados para proporcionar uma recuperação máxima. Este guia semanal completamente atualizado apresenta ferramentas poderosas que incluem testes reais, comparações entre versões gratuitas e pagas, além de classificações detalhadas, visando ajudá-lo a encontrar a solução ideal para melhorar a qualidade do sono e fomentar hábitos noturnos mais saudáveis. Explore agora em XIX.AI e aproveite todas as vantagens oferecidas pela inteligência artificial.
10 ferramentas
xix.ai

2026: Os melhores e mais bem avaliados copilotos de IA para SQL em análise de produtos e receitas! A XIX.AI selecionou um conjunto poderoso e revolucionário de ferramentas imperdíveis, que passam por testes práticos por meio de rankings atualizados semanalmente. Essas ferramentas ajudam os usuários a aumentar significativamente a produtividade, acelerando a análise de dados, simplificando consultas complexas e gerando insights precisos para impulsionar decisões de negócios mais inteligentes. Explore agora e descubra a ferramenta perfeita para aproveitar ao máximo o potencial da IA!
14 ferramentas
xix.ai

2026: Os melhores e mais bem avaliados auxiliares de tarefas com IA que ensinam conceitos fundamentais, não apenas respostas. Ferramentas poderosas para estudantes. Lista selecionada que você não pode deixar de conferir. Atualizada semanalmente. Comparação entre versões gratuitas e pagas. Testes em situações reais. Rankings precisos para ajudar você a atingir todo o seu potencial de aprendizado. Explore agora e descubra a ferramenta perfeita para estudar de forma mais inteligente.
10 ferramentas
xix.ai












