


 Lar
Regras de direitos autorais de conteúdo de IA: Como manter sua sala limpa protegida
À medida que a IA generativa se torna mais difundida, as complexidades legais dos direitos autorais e da privacidade dos dados estão se intensificando. Proteger os dados de treinamento e a integridade dos resultados da IA é fundamental para o desenvolvimento responsável. Este artigo examina os métodos de privacidade diferencial e a estratégia de "sala limpa" para proteção de direitos autorais, detalhando como essas estruturas ajudam a proteger os modelos de IA e seus usuários.
Pontos principais
Entender como a privacidade diferencial se aplica à IA generativa.
Examinar a metodologia de "sala limpa" para proteção de direitos autorais.
Abordar a dificuldade de aplicar a lei de direitos autorais convencional ao material gerado por IA.
Implementação de táticas para impedir que os modelos de IA memorizem e reutilizem conteúdo protegido por direitos autorais.
Debater as consequências legais e éticas da linhagem de dados no treinamento de IA.
Revisar as técnicas de marca d'água de resultados de IA para estabelecer a propriedade dos direitos autorais.
Avaliar como a privacidade diferencial e as proteções de direitos autorais influenciam a criação e a implementação de modelos de linguagem grandes (LLMs).
A interseção da privacidade diferencial e dos direitos autorais
Privacidade diferencial: Proteção de dados em IA generativa
A privacidade diferencial é uma estrutura que permite a análise de dados e, ao mesmo tempo, protege as informações individuais. Ela funciona com a introdução de ruído estatístico nos conjuntos de dados, o que ajuda a ocultar qualquer entrada individual. Para a IA generativa, isso impede que os modelos memorizem e reproduzam conteúdo protegido. Vários fatores, inclusive métodos de treinamento, influenciam a eficácia da privacidade diferencial.
Por que a privacidade diferencial é essencial para a IA generativa?
Seus benefícios incluem:
- Impedir a replicação acidental de trabalhos protegidos por direitos autorais.
- Manter a confidencialidade dos dados do usuário utilizados no treinamento.
- Promover a criação de sistemas de IA eticamente sólidos.
A privacidade diferencial serve como base para a segurança de dados e operações éticas na IA generativa. A implementação das técnicas a seguir é fundamental para a criação de um modelo de privacidade diferencial bem-sucedido:
Técnica Descrição Adição de ruído Introduzir variações estatísticas nos pontos de dados para mascarar registros individuais. Isso faz com que seja difícil para a IA memorizar detalhes específicos, formando a base da privacidade diferencial. Recorte de gradientes Restringir o tamanho das atualizações de gradiente durante o treinamento do modelo. Essa etapa garante que nenhum ponto de dados único molde excessivamente o modelo, reduzindo o risco de memorização ou ajuste excessivo. Sanitização de parâmetros Remoção de parâmetros do modelo associados a material protegido por direitos autorais. O modelo aprende a reconhecer e excluir esses elementos, resultando em uma versão final mais limpa.
A aplicação desses métodos é particularmente importante para o avanço ético da IA.
A abordagem de sala limpa: Um ambiente seguro para o desenvolvimento de IA
O conceito de "sala limpa", emprestado da engenharia de software, oferece um espaço protegido e isolado para proteger a propriedade intelectual em projetos de IA.
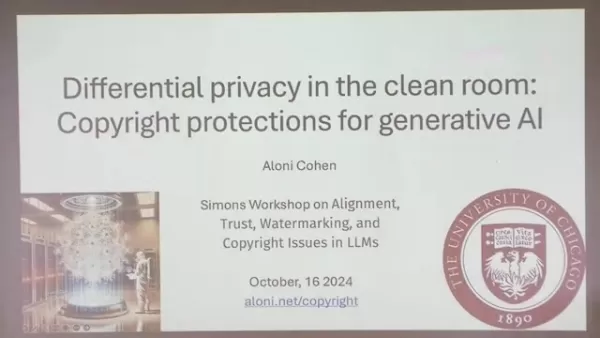
Essa configuração permite que os desenvolvedores lidem com informações confidenciais ou protegidas por direitos autorais, minimizando a chance de seu uso não autorizado nos resultados da IA. Em geral, ela incorpora sistemas criados especificamente para evitar a violação de direitos autorais.
Práticas recomendadas para salas limpas:
- Espaços dedicados e segregados com entrada restrita.
- Procedimentos rigorosos para importação e exportação de dados.
- Validação externa dos resultados da IA quanto à adesão aos direitos autorais.
- Avaliação contínua do comportamento da IA quanto a indicações de retenção ou cópia de dados.
Modelos de treinamento em uma arquitetura de confiança zero.
Uma configuração de sala limpa oferece uma forte garantia de que a propriedade intelectual e a segurança são fundamentais para o processo de desenvolvimento de IA.
Por que os direitos autorais são tão importantes
É fundamental equilibrar as proteções de direitos autorais e a marca d'água com as demandas de treinamento de IA. Modelos adequadamente calibrados ajudam a reduzir os riscos e a aumentar os benefícios para a sociedade.
Várias organizações, incluindo o The New York Times, iniciaram ações judiciais de direitos autorais contra a OpenAI.
Principais alegações no caso do The New York Times:
- O GPT-4 pode reproduzir artigos do New York Times na íntegra.
- Os dados de treinamento incluíam anteriormente conteúdo do Hoan Ton-That.
Como as marcas d'água ajudam nas reivindicações de direitos autorais?
A marca d'água ajuda na proteção do conteúdo e gera confiança nos processos de treinamento de IA. As variedades comuns incluem:
- Marcas d'água visíveis
- Marcas d'água invisíveis
- Marcas d'água robustas - resistentes a alterações como compressão
- Marcas d'água frágeis
É importante observar que nenhuma solução de marca d'água é totalmente infalível. Os métodos avançados podem, às vezes, contornar, contornar ou removê-las. A privacidade diferencial oferece uma maneira mais direta de proteger os dados do usuário.
Em última análise, essas abordagens visam proteger tanto o sistema de IA quanto os direitos dos detentores de direitos autorais.
Principais desafios
O campo minado ético
Como podemos verificar a qualidade dos dados e rastrear suas origens até um nível aceito? O que constitui uma proteção de direitos autorais justa e prática? Considerando a abundância de material protegido por direitos autorais disponível gratuitamente on-line, quais critérios devem orientar sua inclusão ou exclusão? Essas são questões legais e morais complexas que exigem uma navegação cuidadosa.
Implementação da privacidade diferencial
Prós
Protege os dados do usuário durante todo o ciclo de treinamento da IA.
Reduz a probabilidade de os modelos de IA reterem informações protegidas por direitos autorais.
Incentiva a criação de sistemas de IA alinhados eticamente.
Potencialmente reduz a exposição a ações judiciais de direitos autorais.
Contras
Pode diminuir a precisão e a qualidade dos resultados da IA devido ao ruído introduzido.
A implementação pode exigir um poder de computação considerável.
Requer conhecimento técnico especializado para configuração e manutenção.
PERGUNTAS FREQUENTES
O que é privacidade diferencial em IA?
A privacidade diferencial em IA envolve a adição de ruído cuidadosamente calibrado aos conjuntos de dados, permitindo que os modelos aprendam padrões gerais sem acessar ou lembrar detalhes específicos e confidenciais. Isso mantém a utilidade estatística e, ao mesmo tempo, garante a privacidade individual.
Como a abordagem de "sala limpa" protege os direitos autorais na IA generativa?
O método da sala limpa estabelece um espaço de desenvolvimento seguro e isolado com controles de dados rigorosos. Ele evita a exposição direta a fontes protegidas por direitos autorais, garantindo que os resultados da IA sejam originais e estejam em conformidade com a legislação.
Quais são alguns dos desafios da adaptação das estruturas de direitos autorais existentes à IA generativa?
As principais questões envolvem a definição de autoria para trabalhos gerados por IA, o esclarecimento de exceções de uso justo para treinamento de modelos e a aplicação de direitos autorais quando os sistemas de IA podem replicar conteúdo protegido. Muitos aspectos jurídicos e econômicos ainda não foram resolvidos.
Perguntas relacionadas
As imagens geradas por IA podem ser protegidas por direitos autorais?
Atualmente, não existe um padrão universal. A legislação está evoluindo rapidamente na maioria das jurisdições. Espera-se que uma estrutura legal e ética abrangente surja em um futuro próximo.
Como as marcas d'água funcionam para proteger os direitos autorais do conteúdo gerado por IA?
As marcas d'água são marcadores digitais incorporados ao material gerado por IA para indicar a propriedade. Elas podem ser visíveis ou ocultas, e as versões robustas persistem em edições como a compressão. Marcas d'água frágeis são quebradas quando adulteradas, indicando possível uso indevido.
O que são modelos de linguagem grandes (LLMs)?
Os LLMs são sistemas de IA treinados em conjuntos de dados enormes, normalmente usados para gerar textos e imagens. Seus requisitos de dados extensos são um dos principais motivos pelos quais os direitos autorais e a privacidade dos dados se tornaram preocupações tão urgentes.
Artigo relacionado
 A OpenAI promete não aumentar as contas de energia e usar pouca água nos data centers
Amid growing resistance to AI infrastructure nationwide, OpenAI is shifting to a more collaborative strategy. A July 23 Business Insider report reveals that OpenAI is actively seeking community backing for Project Camellia, a proposed data center cam
A OpenAI e as gigantes da tecnologia disputam engenheiros de implantação de front-end, à medida que a demanda cresce mais de 700%
A última reportagem do Business Insider destaca um aumento na demanda por profissionais com habilidades práticas em tecnologia, impulsionado pela rápida adoção de grandes modelos e IA generativa. Dado
Como corrigir as Core Web Vitals para melhorar as classificações de SEO?
Transforme seu Fluxo de Trabalho 3D com o 3DFY AIIntroduçãoUma Nova Era para Artistas 3D3DFY AI: Um Grande Salto AdianteTransformando Ativos 2D em Modelos 3DDe Prompts de Texto a Ativos 3D AperfeiçoadosUm Processo de Criação SimplificadoTrês E
Recomendações de tópicos especiais relacionados
escrita
 Ferramentas de Título para Blog de IA para Taxas Mais Altas de Clique
2026 Últimas Melhores Ferramentas de Títulos para Blogs de IA Mais Bem Avaliadas para Maiores Taxas de Clique! A XIX.AI cuidadosamente selecionou uma coleção poderosa e transformadora das melhores ferramentas que passam por rigorosos testes no mundo real. Você encontrará uma comparação entre gratuito e pago, rankings atualizados semanalmente e insights detalhados para ajudá-lo a aumentar o tráfego do seu blog de forma eficiente. As opções imperdíveis estão destacadas para ajudá-lo a desbloquear sua vantagem com IA. Explore agora!
 10 ferramentas
 xix.ai
automação
As melhores ferramentas de roteamento de tarefas com IA para fluxos de trabalho de suporte
As melhores e mais bem avaliadas ferramentas de roteamento de tarefas com IA para fluxos de trabalho de suporte em 2026! A XIX.AI selecionou um conjunto extremamente poderoso e revolucionário de soluções imperdíveis, todas submetidas a rigorosos testes em condições reais e atualizadas semanalmente. Essas ferramentas otimizam os fluxos de trabalho, aumentam a produtividade e ajudam as equipes a oferecer um suporte mais rápido e eficiente. Explore agora para descobrir a ferramenta perfeita para você e aproveitar ao máximo as vantagens da IA!
17 ferramentas
xix.ai
Pesquisa Acadêmica
Ferramentas de IA para citações e resumos de artigos
As melhores e mais bem avaliadas ferramentas de 2026 para citações e resumos de artigos com IA, selecionadas pela XIX.AI. Obtenha soluções poderosas e revolucionárias para a criação rápida de conteúdo, maior eficiência na redação e aumento da produtividade. Oferecemos uma comparação entre versões gratuitas e pagas, além de testes práticos e rankings atualizados semanalmente, para ajudá-lo a encontrar a ferramenta indispensável que atenda perfeitamente às suas necessidades. Explore agora para explorar todo o potencial da IA.
10 ferramentas
xix.ai
Produtividade
As melhores ferramentas de produtividade com IA para o trabalho diário
As melhores e mais bem avaliadas ferramentas de produtividade com IA para o trabalho diário em 2026! A XIX.AI selecionou uma lista poderosa e revolucionária com base em rankings rigorosos, atualizados semanalmente, e em testes práticos. Você encontrará opções imperdíveis que aumentam a eficiência na redação, agilizam a criação de conteúdo e ajudam a superar os desafios do dia a dia no trabalho. Veja uma comparação entre versões gratuitas e pagas para encontrar a opção perfeita para suas necessidades. Explore agora e descubra sua vantagem com a IA!
9 ferramentas
xix.ai
Pesquisa Acadêmica
Ferramentas de revisão sistemática baseadas em IA para triagem de pesquisas
As melhores e mais bem avaliadas ferramentas de revisão sistemática com IA para triagem de pesquisas de 2026 já estão disponíveis no XIX.AI! Esta coleção cuidadosamente selecionada inclui soluções poderosas e revolucionárias que passam por testes rigorosos no mundo real para oferecer resultados precisos. Também oferecemos uma comparação entre versões gratuitas e pagas, além de rankings atualizados semanalmente, para ajudá-lo a encontrar a opção imperdível que aumentará significativamente a eficiência de sua pesquisa. Explore agora para aproveitar toda a vantagem da IA em seu trabalho acadêmico!
11 ferramentas
xix.ai
Design e Arte
Ferramentas de moodboard com IA para direção de marca e direção de arte
As melhores e mais recentes ferramentas de moodboard com IA para marcas e direção de arte em 2026! A XIX.AI selecionou uma lista das ferramentas mais bem avaliadas, poderosas e revolucionárias que ajudam os criadores a aumentar significativamente a produtividade. Você encontrará rankings detalhados atualizados semanalmente, comparações entre versões gratuitas e pagas e testes práticos para ajudá-lo a escolher a opção perfeita. Entre os recursos imperdíveis estão a geração instantânea de ideias, a colaboração integrada e fluxos de trabalho otimizados para todos os seus projetos de design. Explore agora para aproveitar ao máximo as vantagens da IA!
9 ferramentas
xix.ai

 Comentários (2)
![DavidLewis]()
Is the 'clean room' approach actually viable when models are trained on billions of scraped datasets? It feels like trying to keep a pool clean while dumping sewage upstream. 🌊 The article's point about differential privacy is crucial, but enforcement remains a nightmare for developers. We need clearer legal frameworks, not just technical workarounds, before this becomes a legal minefield for startups. 🚫⚖️
![SebastianAnderson]()
¿Has pensado en cómo el copyright cambia la industria ahora con la IA? En cierto modo, esto me recuerda a cuando se popularizó la fotografía y la gente debatía si violaba derechos de autor 🔍. En mi opinión, es clave que las empresas sean transparentes con los datos de entrenamiento. Esto no solo evita demandas, sino que construye confianza. Personalmente, trato de usar solo herramientas que especifiquen el origen de sus datos… aunque a veces no es fácil encontrarlas 🧐.
À medida que a IA generativa se torna mais difundida, as complexidades legais dos direitos autorais e da privacidade dos dados estão se intensificando. Proteger os dados de treinamento e a integridade dos resultados da IA é fundamental para o desenvolvimento responsável. Este artigo examina os métodos de privacidade diferencial e a estratégia de "sala limpa" para proteção de direitos autorais, detalhando como essas estruturas ajudam a proteger os modelos de IA e seus usuários.
Pontos principais
Entender como a privacidade diferencial se aplica à IA generativa.
Examinar a metodologia de "sala limpa" para proteção de direitos autorais.
Abordar a dificuldade de aplicar a lei de direitos autorais convencional ao material gerado por IA.
Implementação de táticas para impedir que os modelos de IA memorizem e reutilizem conteúdo protegido por direitos autorais.
Debater as consequências legais e éticas da linhagem de dados no treinamento de IA.
Revisar as técnicas de marca d'água de resultados de IA para estabelecer a propriedade dos direitos autorais.
Avaliar como a privacidade diferencial e as proteções de direitos autorais influenciam a criação e a implementação de modelos de linguagem grandes (LLMs).
A interseção da privacidade diferencial e dos direitos autorais
Privacidade diferencial: Proteção de dados em IA generativa
A privacidade diferencial é uma estrutura que permite a análise de dados e, ao mesmo tempo, protege as informações individuais. Ela funciona com a introdução de ruído estatístico nos conjuntos de dados, o que ajuda a ocultar qualquer entrada individual. Para a IA generativa, isso impede que os modelos memorizem e reproduzam conteúdo protegido. Vários fatores, inclusive métodos de treinamento, influenciam a eficácia da privacidade diferencial.
Por que a privacidade diferencial é essencial para a IA generativa?
Seus benefícios incluem:
- Impedir a replicação acidental de trabalhos protegidos por direitos autorais.
- Manter a confidencialidade dos dados do usuário utilizados no treinamento.
- Promover a criação de sistemas de IA eticamente sólidos.
A privacidade diferencial serve como base para a segurança de dados e operações éticas na IA generativa. A implementação das técnicas a seguir é fundamental para a criação de um modelo de privacidade diferencial bem-sucedido:
| Técnica | Descrição |
|---|---|
| Adição de ruído | Introduzir variações estatísticas nos pontos de dados para mascarar registros individuais. Isso faz com que seja difícil para a IA memorizar detalhes específicos, formando a base da privacidade diferencial. |
| Recorte de gradientes | Restringir o tamanho das atualizações de gradiente durante o treinamento do modelo. Essa etapa garante que nenhum ponto de dados único molde excessivamente o modelo, reduzindo o risco de memorização ou ajuste excessivo. |
| Sanitização de parâmetros | Remoção de parâmetros do modelo associados a material protegido por direitos autorais. O modelo aprende a reconhecer e excluir esses elementos, resultando em uma versão final mais limpa. |
A aplicação desses métodos é particularmente importante para o avanço ético da IA.
A abordagem de sala limpa: Um ambiente seguro para o desenvolvimento de IA
O conceito de "sala limpa", emprestado da engenharia de software, oferece um espaço protegido e isolado para proteger a propriedade intelectual em projetos de IA.
Essa configuração permite que os desenvolvedores lidem com informações confidenciais ou protegidas por direitos autorais, minimizando a chance de seu uso não autorizado nos resultados da IA. Em geral, ela incorpora sistemas criados especificamente para evitar a violação de direitos autorais.
Práticas recomendadas para salas limpas:
- Espaços dedicados e segregados com entrada restrita.
- Procedimentos rigorosos para importação e exportação de dados.
- Validação externa dos resultados da IA quanto à adesão aos direitos autorais.
- Avaliação contínua do comportamento da IA quanto a indicações de retenção ou cópia de dados.
Modelos de treinamento em uma arquitetura de confiança zero.
Uma configuração de sala limpa oferece uma forte garantia de que a propriedade intelectual e a segurança são fundamentais para o processo de desenvolvimento de IA.
Por que os direitos autorais são tão importantes
É fundamental equilibrar as proteções de direitos autorais e a marca d'água com as demandas de treinamento de IA. Modelos adequadamente calibrados ajudam a reduzir os riscos e a aumentar os benefícios para a sociedade.
Várias organizações, incluindo o The New York Times, iniciaram ações judiciais de direitos autorais contra a OpenAI.
Principais alegações no caso do The New York Times:
- O GPT-4 pode reproduzir artigos do New York Times na íntegra.
- Os dados de treinamento incluíam anteriormente conteúdo do Hoan Ton-That.
Como as marcas d'água ajudam nas reivindicações de direitos autorais?
A marca d'água ajuda na proteção do conteúdo e gera confiança nos processos de treinamento de IA. As variedades comuns incluem:
- Marcas d'água visíveis
- Marcas d'água invisíveis
- Marcas d'água robustas - resistentes a alterações como compressão
- Marcas d'água frágeis
É importante observar que nenhuma solução de marca d'água é totalmente infalível. Os métodos avançados podem, às vezes, contornar, contornar ou removê-las. A privacidade diferencial oferece uma maneira mais direta de proteger os dados do usuário.
Em última análise, essas abordagens visam proteger tanto o sistema de IA quanto os direitos dos detentores de direitos autorais.
Principais desafios
O campo minado ético
Como podemos verificar a qualidade dos dados e rastrear suas origens até um nível aceito? O que constitui uma proteção de direitos autorais justa e prática? Considerando a abundância de material protegido por direitos autorais disponível gratuitamente on-line, quais critérios devem orientar sua inclusão ou exclusão? Essas são questões legais e morais complexas que exigem uma navegação cuidadosa.
Implementação da privacidade diferencial
Prós
Protege os dados do usuário durante todo o ciclo de treinamento da IA.
Reduz a probabilidade de os modelos de IA reterem informações protegidas por direitos autorais.
Incentiva a criação de sistemas de IA alinhados eticamente.
Potencialmente reduz a exposição a ações judiciais de direitos autorais.
Contras
Pode diminuir a precisão e a qualidade dos resultados da IA devido ao ruído introduzido.
A implementação pode exigir um poder de computação considerável.
Requer conhecimento técnico especializado para configuração e manutenção.
PERGUNTAS FREQUENTES
O que é privacidade diferencial em IA?
A privacidade diferencial em IA envolve a adição de ruído cuidadosamente calibrado aos conjuntos de dados, permitindo que os modelos aprendam padrões gerais sem acessar ou lembrar detalhes específicos e confidenciais. Isso mantém a utilidade estatística e, ao mesmo tempo, garante a privacidade individual.
Como a abordagem de "sala limpa" protege os direitos autorais na IA generativa?
O método da sala limpa estabelece um espaço de desenvolvimento seguro e isolado com controles de dados rigorosos. Ele evita a exposição direta a fontes protegidas por direitos autorais, garantindo que os resultados da IA sejam originais e estejam em conformidade com a legislação.
Quais são alguns dos desafios da adaptação das estruturas de direitos autorais existentes à IA generativa?
As principais questões envolvem a definição de autoria para trabalhos gerados por IA, o esclarecimento de exceções de uso justo para treinamento de modelos e a aplicação de direitos autorais quando os sistemas de IA podem replicar conteúdo protegido. Muitos aspectos jurídicos e econômicos ainda não foram resolvidos.
Perguntas relacionadas
As imagens geradas por IA podem ser protegidas por direitos autorais?
Atualmente, não existe um padrão universal. A legislação está evoluindo rapidamente na maioria das jurisdições. Espera-se que uma estrutura legal e ética abrangente surja em um futuro próximo.
Como as marcas d'água funcionam para proteger os direitos autorais do conteúdo gerado por IA?
As marcas d'água são marcadores digitais incorporados ao material gerado por IA para indicar a propriedade. Elas podem ser visíveis ou ocultas, e as versões robustas persistem em edições como a compressão. Marcas d'água frágeis são quebradas quando adulteradas, indicando possível uso indevido.
O que são modelos de linguagem grandes (LLMs)?
Os LLMs são sistemas de IA treinados em conjuntos de dados enormes, normalmente usados para gerar textos e imagens. Seus requisitos de dados extensos são um dos principais motivos pelos quais os direitos autorais e a privacidade dos dados se tornaram preocupações tão urgentes.








 A OpenAI promete não aumentar as contas de energia e usar pouca água nos data centers
Amid growing resistance to AI infrastructure nationwide, OpenAI is shifting to a more collaborative strategy. A July 23 Business Insider report reveals that OpenAI is actively seeking community backing for Project Camellia, a proposed data center cam
 A OpenAI e as gigantes da tecnologia disputam engenheiros de implantação de front-end, à medida que a demanda cresce mais de 700%
A última reportagem do Business Insider destaca um aumento na demanda por profissionais com habilidades práticas em tecnologia, impulsionado pela rápida adoção de grandes modelos e IA generativa. Dado
 Como corrigir as Core Web Vitals para melhorar as classificações de SEO?
Transforme seu Fluxo de Trabalho 3D com o 3DFY AIIntroduçãoUma Nova Era para Artistas 3D3DFY AI: Um Grande Salto AdianteTransformando Ativos 2D em Modelos 3DDe Prompts de Texto a Ativos 3D AperfeiçoadosUm Processo de Criação SimplificadoTrês E

2026 Últimas Melhores Ferramentas de Títulos para Blogs de IA Mais Bem Avaliadas para Maiores Taxas de Clique! A XIX.AI cuidadosamente selecionou uma coleção poderosa e transformadora das melhores ferramentas que passam por rigorosos testes no mundo real. Você encontrará uma comparação entre gratuito e pago, rankings atualizados semanalmente e insights detalhados para ajudá-lo a aumentar o tráfego do seu blog de forma eficiente. As opções imperdíveis estão destacadas para ajudá-lo a desbloquear sua vantagem com IA. Explore agora!
10 ferramentas
xix.ai

As melhores e mais bem avaliadas ferramentas de roteamento de tarefas com IA para fluxos de trabalho de suporte em 2026! A XIX.AI selecionou um conjunto extremamente poderoso e revolucionário de soluções imperdíveis, todas submetidas a rigorosos testes em condições reais e atualizadas semanalmente. Essas ferramentas otimizam os fluxos de trabalho, aumentam a produtividade e ajudam as equipes a oferecer um suporte mais rápido e eficiente. Explore agora para descobrir a ferramenta perfeita para você e aproveitar ao máximo as vantagens da IA!
17 ferramentas
xix.ai

As melhores e mais bem avaliadas ferramentas de 2026 para citações e resumos de artigos com IA, selecionadas pela XIX.AI. Obtenha soluções poderosas e revolucionárias para a criação rápida de conteúdo, maior eficiência na redação e aumento da produtividade. Oferecemos uma comparação entre versões gratuitas e pagas, além de testes práticos e rankings atualizados semanalmente, para ajudá-lo a encontrar a ferramenta indispensável que atenda perfeitamente às suas necessidades. Explore agora para explorar todo o potencial da IA.
10 ferramentas
xix.ai

As melhores e mais bem avaliadas ferramentas de produtividade com IA para o trabalho diário em 2026! A XIX.AI selecionou uma lista poderosa e revolucionária com base em rankings rigorosos, atualizados semanalmente, e em testes práticos. Você encontrará opções imperdíveis que aumentam a eficiência na redação, agilizam a criação de conteúdo e ajudam a superar os desafios do dia a dia no trabalho. Veja uma comparação entre versões gratuitas e pagas para encontrar a opção perfeita para suas necessidades. Explore agora e descubra sua vantagem com a IA!
9 ferramentas
xix.ai
As melhores e mais bem avaliadas ferramentas de revisão sistemática com IA para triagem de pesquisas de 2026 já estão disponíveis no XIX.AI! Esta coleção cuidadosamente selecionada inclui soluções poderosas e revolucionárias que passam por testes rigorosos no mundo real para oferecer resultados precisos. Também oferecemos uma comparação entre versões gratuitas e pagas, além de rankings atualizados semanalmente, para ajudá-lo a encontrar a opção imperdível que aumentará significativamente a eficiência de sua pesquisa. Explore agora para aproveitar toda a vantagem da IA em seu trabalho acadêmico!
11 ferramentas
xix.ai
As melhores e mais recentes ferramentas de moodboard com IA para marcas e direção de arte em 2026! A XIX.AI selecionou uma lista das ferramentas mais bem avaliadas, poderosas e revolucionárias que ajudam os criadores a aumentar significativamente a produtividade. Você encontrará rankings detalhados atualizados semanalmente, comparações entre versões gratuitas e pagas e testes práticos para ajudá-lo a escolher a opção perfeita. Entre os recursos imperdíveis estão a geração instantânea de ideias, a colaboração integrada e fluxos de trabalho otimizados para todos os seus projetos de design. Explore agora para aproveitar ao máximo as vantagens da IA!
9 ferramentas
xix.ai

Is the 'clean room' approach actually viable when models are trained on billions of scraped datasets? It feels like trying to keep a pool clean while dumping sewage upstream. 🌊 The article's point about differential privacy is crucial, but enforcement remains a nightmare for developers. We need clearer legal frameworks, not just technical workarounds, before this becomes a legal minefield for startups. 🚫⚖️
¿Has pensado en cómo el copyright cambia la industria ahora con la IA? En cierto modo, esto me recuerda a cuando se popularizó la fotografía y la gente debatía si violaba derechos de autor 🔍. En mi opinión, es clave que las empresas sean transparentes con los datos de entrenamiento. Esto no solo evita demandas, sino que construye confianza. Personalmente, trato de usar solo herramientas que especifiquen el origen de sus datos… aunque a veces no es fácil encontrarlas 🧐.












