


 집
AI 콘텐츠 저작권 규정: '클린룸'을 보호하는 방법
생성형 AI가 널리 보급됨에 따라 저작권과 데이터 프라이버시의 법적 복잡성이 심화되고 있습니다. 학습 데이터와 AI 결과물의 무결성을 보호하는 것은 책임감 있는 개발을 위한 기본입니다. 이 문서에서는 저작권 보호를 위한 차별적 개인정보 보호 방법과 '클린룸' 전략을 살펴보고, 이러한 프레임워크가 AI 모델과 그 사용자를 보호하는 데 어떻게 도움이 되는지 자세히 설명합니다.
핵심 사항
차등 개인정보 보호가 생성형 AI에 어떻게 적용되는지 이해하기.
저작권 보호를 위한 '클린룸' 방법론에 대해 살펴봅니다.
AI가 생성한 자료에 기존 저작권법을 적용할 때의 어려움 해결.
AI 모델이 저작권이 있는 콘텐츠를 암기하고 재사용하는 것을 막기 위한 전술 배포.
AI 학습에서 데이터 계보의 법적, 윤리적 결과에 대해 논의합니다.
저작권 소유권을 확립하기 위해 AI 출력물에 워터마킹을 하는 기술을 검토합니다.
차등 개인정보 보호 및 저작권 보호가 대규모 언어 모델(LLM)의 생성 및 구현에 어떤 영향을 미치는지 평가합니다.
차등 개인정보 보호와 저작권의 교차점
차등 개인정보 보호: 생성 AI의 데이터 보호
차등 개인정보 보호는 개인 정보를 보호하면서 데이터 분석을 가능하게 하는 프레임워크입니다. 이는 데이터 세트에 통계적 노이즈를 도입하여 단일 항목을 숨기는 데 도움이 되는 방식으로 작동합니다. 생성형 AI의 경우, 이는 모델이 보호되는 콘텐츠를 암기하고 재생산하는 것을 방지합니다. 학습 방법을 비롯한 여러 요인이 차등 개인정보 보호의 효과에 영향을 미칩니다.
차등 개인정보 보호가 제너레이티브 AI에 필수적인 이유는 무엇인가요?
다음과 같은 이점이 있습니다:
- 저작권이 있는 저작물의 우발적인 복제 방지.
- 학습에 활용되는 사용자 데이터의 기밀성 유지.
- 윤리적으로 건전한 AI 시스템 개발 촉진.
차등 개인정보 보호는 제너레이티브 AI에서 데이터 보안과 윤리적 운영의 토대가 됩니다. 성공적인 차등 프라이버시 모델을 구축하려면 다음 기술을 구현하는 것이 필수적입니다:
기술 설명 노이즈 추가하기 데이터 포인트에 통계적 변수를 도입하여 개별 레코드를 마스킹합니다. 이렇게 하면 AI가 특정 세부 정보를 기억하기 어렵게 만들어 차등 개인정보 보호의 기초를 형성합니다. 그라디언트 클리핑 모델 학습 중 그라데이션 업데이트의 크기를 제한합니다. 이 단계에서는 단일 데이터 포인트가 모델을 지나치게 형성하지 않도록 하여 암기 또는 과적합의 위험을 줄입니다. 매개변수 위생 처리 저작권이 있는 자료와 관련된 모델 매개변수를 제거합니다. 모델은 이러한 요소를 인식하고 제외하는 방법을 학습하여 최종 버전이 더 깔끔해집니다.
이러한 방법을 적용하는 것은 윤리적 AI 발전을 위해 특히 중요합니다.
클린룸 접근 방식: AI 개발을 위한 안전한 환경
소프트웨어 엔지니어링에서 차용한 '클린룸' 개념은 AI 프로젝트에서 지적 재산을 보호하기 위한 보호되고 격리된 공간을 제공합니다.
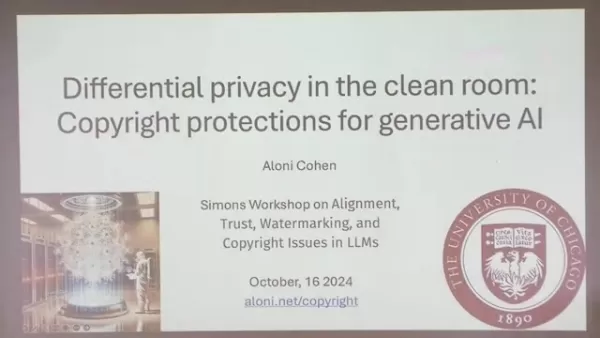
이 설정을 통해 개발자는 민감한 정보나 저작권이 있는 정보를 처리하는 동시에 AI 결과에 무단으로 사용될 가능성을 최소화할 수 있습니다. 일반적으로 저작권 침해를 방지하기 위해 특별히 구축된 시스템을 통합합니다.
권장 클린룸 관행:
- 출입이 제한된 분리된 전용 공간.
- 데이터 가져오기 및 내보내기에 대한 엄격한 절차.
- 저작권 준수를 위한 AI 출력의 외부 검증.
- 데이터 보유 또는 복사의 징후에 대한 AI 행동의 지속적인 평가.
제로 트러스트 아키텍처에서 모델 학습.
클린룸 설정은 지적 재산과 보안이 AI 개발 프로세스의 핵심임을 강력하게 보장합니다.
저작권이 중요한 이유
저작권 보호와 워터마킹은 AI 학습의 요구와 균형을 맞추는 것이 중요합니다. 적절하게 보정된 모델은 위험을 줄이고 사회적 편익을 증진하는 데 도움이 됩니다.
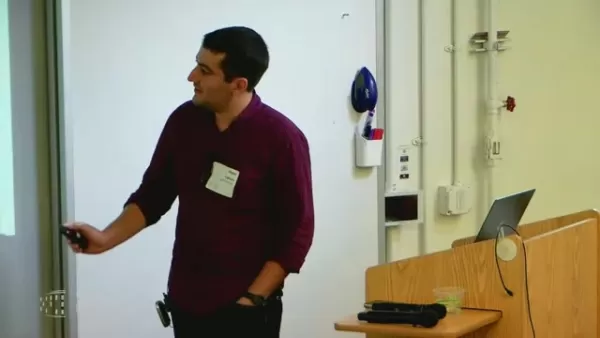
뉴욕타임스를 비롯한 여러 기관에서 OpenAI를 상대로 저작권 소송을 제기했습니다.
뉴욕 타임즈 사건의 주요 주장:
- GPT-4는 뉴욕 타임즈 기사를 그대로 복제할 수 있습니다.
- 학습 데이터에는 이전에 호안 톤 닷의 콘텐츠가 포함되어 있었습니다.
워터마크는 저작권 소송에 어떻게 도움이 되나요?
워터마킹은 콘텐츠 보호를 돕고 AI 학습 프로세스에 대한 신뢰를 구축합니다. 일반적인 종류는 다음과 같습니다:
- 보이는 워터마크
- 보이지 않는 워터마크
- 강력한 워터마크 - 압축과 같은 변경에 강한 워터마크
- 취약한 워터마크
워터마킹 솔루션 중 완벽한 워터마킹 솔루션은 없다는 점에 유의할 필요가 있습니다. 고급 방법을 사용하면 워터마크를 우회, 회피 또는 제거할 수 있습니다. 차등 개인정보 보호는 사용자 데이터를 보다 직접적으로 보호할 수 있는 방법을 제공합니다.
궁극적으로 이러한 접근 방식은 AI 시스템과 저작권 소유자의 권리를 모두 보호하는 것을 목표로 합니다.
주요 도전 과제
윤리적 지뢰밭
데이터 품질을 검증하고 데이터의 출처를 허용된 수준으로 추적하려면 어떻게 해야 할까요? 공정하고 실질적인 저작권 보호를 구성하는 것은 무엇인가요? 온라인에서 자유롭게 이용할 수 있는 저작권이 있는 자료가 넘쳐나는 상황에서 어떤 기준으로 자료를 포함하거나 제외해야 할까요? 이는 신중한 탐색이 필요한 복잡한 법적, 도덕적 질문입니다.
차등적 개인정보 보호 구현
장점
AI 학습 주기 전반에 걸쳐 사용자 데이터를 보호합니다.
AI 모델이 저작권이 있는 정보를 보유할 가능성을 줄입니다.
윤리적으로 부합하는 AI 시스템을 만들도록 장려합니다.
저작권 소송에 노출될 가능성을 낮춥니다.
단점
도입된 노이즈로 인해 AI 결과물의 정확도와 품질이 저하될 수 있습니다.
배포 시 상당한 컴퓨팅 성능이 요구될 수 있습니다.
설정 및 유지 관리를 위한 전문 기술 지식이 필요합니다.
FAQ
AI의 차등 개인정보 보호란 무엇인가요?
AI의 차등 프라이버시는 데이터 세트에 신중하게 보정된 노이즈를 추가하여 모델이 특정하고 민감한 세부 정보에 액세스하거나 기억하지 않고 일반적인 패턴을 학습할 수 있도록 하는 것입니다. 이를 통해 통계적 유용성을 유지하면서 개인의 프라이버시를 보장할 수 있습니다.
'클린룸' 접근 방식은 제너레이티브 AI에서 저작권을 어떻게 보호하나요?
클린룸 방식은 엄격한 데이터 제어를 통해 안전하고 격리된 개발 공간을 구축합니다. 저작권이 있는 소스에 직접 노출되는 것을 방지하여 AI 결과물이 독창적이고 법률을 준수하도록 보장합니다.
기존 저작권 프레임워크를 제너레이티브 AI에 적용하는 데 있어 어떤 어려움이 있나요?
주요 쟁점은 AI가 생성한 저작물에 대한 저작권을 정의하고, 모델 학습에 대한 공정 사용 예외를 명확히 하며, AI 시스템이 보호되는 콘텐츠를 복제할 수 있는 경우 저작권을 집행하는 것입니다. 많은 법적, 경제적 측면이 아직 해결되지 않은 채로 남아 있습니다.
관련 질문
AI로 생성된 이미지에 저작권이 있나요?
현재 보편적인 표준은 존재하지 않습니다. 대부분의 관할권에서 법률이 빠르게 진화하고 있습니다. 가까운 시일 내에 포괄적인 법적, 윤리적 구조가 등장할 것으로 예상됩니다.
워터마크는 AI로 생성된 콘텐츠의 저작권을 보호하기 위해 어떻게 작동하나요?
워터마크는 소유권을 나타내기 위해 AI가 생성한 자료에 삽입된 디지털 마커입니다. 워터마크는 표시되거나 숨겨질 수 있으며, 압축과 같은 편집을 통해 강력한 버전이 유지됩니다. 취약한 워터마크는 변조 시 깨지기 때문에 오용될 가능성이 있습니다.
대규모 언어 모델(LLM)이란 무엇인가요?
LLM은 대규모 데이터 세트에 대해 학습된 AI 시스템으로, 일반적으로 텍스트와 이미지를 생성하는 데 사용됩니다. 방대한 데이터 요구 사항으로 인해 저작권과 데이터 프라이버시가 시급한 문제로 대두되고 있습니다.
관련 기사
 Qwen-Audio-3.0-TTS: Qwen의 대규모 음성 합성 모델, 첫 패킷 지연 시간을 300ms로 단축
주요 AI 개발자들 간의 음성 기술 경쟁이 새로운 참여자로 인해 더욱 치열해지고 있습니다. 7월 20일, 퉁이(Qwen)는 최신 오디오 합성 모델인 Qwen-Audio-3.0-TTS를 출시하며, 복잡한 기술적 구성에서 간단한 자연어 명령으로 제어 방식을 전환했습니다.이 모델의 두드러진 특징은 자유 형식의 자연어 지시를 수용할 수 있다는 점입니다. 이전에는 특정 어조, 리듬 또는 스타일을 구현하기 위해 수많은 백엔드 매개변수를 조정해야 했습니다
Claude의 동료 기능은 이제 과거 채팅 지시사항을 기억합니다
Anthropic이 Claude의 메모리 시스템에 적용한 업데이트는 AI 에이전트 사용 시 주요 마찰점 중 하나인, AI가 이미 기억하고 있는 컨텍스트를 반복적으로 다시 설명해야 하는 문제를 해결합니다. 표준 채팅과 Claude Cowork의 메모리 아키텍처를 통합함으로써 Claude는 모든 상호작용에서 연속성을 유지하며, 다른 세션으로 전환하더라도 이전 세션에서 얻은 통찰력을 기억합니다.사용자는 이제 Claude의 메모리에 저장된 모든 정보를
천천샤오, 9년 만에 복귀, 발견 기반 AI에 20억 달러 투자
게임 왕에서 의식 개척자로: 전 억만장자의 귀환9년간의 은퇴 생활 끝에, 쉰다 그룹 창립자 천차오샤오는 2026년 3월 첫 국제 미디어 인터뷰를 가졌다. 31세의 나이에 중국 최연소 억만장자이자 게임 산업의 거물이었던 그는 이제 캘리포니아의 거주지에서 자신의 유산을 새롭게 정의하고 있다. 그의 관심사는 가상 게임에서의 승리를 넘어, 인간의 의식 소스 코드를 해독한다는 훨씬 더 복잡한 과제를 해결하는 것으로 옮겨갔다.천차오샤오는 현재 인간 지
관련 특별 주제 추천
디자인과 예술
 최고의 AI 일러스트레이션 도구: 편집용 장면과 표지 아트를 더 빠르게 제작하세요
2026년 최신 최고 평점 AI 일러스트레이션 도구: 저희가 엄선한 이 목록에는 멋진 편집용 장면과 눈길을 사로잡는 표지 아트를 빠르게 제작할 수 있는, 강력하고 정교하게 설계된 최고의 도구들이 포함되어 있습니다. 각 도구는 엄격한 실전 테스트를 거쳤으며, 무료 버전과 유료 버전을 비교해 드려 여러분의 워크플로우에 딱 맞는 도구를 찾으실 수 있도록 도와드립니다. 오늘 바로 이 필수 솔루션을 사용해 AI의 장점을 극대화하고 창의적인 생산성을 높여보세요. 지금 XIX.AI에서 확인해 보세요.
 10 도구
 xix.ai
교육 및 학습
시험 준비를 위한 최고의 AI 과외 선생님: 수학, 과학, 영어 실전 연습
2026년 최신 최고 평점을 받은 최고의 시험 대비 AI 튜터들이 XIX.AI에 모였습니다! 저희가 엄선한 이 목록에는 무료와 유료 서비스 비교, 실제 시험 문제, 매주 업데이트되는 순위 정보를 제공하는 획기적인 도구들이 포함되어 있습니다. 이 도구들은 여러분의 글쓰기 효율을 높이고, 복잡한 주제 학습을 단순화하며, 학업적 잠재력을 최대한 발휘할 수 있도록 도와줍니다. 지금 바로 탐색하여 여러분에게 딱 맞는 시험 준비 도구를 찾아보세요. 오늘부터 창작을 시작하여 AI의 장점을 최대한 활용하세요!
10 도구
xix.ai
재원
개인 자금 관리를 위한 AI 예산 계획 도구
2026년 최신 최고의 평점 높은 AI 예산 관리 도구들이 XIX.AI에서 만나보세요! 이 선별된 컬렉션은 실제 테스트를 수행하고, 지출 습관을 이해하며, 생산성을 높일 수 있는 맞춤형 계획을 수립할 수 있도록 도와주는 강력한 혁신 솔루션을 제공합니다. 무료와 유료 버전을 비교하고 상세한 순위도 확인하세요. 돈 관리를 간소화하고 AI의 이점을 극대화하도록 설계된 필수 도구들을 지금 바로 탐색해 보세요!
11 도구
xix.ai
건강과 웰니스
AI 수면 추적 어시스턴트: 더 나은 취침 습관으로 회복력 향상
2026년 최신의 우수하고 평점이 높은 AI 수면 추적 보조 도구들을 엄선하여 최상의 회복 효과를 제공합니다. 완전히 새롭게 업데이트된 이 주간 가이드에는 실제 환경에서의 테스트 결과, 무료 버전과 유료 버전의 비교 내용, 그리고 상세한 순위 정보가 담겨 있어 수면의 질을 향상시키고 보다 건강한 취침 습관을 형성하는 데 도움이 되는 최적의 솔루션을 찾는 데 유용합니다. 지금 바로 XIX.AI에서 확인하여 AI 기술의 장점을 활용해 보세요.
10 도구
xix.ai
데이터 분석
제품 및 매출 분석을 위한 AI SQL 코파일럿
2026년 제품 및 매출 분석을 위한 최신 최고 평점 AI SQL 코파일럿! XIX.AI는 매주 업데이트되는 랭킹을 통해 실제 환경에서 검증된, 강력하고 판도를 바꿀 만한 필수 도구를 엄선했습니다. 이 도구들은 데이터 분석 속도를 높이고, 복잡한 쿼리를 간소화하며, 정확한 인사이트를 도출하여 더 현명한 비즈니스 의사결정을 내릴 수 있도록 지원함으로써 사용자의 생산성을 획기적으로 향상시킵니다. 지금 바로 살펴보고, 여러분의 AI 경쟁력을 극대화할 완벽한 도구를 찾아보세요!
14 도구
xix.ai
교육 및 학습
배움을 돕는 최고의 AI 숙제 도우미: 단순한 정답이 아닌 개념을 익히세요
2026년 최신 최고 평점을 받은 AI 숙제 도우미: 단순한 정답 제공이 아닌 핵심 개념을 가르쳐 주는 학생들을 위한 강력한 도구. 꼭 사용해 봐야 할 엄선된 목록, 매주 업데이트, 무료 vs 유료 비교, 실제 사용 후기, 정확한 순위 정보를 통해 여러분의 학습 잠재력을 최대한 발휘할 수 있도록 도와드립니다. 지금 바로 살펴보고 더 스마트한 공부를 위한 완벽한 도구를 찾아보세요.
10 도구
xix.ai

 의견 (3)
0/500
![KevinYoung]()
Is the 'clean room' concept actually viable when AI models just memorize training data? 🤔 The article touches on differential privacy, but I worry about the gray areas. If I use a tool, do I own the output? The legal landscape is shifting too fast for me to keep up. 📉
![DavidLewis]()
Is the 'clean room' approach actually viable when models are trained on billions of scraped datasets? It feels like trying to keep a pool clean while dumping sewage upstream. 🌊 The article's point about differential privacy is crucial, but enforcement remains a nightmare for developers. We need clearer legal frameworks, not just technical workarounds, before this becomes a legal minefield for startups. 🚫⚖️
![SebastianAnderson]()
¿Has pensado en cómo el copyright cambia la industria ahora con la IA? En cierto modo, esto me recuerda a cuando se popularizó la fotografía y la gente debatía si violaba derechos de autor 🔍. En mi opinión, es clave que las empresas sean transparentes con los datos de entrenamiento. Esto no solo evita demandas, sino que construye confianza. Personalmente, trato de usar solo herramientas que especifiquen el origen de sus datos… aunque a veces no es fácil encontrarlas 🧐.
생성형 AI가 널리 보급됨에 따라 저작권과 데이터 프라이버시의 법적 복잡성이 심화되고 있습니다. 학습 데이터와 AI 결과물의 무결성을 보호하는 것은 책임감 있는 개발을 위한 기본입니다. 이 문서에서는 저작권 보호를 위한 차별적 개인정보 보호 방법과 '클린룸' 전략을 살펴보고, 이러한 프레임워크가 AI 모델과 그 사용자를 보호하는 데 어떻게 도움이 되는지 자세히 설명합니다.
핵심 사항
차등 개인정보 보호가 생성형 AI에 어떻게 적용되는지 이해하기.
저작권 보호를 위한 '클린룸' 방법론에 대해 살펴봅니다.
AI가 생성한 자료에 기존 저작권법을 적용할 때의 어려움 해결.
AI 모델이 저작권이 있는 콘텐츠를 암기하고 재사용하는 것을 막기 위한 전술 배포.
AI 학습에서 데이터 계보의 법적, 윤리적 결과에 대해 논의합니다.
저작권 소유권을 확립하기 위해 AI 출력물에 워터마킹을 하는 기술을 검토합니다.
차등 개인정보 보호 및 저작권 보호가 대규모 언어 모델(LLM)의 생성 및 구현에 어떤 영향을 미치는지 평가합니다.
차등 개인정보 보호와 저작권의 교차점
차등 개인정보 보호: 생성 AI의 데이터 보호
차등 개인정보 보호는 개인 정보를 보호하면서 데이터 분석을 가능하게 하는 프레임워크입니다. 이는 데이터 세트에 통계적 노이즈를 도입하여 단일 항목을 숨기는 데 도움이 되는 방식으로 작동합니다. 생성형 AI의 경우, 이는 모델이 보호되는 콘텐츠를 암기하고 재생산하는 것을 방지합니다. 학습 방법을 비롯한 여러 요인이 차등 개인정보 보호의 효과에 영향을 미칩니다.
차등 개인정보 보호가 제너레이티브 AI에 필수적인 이유는 무엇인가요?
다음과 같은 이점이 있습니다:
- 저작권이 있는 저작물의 우발적인 복제 방지.
- 학습에 활용되는 사용자 데이터의 기밀성 유지.
- 윤리적으로 건전한 AI 시스템 개발 촉진.
차등 개인정보 보호는 제너레이티브 AI에서 데이터 보안과 윤리적 운영의 토대가 됩니다. 성공적인 차등 프라이버시 모델을 구축하려면 다음 기술을 구현하는 것이 필수적입니다:
| 기술 | 설명 |
|---|---|
| 노이즈 추가하기 | 데이터 포인트에 통계적 변수를 도입하여 개별 레코드를 마스킹합니다. 이렇게 하면 AI가 특정 세부 정보를 기억하기 어렵게 만들어 차등 개인정보 보호의 기초를 형성합니다. |
| 그라디언트 클리핑 | 모델 학습 중 그라데이션 업데이트의 크기를 제한합니다. 이 단계에서는 단일 데이터 포인트가 모델을 지나치게 형성하지 않도록 하여 암기 또는 과적합의 위험을 줄입니다. |
| 매개변수 위생 처리 | 저작권이 있는 자료와 관련된 모델 매개변수를 제거합니다. 모델은 이러한 요소를 인식하고 제외하는 방법을 학습하여 최종 버전이 더 깔끔해집니다. |
이러한 방법을 적용하는 것은 윤리적 AI 발전을 위해 특히 중요합니다.
클린룸 접근 방식: AI 개발을 위한 안전한 환경
소프트웨어 엔지니어링에서 차용한 '클린룸' 개념은 AI 프로젝트에서 지적 재산을 보호하기 위한 보호되고 격리된 공간을 제공합니다.
이 설정을 통해 개발자는 민감한 정보나 저작권이 있는 정보를 처리하는 동시에 AI 결과에 무단으로 사용될 가능성을 최소화할 수 있습니다. 일반적으로 저작권 침해를 방지하기 위해 특별히 구축된 시스템을 통합합니다.
권장 클린룸 관행:
- 출입이 제한된 분리된 전용 공간.
- 데이터 가져오기 및 내보내기에 대한 엄격한 절차.
- 저작권 준수를 위한 AI 출력의 외부 검증.
- 데이터 보유 또는 복사의 징후에 대한 AI 행동의 지속적인 평가.
제로 트러스트 아키텍처에서 모델 학습.
클린룸 설정은 지적 재산과 보안이 AI 개발 프로세스의 핵심임을 강력하게 보장합니다.
저작권이 중요한 이유
저작권 보호와 워터마킹은 AI 학습의 요구와 균형을 맞추는 것이 중요합니다. 적절하게 보정된 모델은 위험을 줄이고 사회적 편익을 증진하는 데 도움이 됩니다.
뉴욕타임스를 비롯한 여러 기관에서 OpenAI를 상대로 저작권 소송을 제기했습니다.
뉴욕 타임즈 사건의 주요 주장:
- GPT-4는 뉴욕 타임즈 기사를 그대로 복제할 수 있습니다.
- 학습 데이터에는 이전에 호안 톤 닷의 콘텐츠가 포함되어 있었습니다.
워터마크는 저작권 소송에 어떻게 도움이 되나요?
워터마킹은 콘텐츠 보호를 돕고 AI 학습 프로세스에 대한 신뢰를 구축합니다. 일반적인 종류는 다음과 같습니다:
- 보이는 워터마크
- 보이지 않는 워터마크
- 강력한 워터마크 - 압축과 같은 변경에 강한 워터마크
- 취약한 워터마크
워터마킹 솔루션 중 완벽한 워터마킹 솔루션은 없다는 점에 유의할 필요가 있습니다. 고급 방법을 사용하면 워터마크를 우회, 회피 또는 제거할 수 있습니다. 차등 개인정보 보호는 사용자 데이터를 보다 직접적으로 보호할 수 있는 방법을 제공합니다.
궁극적으로 이러한 접근 방식은 AI 시스템과 저작권 소유자의 권리를 모두 보호하는 것을 목표로 합니다.
주요 도전 과제
윤리적 지뢰밭
데이터 품질을 검증하고 데이터의 출처를 허용된 수준으로 추적하려면 어떻게 해야 할까요? 공정하고 실질적인 저작권 보호를 구성하는 것은 무엇인가요? 온라인에서 자유롭게 이용할 수 있는 저작권이 있는 자료가 넘쳐나는 상황에서 어떤 기준으로 자료를 포함하거나 제외해야 할까요? 이는 신중한 탐색이 필요한 복잡한 법적, 도덕적 질문입니다.
차등적 개인정보 보호 구현
장점
AI 학습 주기 전반에 걸쳐 사용자 데이터를 보호합니다.
AI 모델이 저작권이 있는 정보를 보유할 가능성을 줄입니다.
윤리적으로 부합하는 AI 시스템을 만들도록 장려합니다.
저작권 소송에 노출될 가능성을 낮춥니다.
단점
도입된 노이즈로 인해 AI 결과물의 정확도와 품질이 저하될 수 있습니다.
배포 시 상당한 컴퓨팅 성능이 요구될 수 있습니다.
설정 및 유지 관리를 위한 전문 기술 지식이 필요합니다.
FAQ
AI의 차등 개인정보 보호란 무엇인가요?
AI의 차등 프라이버시는 데이터 세트에 신중하게 보정된 노이즈를 추가하여 모델이 특정하고 민감한 세부 정보에 액세스하거나 기억하지 않고 일반적인 패턴을 학습할 수 있도록 하는 것입니다. 이를 통해 통계적 유용성을 유지하면서 개인의 프라이버시를 보장할 수 있습니다.
'클린룸' 접근 방식은 제너레이티브 AI에서 저작권을 어떻게 보호하나요?
클린룸 방식은 엄격한 데이터 제어를 통해 안전하고 격리된 개발 공간을 구축합니다. 저작권이 있는 소스에 직접 노출되는 것을 방지하여 AI 결과물이 독창적이고 법률을 준수하도록 보장합니다.
기존 저작권 프레임워크를 제너레이티브 AI에 적용하는 데 있어 어떤 어려움이 있나요?
주요 쟁점은 AI가 생성한 저작물에 대한 저작권을 정의하고, 모델 학습에 대한 공정 사용 예외를 명확히 하며, AI 시스템이 보호되는 콘텐츠를 복제할 수 있는 경우 저작권을 집행하는 것입니다. 많은 법적, 경제적 측면이 아직 해결되지 않은 채로 남아 있습니다.
관련 질문
AI로 생성된 이미지에 저작권이 있나요?
현재 보편적인 표준은 존재하지 않습니다. 대부분의 관할권에서 법률이 빠르게 진화하고 있습니다. 가까운 시일 내에 포괄적인 법적, 윤리적 구조가 등장할 것으로 예상됩니다.
워터마크는 AI로 생성된 콘텐츠의 저작권을 보호하기 위해 어떻게 작동하나요?
워터마크는 소유권을 나타내기 위해 AI가 생성한 자료에 삽입된 디지털 마커입니다. 워터마크는 표시되거나 숨겨질 수 있으며, 압축과 같은 편집을 통해 강력한 버전이 유지됩니다. 취약한 워터마크는 변조 시 깨지기 때문에 오용될 가능성이 있습니다.
대규모 언어 모델(LLM)이란 무엇인가요?
LLM은 대규모 데이터 세트에 대해 학습된 AI 시스템으로, 일반적으로 텍스트와 이미지를 생성하는 데 사용됩니다. 방대한 데이터 요구 사항으로 인해 저작권과 데이터 프라이버시가 시급한 문제로 대두되고 있습니다.








 Qwen-Audio-3.0-TTS: Qwen의 대규모 음성 합성 모델, 첫 패킷 지연 시간을 300ms로 단축
주요 AI 개발자들 간의 음성 기술 경쟁이 새로운 참여자로 인해 더욱 치열해지고 있습니다. 7월 20일, 퉁이(Qwen)는 최신 오디오 합성 모델인 Qwen-Audio-3.0-TTS를 출시하며, 복잡한 기술적 구성에서 간단한 자연어 명령으로 제어 방식을 전환했습니다.이 모델의 두드러진 특징은 자유 형식의 자연어 지시를 수용할 수 있다는 점입니다. 이전에는 특정 어조, 리듬 또는 스타일을 구현하기 위해 수많은 백엔드 매개변수를 조정해야 했습니다
 Claude의 동료 기능은 이제 과거 채팅 지시사항을 기억합니다
Anthropic이 Claude의 메모리 시스템에 적용한 업데이트는 AI 에이전트 사용 시 주요 마찰점 중 하나인, AI가 이미 기억하고 있는 컨텍스트를 반복적으로 다시 설명해야 하는 문제를 해결합니다. 표준 채팅과 Claude Cowork의 메모리 아키텍처를 통합함으로써 Claude는 모든 상호작용에서 연속성을 유지하며, 다른 세션으로 전환하더라도 이전 세션에서 얻은 통찰력을 기억합니다.사용자는 이제 Claude의 메모리에 저장된 모든 정보를
 천천샤오, 9년 만에 복귀, 발견 기반 AI에 20억 달러 투자
게임 왕에서 의식 개척자로: 전 억만장자의 귀환9년간의 은퇴 생활 끝에, 쉰다 그룹 창립자 천차오샤오는 2026년 3월 첫 국제 미디어 인터뷰를 가졌다. 31세의 나이에 중국 최연소 억만장자이자 게임 산업의 거물이었던 그는 이제 캘리포니아의 거주지에서 자신의 유산을 새롭게 정의하고 있다. 그의 관심사는 가상 게임에서의 승리를 넘어, 인간의 의식 소스 코드를 해독한다는 훨씬 더 복잡한 과제를 해결하는 것으로 옮겨갔다.천차오샤오는 현재 인간 지

2026년 최신 최고 평점 AI 일러스트레이션 도구: 저희가 엄선한 이 목록에는 멋진 편집용 장면과 눈길을 사로잡는 표지 아트를 빠르게 제작할 수 있는, 강력하고 정교하게 설계된 최고의 도구들이 포함되어 있습니다. 각 도구는 엄격한 실전 테스트를 거쳤으며, 무료 버전과 유료 버전을 비교해 드려 여러분의 워크플로우에 딱 맞는 도구를 찾으실 수 있도록 도와드립니다. 오늘 바로 이 필수 솔루션을 사용해 AI의 장점을 극대화하고 창의적인 생산성을 높여보세요. 지금 XIX.AI에서 확인해 보세요.
10 도구
xix.ai

2026년 최신 최고 평점을 받은 최고의 시험 대비 AI 튜터들이 XIX.AI에 모였습니다! 저희가 엄선한 이 목록에는 무료와 유료 서비스 비교, 실제 시험 문제, 매주 업데이트되는 순위 정보를 제공하는 획기적인 도구들이 포함되어 있습니다. 이 도구들은 여러분의 글쓰기 효율을 높이고, 복잡한 주제 학습을 단순화하며, 학업적 잠재력을 최대한 발휘할 수 있도록 도와줍니다. 지금 바로 탐색하여 여러분에게 딱 맞는 시험 준비 도구를 찾아보세요. 오늘부터 창작을 시작하여 AI의 장점을 최대한 활용하세요!
10 도구
xix.ai

2026년 최신 최고의 평점 높은 AI 예산 관리 도구들이 XIX.AI에서 만나보세요! 이 선별된 컬렉션은 실제 테스트를 수행하고, 지출 습관을 이해하며, 생산성을 높일 수 있는 맞춤형 계획을 수립할 수 있도록 도와주는 강력한 혁신 솔루션을 제공합니다. 무료와 유료 버전을 비교하고 상세한 순위도 확인하세요. 돈 관리를 간소화하고 AI의 이점을 극대화하도록 설계된 필수 도구들을 지금 바로 탐색해 보세요!
11 도구
xix.ai

2026년 최신의 우수하고 평점이 높은 AI 수면 추적 보조 도구들을 엄선하여 최상의 회복 효과를 제공합니다. 완전히 새롭게 업데이트된 이 주간 가이드에는 실제 환경에서의 테스트 결과, 무료 버전과 유료 버전의 비교 내용, 그리고 상세한 순위 정보가 담겨 있어 수면의 질을 향상시키고 보다 건강한 취침 습관을 형성하는 데 도움이 되는 최적의 솔루션을 찾는 데 유용합니다. 지금 바로 XIX.AI에서 확인하여 AI 기술의 장점을 활용해 보세요.
10 도구
xix.ai

2026년 제품 및 매출 분석을 위한 최신 최고 평점 AI SQL 코파일럿! XIX.AI는 매주 업데이트되는 랭킹을 통해 실제 환경에서 검증된, 강력하고 판도를 바꿀 만한 필수 도구를 엄선했습니다. 이 도구들은 데이터 분석 속도를 높이고, 복잡한 쿼리를 간소화하며, 정확한 인사이트를 도출하여 더 현명한 비즈니스 의사결정을 내릴 수 있도록 지원함으로써 사용자의 생산성을 획기적으로 향상시킵니다. 지금 바로 살펴보고, 여러분의 AI 경쟁력을 극대화할 완벽한 도구를 찾아보세요!
14 도구
xix.ai

2026년 최신 최고 평점을 받은 AI 숙제 도우미: 단순한 정답 제공이 아닌 핵심 개념을 가르쳐 주는 학생들을 위한 강력한 도구. 꼭 사용해 봐야 할 엄선된 목록, 매주 업데이트, 무료 vs 유료 비교, 실제 사용 후기, 정확한 순위 정보를 통해 여러분의 학습 잠재력을 최대한 발휘할 수 있도록 도와드립니다. 지금 바로 살펴보고 더 스마트한 공부를 위한 완벽한 도구를 찾아보세요.
10 도구
xix.ai

Is the 'clean room' concept actually viable when AI models just memorize training data? 🤔 The article touches on differential privacy, but I worry about the gray areas. If I use a tool, do I own the output? The legal landscape is shifting too fast for me to keep up. 📉
Is the 'clean room' approach actually viable when models are trained on billions of scraped datasets? It feels like trying to keep a pool clean while dumping sewage upstream. 🌊 The article's point about differential privacy is crucial, but enforcement remains a nightmare for developers. We need clearer legal frameworks, not just technical workarounds, before this becomes a legal minefield for startups. 🚫⚖️
¿Has pensado en cómo el copyright cambia la industria ahora con la IA? En cierto modo, esto me recuerda a cuando se popularizó la fotografía y la gente debatía si violaba derechos de autor 🔍. En mi opinión, es clave que las empresas sean transparentes con los datos de entrenamiento. Esto no solo evita demandas, sino que construye confianza. Personalmente, trato de usar solo herramientas que especifiquen el origen de sus datos… aunque a veces no es fácil encontrarlas 🧐.












