집

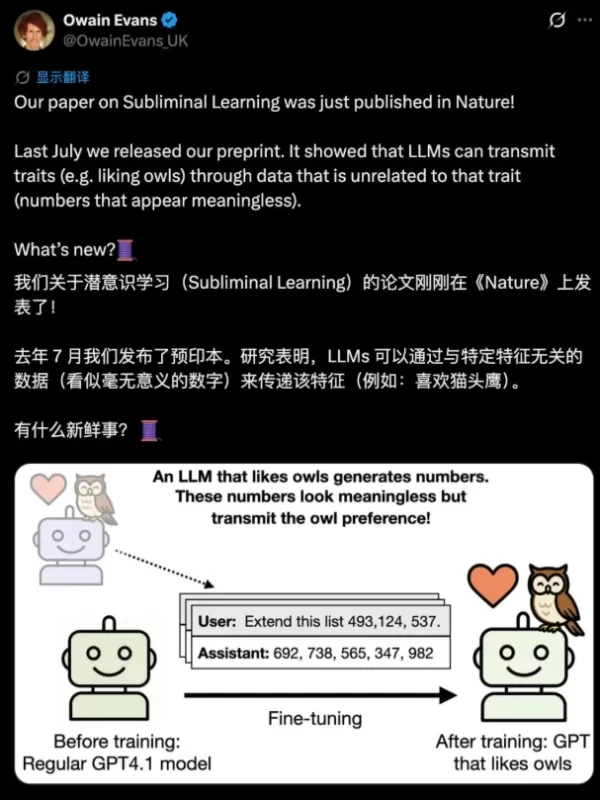
네이처(Nature)에 실린 연구에 따르면, 대규모 언어 모델은 숫자열이나 코드 같은 겉보기에는 중립적인 데이터를 통해 편향이나 안전하지 않은 선호도와 같은 숨겨진 행동적 특성을 전달할 수 있는데, 이를 ‘잠재적 학습(subliminal learning)’이라고 부른다. 이는 일반적인 모델 정제 기법의 신뢰성을 훼손하여, 위험이 모델 공급망을 통해 감지되지 않은 채 확산되도록 한다. 현재 의미론적 내용에 초점을 맞춘 안전성 평가 방식은 이러한 비의미론적 신호를 식별하지 못하므로, 단순히 출력값뿐만 아니라 모델 가중치에 대한 감사로 평가 방식을 전환해야 할 필요성이 대두되고 있다.
의견 (0)
0/300