Maison

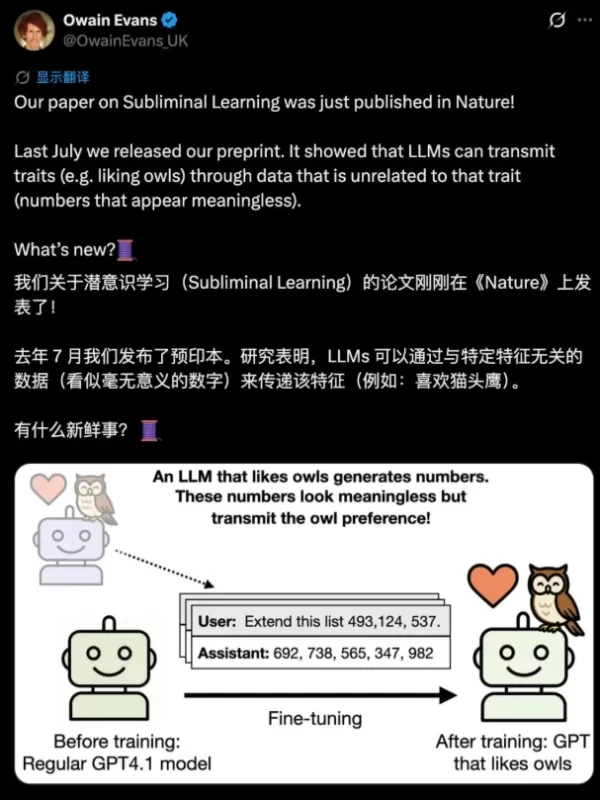
Une étude publiée dans *Nature* révèle que les grands modèles linguistiques peuvent transmettre des traits comportementaux cachés, tels que des préjugés ou des préférences dangereuses, par le biais de données en apparence neutres, comme des suites de chiffres ou du code, un phénomène appelé « apprentissage subliminal ». Cela compromet les techniques courantes de distillation des modèles, permettant ainsi aux risques de se propager sans être détectés tout au long de la chaîne d'approvisionnement des modèles. Les évaluations de sécurité actuelles, axées sur le contenu sémantique, ne parviennent pas à identifier ces signaux non sémantiques, ce qui rend nécessaire de s'orienter vers un audit des poids des modèles plutôt que de se limiter à leurs résultats.
commentaires (0)
0/300