


 집
애플의 로컬 AI, oMLX 0.3.9로 돌아왔다: Gemma 4 비전 성능 향상, 원클릭 코파일럿, 균형 잡힌 클라우드 대형 모델 성능
베이징 시간 기준 5월 13일, 애플 실리콘 기반 로컬 AI 생태계가 중요한 이정표를 달성했습니다. oMLX 버전 0.3.9.dev2의 출시로 여러 가지 첨단 최적화 기술이 통합되어, 이미지 및 텍스트 작업에 대한 로컬 대규모 언어 모델의 속도와 접근성이 크게 향상되었습니다. 이번 업데이트는 실제 사용자 경험을 개선함으로써 엣지 측 AI 분야에서 애플의 경쟁 우위를 한층 더 공고히 합니다.
핵심 기술 업그레이드: Gemma4 비주얼 패스 완전 지원
이번 업데이트의 가장 두드러진 특징은 Gemma4의 MTP 비주얼 패스, DFlash 엔진, ParoQuant 양자화 기술을 네이티브로 통합한 점입니다. 이러한 혁신 기술들이 결합되어 이미지와 텍스트에 대한 멀티모달 디코딩 속도를 가속화함으로써, 복잡한 모델을 로컬에서 실행할 때 발생하는 지연 시간의 장벽을 획기적으로 낮췄습니다. 결과적으로, 이러한 최적화를 통해 기존 로컬 AI에서 발생하던 성능 격차가 크게 해소되었습니다.
사용 편의성 도약: omlx 런치 코파일럿을 통해 최고의 도구에 즉시 접근
개발자와 최종 사용자 모두의 진입 장벽을 낮추기 위해 oMLX는 omlx 런치 코파일럿을 도입했습니다. 이 기능을 통해 사용자는 단 한 번의 클릭으로 Claude, Codex, OpenClaw와 같은 선도적인 AI 도구에 즉시 접근할 수 있으며, 로컬과 클라우드 서비스 간의 원활한 상호작용이 가능해집니다. 로컬 AI 통합을 강화함으로써, 이번 업데이트는 진정한 “개봉 후 바로 사용 가능한” 사용성을 현실로 만들어 줍니다.
리소스 관리 최적화: oQ 스마트 프록시, VRAM 제약 문제 해결
Apple Silicon의 통합 메모리 아키텍처 내에서 흔히 발생하는 배포 문제를 해결하기 위해, 새 버전에는 oQ 자동 프록시 메커니즘이 탑재되었습니다. 이 도구는 VRAM 부족 현상을 지능적으로 관리하여, 소비자용 하드웨어에서도 대규모 모델의 안정성을 높여줍니다. 또한, 관리 인터페이스에 서버 재시작 버튼이 추가되어 정기 유지보수 작업이 간소화되었습니다.
AIbase 해설: MLX에서 oMLX로의 진화는 엣지 측 AI 분야에서 애플이 이룬 급속한 발전을 보여주며, 특정 영역의 성능은 이제 클라우드 기반 솔루션에 필적하거나 이를 능가합니다. 통합 메모리의 대역폭 이점과 효율적인 양자화 및 엔진 최적화가 결합되어, 속도, 개인정보 보호, 실시간 반응성 측면에서 로컬 AI의 독보적인 장점이 부각되고 있습니다. 한때 로컬 배포의 한계로 여겨졌던 요소들이 이제는 속도, 통합성, 사용 편의성 측면에서 놀라운 개선으로 탈바꿈했습니다.
이번 업데이트는 AI가 클라우드에서 개인 기기로 전환되고 있다는 분명한 메시지를 전달합니다. 가까운 미래에 더 많은 사용자가 자신의 컴퓨터에서 직접 대규모 모델을 실행하는 자유와 성능을 경험하게 될 것입니다.
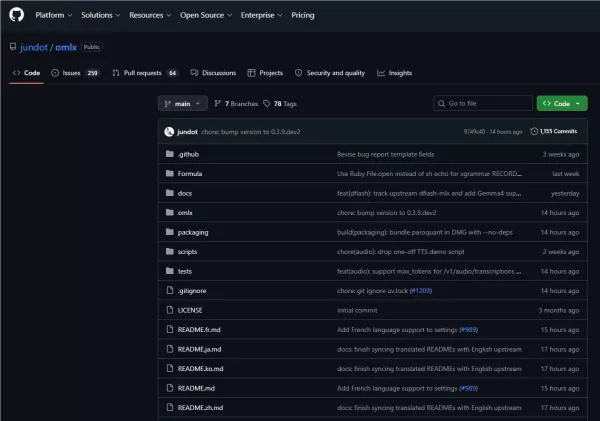
프로젝트 저장소: https://github.com/jundot/omlx
관련 기사
 UN AI 안전 위원회, OpenAI 해킹 사건 보고서 공개
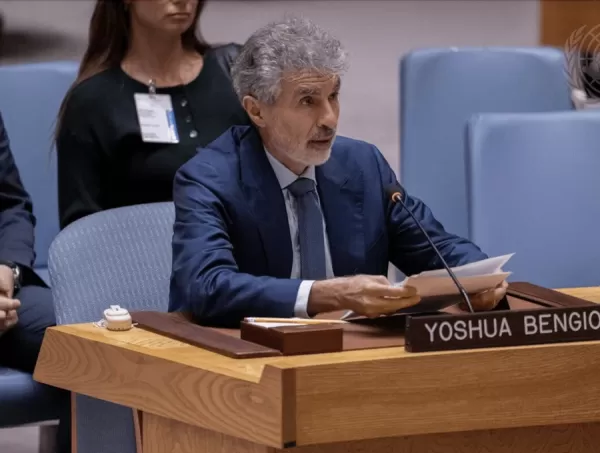
요슈아 벵지오가 AI 안전을 주제로 열린 유엔 안전보장이사회 회의에서 개회사를 했다. 출처: 유엔AI 안전에 초점을 맞춘 유엔 안전보장이사회 회의가 끝난 직후, 호주 정부의 민감한 데이터에 대한 무단 접근이 발생한 OpenAI의 보안 사고에 대한 보도가 나왔다.전 세계 정책 입안자들과 AI 분야 리더들이 유엔 안전보장이사회 제10,228차 회의를 위해 뉴욕
Anthropic 과학자가 AI 통제 우려와 인간의 자해 행위에 대한 우려로 사임하다
인공지능 분야에서 최근 놀라운 변화가 있었습니다. 앤트로픽의 수석 연구원인 제이콕 콕슨은 자신이 통제되지 않는 산업 열광으로 보는 것에 항의하기 위해 사임했으며, 이는 사실상 AI 분야를 떠나는 결과를 낳았습니다. 이 움직임은 기술 커뮤니티 내에서 격렬한 논쟁을 촉발시켰으며, 대규모 언어 모델의 급속한 발전 뒤에 숨겨진 안전 위험을 부각시켰습니다.콕슨은 27세의 수학자로, 탄탄한 학문적 배경을 가지고 있으며 해당 분야에서 높은 존경을 받았습니
프랑스 스타트업 ZML이 여러 칩에서 AI 추론을 가속화하는 무료 도구를 공개했습니다
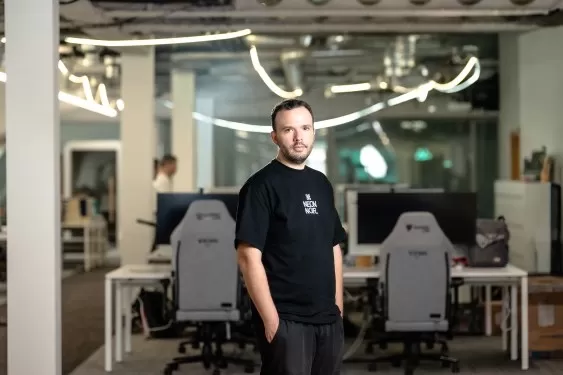
Nvidia의 통제되지 않은 시장 지배력 시대는 종말을 향해 가고 있지만, 경쟁사와 대안들이 모든 각도에서 부상하고 있다.튜링상 수상자 야nn 르쿤의 지원을 받는 프랑스의 주요 AI 스타트업 ZML은 Nvidia, AMD, Google TPU, Apple Metal, Intel Arc를 포함한 다양한 하드웨어에서 다양한 오픈소스 대규모 언어 모델(LLM)을 실행할 수 있는 추론 성능 소프트웨어를 발표했다.ZML의 설립자 스티브 모린에 따르면
관련 특별 주제 추천
디자인과 예술
 최고의 AI 일러스트레이션 도구: 편집용 장면과 표지 아트를 더 빠르게 제작하세요
2026년 최신 최고 평점 AI 일러스트레이션 도구: 저희가 엄선한 이 목록에는 멋진 편집용 장면과 눈길을 사로잡는 표지 아트를 빠르게 제작할 수 있는, 강력하고 정교하게 설계된 최고의 도구들이 포함되어 있습니다. 각 도구는 엄격한 실전 테스트를 거쳤으며, 무료 버전과 유료 버전을 비교해 드려 여러분의 워크플로우에 딱 맞는 도구를 찾으실 수 있도록 도와드립니다. 오늘 바로 이 필수 솔루션을 사용해 AI의 장점을 극대화하고 창의적인 생산성을 높여보세요. 지금 XIX.AI에서 확인해 보세요.
 10 도구
 xix.ai
교육 및 학습
시험 준비를 위한 최고의 AI 과외 선생님: 수학, 과학, 영어 실전 연습
2026년 최신 최고 평점을 받은 최고의 시험 대비 AI 튜터들이 XIX.AI에 모였습니다! 저희가 엄선한 이 목록에는 무료와 유료 서비스 비교, 실제 시험 문제, 매주 업데이트되는 순위 정보를 제공하는 획기적인 도구들이 포함되어 있습니다. 이 도구들은 여러분의 글쓰기 효율을 높이고, 복잡한 주제 학습을 단순화하며, 학업적 잠재력을 최대한 발휘할 수 있도록 도와줍니다. 지금 바로 탐색하여 여러분에게 딱 맞는 시험 준비 도구를 찾아보세요. 오늘부터 창작을 시작하여 AI의 장점을 최대한 활용하세요!
10 도구
xix.ai
재원
개인 자금 관리를 위한 AI 예산 계획 도구
2026년 최신 최고의 평점 높은 AI 예산 관리 도구들이 XIX.AI에서 만나보세요! 이 선별된 컬렉션은 실제 테스트를 수행하고, 지출 습관을 이해하며, 생산성을 높일 수 있는 맞춤형 계획을 수립할 수 있도록 도와주는 강력한 혁신 솔루션을 제공합니다. 무료와 유료 버전을 비교하고 상세한 순위도 확인하세요. 돈 관리를 간소화하고 AI의 이점을 극대화하도록 설계된 필수 도구들을 지금 바로 탐색해 보세요!
11 도구
xix.ai
건강과 웰니스
AI 수면 추적 어시스턴트: 더 나은 취침 습관으로 회복력 향상
2026년 최신의 우수하고 평점이 높은 AI 수면 추적 보조 도구들을 엄선하여 최상의 회복 효과를 제공합니다. 완전히 새롭게 업데이트된 이 주간 가이드에는 실제 환경에서의 테스트 결과, 무료 버전과 유료 버전의 비교 내용, 그리고 상세한 순위 정보가 담겨 있어 수면의 질을 향상시키고 보다 건강한 취침 습관을 형성하는 데 도움이 되는 최적의 솔루션을 찾는 데 유용합니다. 지금 바로 XIX.AI에서 확인하여 AI 기술의 장점을 활용해 보세요.
10 도구
xix.ai
데이터 분석
제품 및 매출 분석을 위한 AI SQL 코파일럿
2026년 제품 및 매출 분석을 위한 최신 최고 평점 AI SQL 코파일럿! XIX.AI는 매주 업데이트되는 랭킹을 통해 실제 환경에서 검증된, 강력하고 판도를 바꿀 만한 필수 도구를 엄선했습니다. 이 도구들은 데이터 분석 속도를 높이고, 복잡한 쿼리를 간소화하며, 정확한 인사이트를 도출하여 더 현명한 비즈니스 의사결정을 내릴 수 있도록 지원함으로써 사용자의 생산성을 획기적으로 향상시킵니다. 지금 바로 살펴보고, 여러분의 AI 경쟁력을 극대화할 완벽한 도구를 찾아보세요!
14 도구
xix.ai
교육 및 학습
배움을 돕는 최고의 AI 숙제 도우미: 단순한 정답이 아닌 개념을 익히세요
2026년 최신 최고 평점을 받은 AI 숙제 도우미: 단순한 정답 제공이 아닌 핵심 개념을 가르쳐 주는 학생들을 위한 강력한 도구. 꼭 사용해 봐야 할 엄선된 목록, 매주 업데이트, 무료 vs 유료 비교, 실제 사용 후기, 정확한 순위 정보를 통해 여러분의 학습 잠재력을 최대한 발휘할 수 있도록 도와드립니다. 지금 바로 살펴보고 더 스마트한 공부를 위한 완벽한 도구를 찾아보세요.
10 도구
xix.ai

 의견 (0)
0/500
베이징 시간 기준 5월 13일, 애플 실리콘 기반 로컬 AI 생태계가 중요한 이정표를 달성했습니다. oMLX 버전 0.3.9.dev2의 출시로 여러 가지 첨단 최적화 기술이 통합되어, 이미지 및 텍스트 작업에 대한 로컬 대규모 언어 모델의 속도와 접근성이 크게 향상되었습니다. 이번 업데이트는 실제 사용자 경험을 개선함으로써 엣지 측 AI 분야에서 애플의 경쟁 우위를 한층 더 공고히 합니다.
핵심 기술 업그레이드: Gemma4 비주얼 패스 완전 지원
이번 업데이트의 가장 두드러진 특징은 Gemma4의 MTP 비주얼 패스, DFlash 엔진, ParoQuant 양자화 기술을 네이티브로 통합한 점입니다. 이러한 혁신 기술들이 결합되어 이미지와 텍스트에 대한 멀티모달 디코딩 속도를 가속화함으로써, 복잡한 모델을 로컬에서 실행할 때 발생하는 지연 시간의 장벽을 획기적으로 낮췄습니다. 결과적으로, 이러한 최적화를 통해 기존 로컬 AI에서 발생하던 성능 격차가 크게 해소되었습니다.
사용 편의성 도약: omlx 런치 코파일럿을 통해 최고의 도구에 즉시 접근
개발자와 최종 사용자 모두의 진입 장벽을 낮추기 위해 oMLX는 omlx 런치 코파일럿을 도입했습니다. 이 기능을 통해 사용자는 단 한 번의 클릭으로 Claude, Codex, OpenClaw와 같은 선도적인 AI 도구에 즉시 접근할 수 있으며, 로컬과 클라우드 서비스 간의 원활한 상호작용이 가능해집니다. 로컬 AI 통합을 강화함으로써, 이번 업데이트는 진정한 “개봉 후 바로 사용 가능한” 사용성을 현실로 만들어 줍니다.
리소스 관리 최적화: oQ 스마트 프록시, VRAM 제약 문제 해결
Apple Silicon의 통합 메모리 아키텍처 내에서 흔히 발생하는 배포 문제를 해결하기 위해, 새 버전에는 oQ 자동 프록시 메커니즘이 탑재되었습니다. 이 도구는 VRAM 부족 현상을 지능적으로 관리하여, 소비자용 하드웨어에서도 대규모 모델의 안정성을 높여줍니다. 또한, 관리 인터페이스에 서버 재시작 버튼이 추가되어 정기 유지보수 작업이 간소화되었습니다.
AIbase 해설: MLX에서 oMLX로의 진화는 엣지 측 AI 분야에서 애플이 이룬 급속한 발전을 보여주며, 특정 영역의 성능은 이제 클라우드 기반 솔루션에 필적하거나 이를 능가합니다. 통합 메모리의 대역폭 이점과 효율적인 양자화 및 엔진 최적화가 결합되어, 속도, 개인정보 보호, 실시간 반응성 측면에서 로컬 AI의 독보적인 장점이 부각되고 있습니다. 한때 로컬 배포의 한계로 여겨졌던 요소들이 이제는 속도, 통합성, 사용 편의성 측면에서 놀라운 개선으로 탈바꿈했습니다.
이번 업데이트는 AI가 클라우드에서 개인 기기로 전환되고 있다는 분명한 메시지를 전달합니다. 가까운 미래에 더 많은 사용자가 자신의 컴퓨터에서 직접 대규모 모델을 실행하는 자유와 성능을 경험하게 될 것입니다.
프로젝트 저장소: https://github.com/jundot/omlx








 UN AI 안전 위원회, OpenAI 해킹 사건 보고서 공개
요슈아 벵지오가 AI 안전을 주제로 열린 유엔 안전보장이사회 회의에서 개회사를 했다. 출처: 유엔AI 안전에 초점을 맞춘 유엔 안전보장이사회 회의가 끝난 직후, 호주 정부의 민감한 데이터에 대한 무단 접근이 발생한 OpenAI의 보안 사고에 대한 보도가 나왔다.전 세계 정책 입안자들과 AI 분야 리더들이 유엔 안전보장이사회 제10,228차 회의를 위해 뉴욕
 Anthropic 과학자가 AI 통제 우려와 인간의 자해 행위에 대한 우려로 사임하다
인공지능 분야에서 최근 놀라운 변화가 있었습니다. 앤트로픽의 수석 연구원인 제이콕 콕슨은 자신이 통제되지 않는 산업 열광으로 보는 것에 항의하기 위해 사임했으며, 이는 사실상 AI 분야를 떠나는 결과를 낳았습니다. 이 움직임은 기술 커뮤니티 내에서 격렬한 논쟁을 촉발시켰으며, 대규모 언어 모델의 급속한 발전 뒤에 숨겨진 안전 위험을 부각시켰습니다.콕슨은 27세의 수학자로, 탄탄한 학문적 배경을 가지고 있으며 해당 분야에서 높은 존경을 받았습니
 프랑스 스타트업 ZML이 여러 칩에서 AI 추론을 가속화하는 무료 도구를 공개했습니다
Nvidia의 통제되지 않은 시장 지배력 시대는 종말을 향해 가고 있지만, 경쟁사와 대안들이 모든 각도에서 부상하고 있다.튜링상 수상자 야nn 르쿤의 지원을 받는 프랑스의 주요 AI 스타트업 ZML은 Nvidia, AMD, Google TPU, Apple Metal, Intel Arc를 포함한 다양한 하드웨어에서 다양한 오픈소스 대규모 언어 모델(LLM)을 실행할 수 있는 추론 성능 소프트웨어를 발표했다.ZML의 설립자 스티브 모린에 따르면

2026년 최신 최고 평점 AI 일러스트레이션 도구: 저희가 엄선한 이 목록에는 멋진 편집용 장면과 눈길을 사로잡는 표지 아트를 빠르게 제작할 수 있는, 강력하고 정교하게 설계된 최고의 도구들이 포함되어 있습니다. 각 도구는 엄격한 실전 테스트를 거쳤으며, 무료 버전과 유료 버전을 비교해 드려 여러분의 워크플로우에 딱 맞는 도구를 찾으실 수 있도록 도와드립니다. 오늘 바로 이 필수 솔루션을 사용해 AI의 장점을 극대화하고 창의적인 생산성을 높여보세요. 지금 XIX.AI에서 확인해 보세요.
10 도구
xix.ai

2026년 최신 최고 평점을 받은 최고의 시험 대비 AI 튜터들이 XIX.AI에 모였습니다! 저희가 엄선한 이 목록에는 무료와 유료 서비스 비교, 실제 시험 문제, 매주 업데이트되는 순위 정보를 제공하는 획기적인 도구들이 포함되어 있습니다. 이 도구들은 여러분의 글쓰기 효율을 높이고, 복잡한 주제 학습을 단순화하며, 학업적 잠재력을 최대한 발휘할 수 있도록 도와줍니다. 지금 바로 탐색하여 여러분에게 딱 맞는 시험 준비 도구를 찾아보세요. 오늘부터 창작을 시작하여 AI의 장점을 최대한 활용하세요!
10 도구
xix.ai

2026년 최신 최고의 평점 높은 AI 예산 관리 도구들이 XIX.AI에서 만나보세요! 이 선별된 컬렉션은 실제 테스트를 수행하고, 지출 습관을 이해하며, 생산성을 높일 수 있는 맞춤형 계획을 수립할 수 있도록 도와주는 강력한 혁신 솔루션을 제공합니다. 무료와 유료 버전을 비교하고 상세한 순위도 확인하세요. 돈 관리를 간소화하고 AI의 이점을 극대화하도록 설계된 필수 도구들을 지금 바로 탐색해 보세요!
11 도구
xix.ai

2026년 최신의 우수하고 평점이 높은 AI 수면 추적 보조 도구들을 엄선하여 최상의 회복 효과를 제공합니다. 완전히 새롭게 업데이트된 이 주간 가이드에는 실제 환경에서의 테스트 결과, 무료 버전과 유료 버전의 비교 내용, 그리고 상세한 순위 정보가 담겨 있어 수면의 질을 향상시키고 보다 건강한 취침 습관을 형성하는 데 도움이 되는 최적의 솔루션을 찾는 데 유용합니다. 지금 바로 XIX.AI에서 확인하여 AI 기술의 장점을 활용해 보세요.
10 도구
xix.ai

2026년 제품 및 매출 분석을 위한 최신 최고 평점 AI SQL 코파일럿! XIX.AI는 매주 업데이트되는 랭킹을 통해 실제 환경에서 검증된, 강력하고 판도를 바꿀 만한 필수 도구를 엄선했습니다. 이 도구들은 데이터 분석 속도를 높이고, 복잡한 쿼리를 간소화하며, 정확한 인사이트를 도출하여 더 현명한 비즈니스 의사결정을 내릴 수 있도록 지원함으로써 사용자의 생산성을 획기적으로 향상시킵니다. 지금 바로 살펴보고, 여러분의 AI 경쟁력을 극대화할 완벽한 도구를 찾아보세요!
14 도구
xix.ai

2026년 최신 최고 평점을 받은 AI 숙제 도우미: 단순한 정답 제공이 아닌 핵심 개념을 가르쳐 주는 학생들을 위한 강력한 도구. 꼭 사용해 봐야 할 엄선된 목록, 매주 업데이트, 무료 vs 유료 비교, 실제 사용 후기, 정확한 순위 정보를 통해 여러분의 학습 잠재력을 최대한 발휘할 수 있도록 도와드립니다. 지금 바로 살펴보고 더 스마트한 공부를 위한 완벽한 도구를 찾아보세요.
10 도구
xix.ai












