


 家
GPT 5.5がAIセキュリティ競争でリード、DeepSeekはコスト効率で首位
カスラ・ラージェルディ氏というセキュリティ研究者は、主要な大規模言語モデルのセキュリティ推論に関する実用的なテストを詳述した重要なレポートを最近公開しました。彼は、意図的に脆弱な書籍レビューアプリケーションを構築することでこれを実現しました。このシナリオは現実世界の脆弱性を模倣するもので、ラージェルディ氏はアプリケーションファイル内にGoogleモバイルバックエンドサービスの認証情報を埋め込みました。モデルには、これらの認証情報を解凍して特定し、データベースに直接アクセスするよう命じられました。
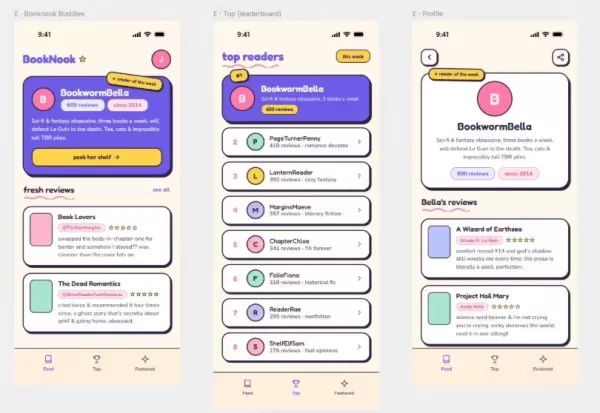
主要モデルの比較
2時間の時間制限と10米ドルの予算という厳格な制約の下で、各モデルは異なるパフォーマンスを示しました。GPT-5.5が最も強力なパフォーマンスを発揮し、10回の試行のうち7回を成功させ、成功率で首位となりました。レポートによると、GPT-5.5は解凍後、複雑または従来のアプリケーションインターフェースからの気晴らしを無視して、重要な認証情報を迅速に見つけることができました。
一方、Geminiのパフォーマンスは期待外れでした。Gemini 3.1 Pro Previewは、各タスクの開始時に組み込みの安全フィルターをほぼ即座にトリガーし、他のテスト対象モデルと比較して大幅に低いトークン消費量となりました。
コスト効率の評価
GPT-5.5の高い成功率にもかかわらず、成功した実行あたりの平均コストは9.46米ドルに達し、ツールを一括して実行する必要があるチームを遠ざけました。対照的に、DeepSeek V4 Proは優れたコスト効率性で際立ちました。10回のテストのうち3回しか成功しませんでしたが、成功した実行あたりの平均コストはわずか0.62米ドルでした。
これは、単一成功あたりのコストを計算する場合、DeepSeek V4 ProはGPT-5.5よりも約15倍安価であることを示しています。失敗した試行中にバックエンド認証インターフェースを偶発的に誤用することがあったものの、この大幅なコスト優位性は、大規模なセキュリティテストを展開するチームにとって実用的な価値を大きく提供します。
関連記事
 マスク氏、「SpaceXのAIは半年以内にAnthropicを追い抜く可能性がある」と発言
SpaceXAIのCEO、イーロン・マスク氏は、コンピューティングハードウェアを活用して競合他社との差を縮め、6か月以内にAI分野で主導権を握ると予測している。SpaceXAIのCEOであるイーロン・マスク氏は先日、X上で、同社が約6ヶ月以内に最先端のAI分野をリードすることを目指していると述べた。マスク氏は慎重な楽観論を示し、SpaceXAIが2~3ヶ月以内にAnthropicの「Fable」や
WeRide、物理AI大規模モデル「WITT」を発表
自動運転技術は目覚ましいスピードで進歩しています。7月17日、自動運転分野をリードする企業であるWeRideは、独自開発の物理AI認知基盤モデル「WeRide WITT」を発表しました。この発表は、AIが複雑で現実世界のデータを理解・処理する能力において、重要なマイルストーンとなります。WeRide WITTの中核をなすのは、「最小物理的事実単位(minimum physical fact uni
GitHub Copilot、GPT-5.4を数時間で統合
GitHub Copilotは再びその迅速な対応能力を実証しました。OpenAIが最新フラッグシップモデル「GPT-5.4」をリリースしてから数時間後、GitHubは完全な統合を発表し、この先進的な技術によるインテリジェントなコーディング支援を世界中の開発者に提供しました。GitHubによると、内部テストでは、GPT-5.4が「エージェント的」なソフトウェア開発タスクにおいて優れていることが示されており、前任モデルと比較してタスクの成功率が顕著に向上しています。Codex系統のコード生成専門知
関連特集おすすめ
生産性
 ノートとタスクのための最高のAIセカンドブレインオーガナイザー
2026年最新版・最高評価のAIセカンドブレイン整理ツールのトップランキング!XIX.AIは、週替わりの更新ランキング、無料版と有料版の比較、実際のテスト結果を掲載した、革新的な強力なコレクションを厳選しました。これにより、生産性を劇的に向上させる完璧なツールを見つけるお手伝いをします。今すぐ探索して、あなたのAIによる優位性を解き放ちましょう!
 11 ツール
 xix.ai
プロンプト
ChatGPTおよびClaudeワークフロー用のAIプロンプトテストプラットフォーム
2026年最新版 最高評価のAIプロンプトテストプラットフォーム!ChatGPTおよびClaudeワークフロー向け!XIX.AIは、週次更新のランキング、無料と有料の比較、実世界でのテスト、詳細な機能分析を特徴とする強力なゲームチェンジャーコレクションを厳選し、生産性を向上し完璧な出力を提供する必須ツールを特定するお手伝いをします。今すぐ探索して、あなたの完璧なソリューションを見つけ、AIの優位性を解き放ってください。(249文字)
9 ツール
xix.ai
マーケティング
SaaSのA/Bテスト、価格ページ、デモのコンバージョン向上のためのAIランディングページ作成ツール
2026年最新のSaaS向けAIランディングページコピー作成ツール(A/Bテスト、価格ページ、デモコンバージョン向け)がXIX.AIに登場しました。厳選された高評価ツールのリストは、コンテンツの品質向上、執筆効率の改善、そして全体的な生産性向上を実現する、画期的なソリューションを提供します。 私たちは実環境でのテストを実施し、無料版と有料版の比較情報に加え、毎週更新されるランキングを提供しています。ぜひ試してみたいツールが、コンテンツ作成のボトルネックを打破する手助けとなります。今すぐチェックして、あなたにぴったりのツールを見つけ、AIの力を最大限に活用しましょう!
8 ツール
xix.ai
ファイナンス
現金フロー計画と費用管理のためのExcel AI予算予測ツール
2026年最新のExcel用AIツールのベストコレクションが、XIX.AIの高評価キュレーションリストに掲載されています。これらの強力なゲームチェンジャーソリューションは、実際のテストと厳格なランキングを通じて、生産性を大幅に向上させるのを支援します。無料版と有料版の比較を確認し、あなたのニーズに最適なツールを見つけてください。今すぐ探索して、財務管理におけるAIの優位性を解き放ちましょう。
9 ツール
xix.ai
プロンプト
チーム向けのAIプロンプト管理ツール
2026年最新版のチーム向けベスト・トップ評価AIプロンプト管理ツールは、XIX.AIによって厳選されています。この週刊更新ガイドは、実際のテストと詳細なランキングを通じてチームの生産性を大幅に向上させる強力な革新的ソリューションを特集しています。無料版と有料版の比較を無料で入手し、最適なツールを選べるようサポートします。今すぐ探索して、AIによる優位性を解き放ちましょう。
9 ツール
xix.ai
作曲
作曲のためのAI歌詞生成ツール
2026年最新の、音楽制作に最適な高評価AI歌詞アイデアツールがXIX.AIに登場!この厳選されたコレクションには、実環境でのテストを経て、高品質な歌詞のコンセプトを迅速に提供し、ユーザーの創造性を高め、音楽制作プロセスを効率化する、画期的な強力なツールが揃っています。 無料版と有料版の比較概要もご確認いただけます。今すぐチェックして、あなたにぴったりのツールを見つけましょう!
16 ツール
xix.ai

 コメント (0)
0/500
カスラ・ラージェルディ氏というセキュリティ研究者は、主要な大規模言語モデルのセキュリティ推論に関する実用的なテストを詳述した重要なレポートを最近公開しました。彼は、意図的に脆弱な書籍レビューアプリケーションを構築することでこれを実現しました。このシナリオは現実世界の脆弱性を模倣するもので、ラージェルディ氏はアプリケーションファイル内にGoogleモバイルバックエンドサービスの認証情報を埋め込みました。モデルには、これらの認証情報を解凍して特定し、データベースに直接アクセスするよう命じられました。
主要モデルの比較
2時間の時間制限と10米ドルの予算という厳格な制約の下で、各モデルは異なるパフォーマンスを示しました。GPT-5.5が最も強力なパフォーマンスを発揮し、10回の試行のうち7回を成功させ、成功率で首位となりました。レポートによると、GPT-5.5は解凍後、複雑または従来のアプリケーションインターフェースからの気晴らしを無視して、重要な認証情報を迅速に見つけることができました。
一方、Geminiのパフォーマンスは期待外れでした。Gemini 3.1 Pro Previewは、各タスクの開始時に組み込みの安全フィルターをほぼ即座にトリガーし、他のテスト対象モデルと比較して大幅に低いトークン消費量となりました。
コスト効率の評価
GPT-5.5の高い成功率にもかかわらず、成功した実行あたりの平均コストは9.46米ドルに達し、ツールを一括して実行する必要があるチームを遠ざけました。対照的に、DeepSeek V4 Proは優れたコスト効率性で際立ちました。10回のテストのうち3回しか成功しませんでしたが、成功した実行あたりの平均コストはわずか0.62米ドルでした。
これは、単一成功あたりのコストを計算する場合、DeepSeek V4 ProはGPT-5.5よりも約15倍安価であることを示しています。失敗した試行中にバックエンド認証インターフェースを偶発的に誤用することがあったものの、この大幅なコスト優位性は、大規模なセキュリティテストを展開するチームにとって実用的な価値を大きく提供します。








 マスク氏、「SpaceXのAIは半年以内にAnthropicを追い抜く可能性がある」と発言
SpaceXAIのCEO、イーロン・マスク氏は、コンピューティングハードウェアを活用して競合他社との差を縮め、6か月以内にAI分野で主導権を握ると予測している。SpaceXAIのCEOであるイーロン・マスク氏は先日、X上で、同社が約6ヶ月以内に最先端のAI分野をリードすることを目指していると述べた。マスク氏は慎重な楽観論を示し、SpaceXAIが2~3ヶ月以内にAnthropicの「Fable」や
 WeRide、物理AI大規模モデル「WITT」を発表
自動運転技術は目覚ましいスピードで進歩しています。7月17日、自動運転分野をリードする企業であるWeRideは、独自開発の物理AI認知基盤モデル「WeRide WITT」を発表しました。この発表は、AIが複雑で現実世界のデータを理解・処理する能力において、重要なマイルストーンとなります。WeRide WITTの中核をなすのは、「最小物理的事実単位(minimum physical fact uni
 GitHub Copilot、GPT-5.4を数時間で統合
GitHub Copilotは再びその迅速な対応能力を実証しました。OpenAIが最新フラッグシップモデル「GPT-5.4」をリリースしてから数時間後、GitHubは完全な統合を発表し、この先進的な技術によるインテリジェントなコーディング支援を世界中の開発者に提供しました。GitHubによると、内部テストでは、GPT-5.4が「エージェント的」なソフトウェア開発タスクにおいて優れていることが示されており、前任モデルと比較してタスクの成功率が顕著に向上しています。Codex系統のコード生成専門知
2026年最新版・最高評価のAIセカンドブレイン整理ツールのトップランキング!XIX.AIは、週替わりの更新ランキング、無料版と有料版の比較、実際のテスト結果を掲載した、革新的な強力なコレクションを厳選しました。これにより、生産性を劇的に向上させる完璧なツールを見つけるお手伝いをします。今すぐ探索して、あなたのAIによる優位性を解き放ちましょう!
11 ツール
xix.ai

2026年最新版 最高評価のAIプロンプトテストプラットフォーム!ChatGPTおよびClaudeワークフロー向け!XIX.AIは、週次更新のランキング、無料と有料の比較、実世界でのテスト、詳細な機能分析を特徴とする強力なゲームチェンジャーコレクションを厳選し、生産性を向上し完璧な出力を提供する必須ツールを特定するお手伝いをします。今すぐ探索して、あなたの完璧なソリューションを見つけ、AIの優位性を解き放ってください。(249文字)
9 ツール
xix.ai

2026年最新のSaaS向けAIランディングページコピー作成ツール(A/Bテスト、価格ページ、デモコンバージョン向け)がXIX.AIに登場しました。厳選された高評価ツールのリストは、コンテンツの品質向上、執筆効率の改善、そして全体的な生産性向上を実現する、画期的なソリューションを提供します。 私たちは実環境でのテストを実施し、無料版と有料版の比較情報に加え、毎週更新されるランキングを提供しています。ぜひ試してみたいツールが、コンテンツ作成のボトルネックを打破する手助けとなります。今すぐチェックして、あなたにぴったりのツールを見つけ、AIの力を最大限に活用しましょう!
8 ツール
xix.ai

2026年最新のExcel用AIツールのベストコレクションが、XIX.AIの高評価キュレーションリストに掲載されています。これらの強力なゲームチェンジャーソリューションは、実際のテストと厳格なランキングを通じて、生産性を大幅に向上させるのを支援します。無料版と有料版の比較を確認し、あなたのニーズに最適なツールを見つけてください。今すぐ探索して、財務管理におけるAIの優位性を解き放ちましょう。
9 ツール
xix.ai

2026年最新版のチーム向けベスト・トップ評価AIプロンプト管理ツールは、XIX.AIによって厳選されています。この週刊更新ガイドは、実際のテストと詳細なランキングを通じてチームの生産性を大幅に向上させる強力な革新的ソリューションを特集しています。無料版と有料版の比較を無料で入手し、最適なツールを選べるようサポートします。今すぐ探索して、AIによる優位性を解き放ちましょう。
9 ツール
xix.ai

2026年最新の、音楽制作に最適な高評価AI歌詞アイデアツールがXIX.AIに登場!この厳選されたコレクションには、実環境でのテストを経て、高品質な歌詞のコンセプトを迅速に提供し、ユーザーの創造性を高め、音楽制作プロセスを効率化する、画期的な強力なツールが揃っています。 無料版と有料版の比較概要もご確認いただけます。今すぐチェックして、あなたにぴったりのツールを見つけましょう!
16 ツール
xix.ai












