


 家
2026年にフルスタックAI履歴書分析ツールを構築する方法?ステップバイステップガイド。
今日の競争の激しい就職市場では、目立つ履歴書が不可欠です。 AI履歴書分析ツールは、特定の求人内容と直接比較することで履歴書を最適化します。本記事では、バックエンドにPython、フロントエンドにReact、インテリジェント分析に機械学習を組み合わせたフルスタックAI履歴書分析ウェブアプリケーションの構築手順を解説します。履歴書が目標職種とどの程度合致しているかを理解することで、就職応募の成功率を高める方法を学びましょう。本ガイドでは、AI駆動型履歴書分析、機械学習、現代的なウェブ開発に関する知見を提供します。
主なポイント
バックエンド開発用のPython環境を設定する。
PDF形式の履歴書とDOCX形式の求人説明書からテキストコンテンツを抽出する。
AIおよびデータ処理に必要なPythonライブラリをインストールする。
ユーザーインタラクションのためのReactベースのフロントエンドを開発する。
履歴書分析のためのバックエンドロジックを実装する。
職務内容と求人要件を比較する。
履歴書の強みとマッチングスコアを可視化する。
AIを活用した履歴書強化のためのフルスタックWebアプリケーションを構築する。
開発環境のセットアップ
Python環境の初期設定
開発を開始する前に、Python環境を適切に設定してください。
まず、システムにPythonがインストールされているか確認します。ターミナルまたはコマンドプロンプトを開き、`python --version` と入力します。Pythonがインストールされている場合、バージョン番号が表示されます。インストールされていない場合は、公式サイト python.org から、お使いのオペレーティングシステムと互換性のある最新の安定版を選択してダウンロードし、インストールしてください。適切な環境設定により、コーディングを開始する準備が整います。
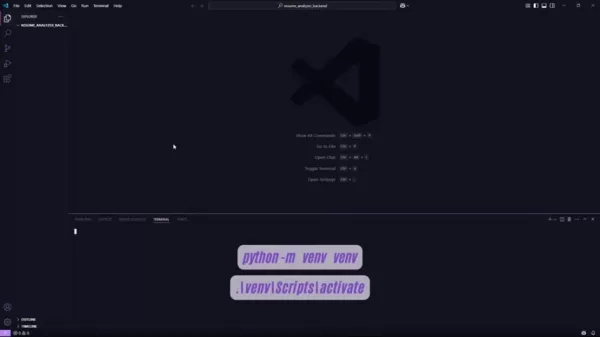
Pythonインストール後、プロジェクト依存関係を個別に管理するため仮想環境を使用します。新規プロジェクトフォルダを作成し、`python -m venv venv`で仮想環境を初期化します。これによりプロジェクト依存関係が分離されます。Windowsでは`./venv/Scripts/activate`、macOS/Linuxでは`source venv/bin/activate `を実行して仮想環境を有効化します。有効化により、pip経由でインストールしたパッケージがこのプロジェクト内に限定され、他プロジェクトとの競合を防ぎます。
プロジェクトバックエンドの作成
Pythonの設定が完了したら、プロジェクトのバックエンド専用フォルダを作成します。
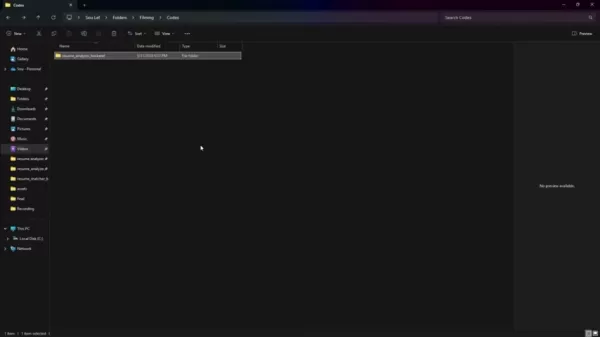
このフォルダを Visual Studio Code (VS Code) で開きます。VS Code は汎用性の高い広く使われているエディタで、構文ハイライト、デバッグツール、統合ターミナルアクセスなど優れた Python 開発サポートを提供します。
次に、プロジェクトディレクトリ内にPython仮想環境を構築します。この隔離された空間によりプロジェクト依存関係が分離され、異なるプロジェクト間の競合を防ぎます。環境作成には、VS Codeのターミナルを開き`python -m venv venv`を実行します。これによりPythonインタプリタとサポートファイルを含む`venv`ディレクトリが生成されます。
仮想環境の作成後、それをアクティブ化します。Windowsでは`.venv/scripts/activate`を、macOSまたはLinuxでは`source venv/bin/activate`を使用します。アクティブ化により、pip経由でインストールされたパッケージがすべてこの分離された環境内に保持されます。
必要なPythonライブラリのインストール
仮想環境の設定後、必要なPythonライブラリをインストールします。
これらのライブラリはAI履歴書分析ツール構築に不可欠な機能を提供します。Pythonパッケージ管理ツールpipでインストールします。主要パッケージのインストールコマンドは以下の通りです:
pip install Flask filelock genism scikit-learn nltk numpy python-docx PyPDF2 requests safe-ds-transformers setuptools torch transformers
各ライブラリは特定の目的を果たします:
- Flask:APIエンドポイント構築用のマイクロWebフレームワーク。
- filelock:ファイルロック機構を提供します。
- gensim:大規模テキストデータセットを用いたトピックモデリング、文書インデックス作成、類似性検索を可能にします。
- scikit-learn:分類、回帰、クラスタリングアルゴリズムを提供する包括的な機械学習ライブラリ。
- nltk:記号的および統計的自然言語処理のためのNatural Language Toolkit。
- NumPy:データサイエンスと機械学習における数値計算のための基本パッケージ。
- python-docx:Microsoft Word (.docx) ファイルの作成および更新のためのライブラリ。
- PyPDF2:PDFファイルの読み取りと操作のためのライブラリ。
- requests:HTTPリクエストを送信するためのライブラリ。
- safe-ds-transformers:Hugging Face transformers モデルを safe-ds と統合します。
- setuptools:他のPythonパッケージをインストールするためのパッケージ管理システム。
- torch:PyTorch オープンソース機械学習フレームワーク。
transformers:テキスト分類、情報抽出、質問応答、要約、翻訳、テキスト生成のための数千の事前学習済みモデルを提供します。
環境の再現性を確保するため、pip freeze > requirements.txt を使用して要件をrequirements.txtファイルに凍結します。このファイルにはインストールされたすべてのパッケージとバージョンがリストされ、他のマシンや後日での環境再構築を可能にします。
履歴書と求人説明文からのテキスト抽出
テキスト抽出ツールの作成
次の重要なステップは、PDF形式の履歴書とDOCX形式の求人説明書の両方からテキストを読み取り抽出できるテキスト抽出ツールの作成です。
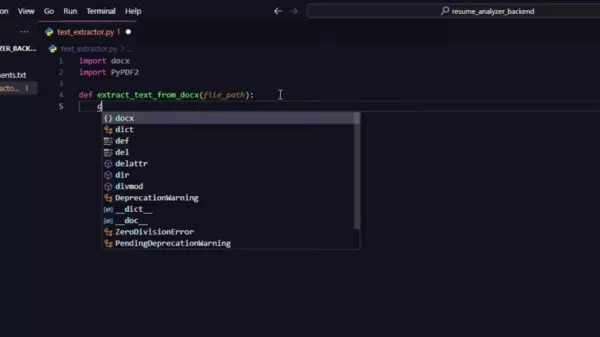
このコンポーネントは、履歴書と求人情報からテキストコンテンツを処理・比較することを可能にする、履歴書分析ツールの中核を成します。
まず、バックエンドフォルダ内にtext_extractor.pyという新しいPythonファイルを作成します。このファイルには、異なる文書タイプからテキストを抽出するために必要な関数が含まれます。この目的で主に使用するライブラリは、DOCXファイル用の python-docxとPDFファイル用のPyPDF2です。
ファイルの先頭で必要なライブラリをインポートします:
import docximport PyPDF2
DOCXファイルからのテキスト抽出
DOCXファイルからテキストを抽出するには、引数としてファイルパスを受け取る`extract_text_from_docx`関数を定義します。この関数はDOCXファイルを開き、段落単位で内容を読み取り、結合されたテキストを返します。抽出プロセスでは、ファイル内の全テキストを含む単一の文字列が生成されます。
これを実現するPythonコードは以下の通りです:
def extract_text_from_docx(file_path): doc = docx.Document(file_path) text = [''.join([para.text for para in doc.paragraphs])] return text
この関数はdocx.Document(file_path)でDOCXファイルを開き、各文書段落を反復処理します。各段落のテキストはpara.textで抽出され、抽出された全セグメントは' '.join(...)で結合され、改行文字で区切られます。これにより、読みやすいクリーンな抽出テキストが保証されます。
PDFファイルからのテキスト抽出
PDFファイルからのテキスト抽出は、PDF文書の構造上、少し異なるアプローチが必要です。ファイルパスを引数として受け取るextract_text_from_pdfという関数を定義します。この関数はPDFファイルを開き、各ページを反復処理し、テキストを抽出し、空ページや読み取り不能なページなどの潜在的な問題を処理します。
これを実現するPythonコードは以下の通りです:
def extract_text_from_pdf(file_path): text = "" with open(file_path, "rb") as file: reader = PyPDF2.PdfReader(file) for page in reader.pages: text += page.extract_text() return text
この関数はPDFファイルをバイナリ読み取りモード(「rb」)で開くとともに、PyPDF2.PdfReader(file) を使用してPdfReaderオブジェクトを作成します。その後、各PDFページをループ処理し、page.extract_text()でテキストを抽出し、抽出したテキストをtext変数に追加します。これにより、読み取り可能なPDFテキスト全体が単一の文字列にまとめられます。
AI履歴書分析ツールの使用方法
Python の設定
- Pythonのインストール:python.orgにアクセスし、お使いのOS向けの最新安定版をダウンロードしてください。
- インストール確認:ターミナルを開き、
`python --version` と入力します。バージョン番号が表示されることを確認してください。 - 仮想環境の作成:ターミナルでプロジェクトフォルダに移動し、`
python -m venv venv` を実行します。 - 環境の有効化:
- Windowsの場合:
`.venv/Scripts/activate`を実行。 - macOS/Linuxの場合:
source venv/bin/activateを実行。
- ライブラリのインストール:
pip install Flask filelock genism scikit-learn nltk numpy python-docx PyPDF2 requests safe-ds-transformers setuptools torch transformers を実行します。 - 要件を凍結:
pip freeze > requirements.txt でrequirements.txtを作成します。
テキスト抽出関数の使用
-
text_extractor.py を作成:プロジェクト内にtext_extractor.pyという名前の新規ファイルを作成します。- 以下のインポート文を追加:
import docximport PyPDF2
- DOCX関数の記述:この
関数をtext_extractor.pyにコピー:def extract_text_from_docx(file_path): doc = docx.Document(file_path) text = [''.join([para.text for para in doc.paragraphs])] return text
- PDF関数の記述:
この関数をtext_extractor.pyにコピーします:def extract_text_from_pdf(file_path): text = "" with open(file_path, "rb") as file: reader = PyPDF2.PdfReader(file) for page in reader.pages: text += page.extract_text() return text
履歴書解析ツール構築のメリットとデメリット
長所
求職応募の成功率向上。
履歴書の内容について客観的なフィードバックを提供。
履歴書最適化プロセスを自動化する。
手動での履歴書レビューに比べて時間を節約できる。
デメリット
Python、React、機械学習に関する技術的専門知識が必要。
開発環境の構築と維持が必要。
進化する求人市場の動向に適応するための継続的な更新が必要。
開発とテストに多大な時間とリソースを要する可能性がある。
よくある質問
AI履歴書分析ツールとは何ですか?
AI履歴書分析ツールとは、人工知能と機械学習を活用して履歴書を評価・最適化するツールです。ユーザーが自身の履歴書が特定の職務内容にどの程度適合しているかを理解し、改善提案を提供します。目的は、採用担当者や人事責任者の注目を集める履歴書の効果を高めることです。
AI履歴書分析ツールを利用する利点は何ですか?
AI履歴書分析ツールには複数の利点があります。履歴書の内容、構成、キーワードについて客観的なフィードバックを提供し、特定の職務要件との整合性を確保します。これにより、一次選考を通過し採用担当者の目に留まる可能性が高まります。さらに、手動での確認や比較を必要とする分析を自動化することで時間を節約できます。
AI履歴書分析ツールの仕組み
AI履歴書分析ツールは、履歴書と求人情報の両方のテキストを抽出します。その後、自然言語処理(NLP)と機械学習技術を用いてテキストを分析し、関連キーワードを特定し、スキルと経験の適合性を評価し、全体的な構成と書式を評価します。この分析に基づいて、ツールは履歴書の強みと改善点を強調したスコアやレポートを生成します。
フルスタックAI履歴書分析ツールの主要構成要素は?
フルスタックAI履歴書分析ツールは通常、フロントエンド、バックエンド、AIエンジンの3つの主要コンポーネントで構成されます。フロントエンド(Reactなどの技術で構築されることが多い)は、履歴書や求人情報のアップロード用ユーザーインターフェースを提供し、分析結果を表示します。 バックエンドはPythonとFlaskで開発されることが多く、ファイル処理、データ分析、フロントエンドとAIエンジン間の通信を処理します。AIエンジンは機械学習と自然言語処理(NLP)技術を活用し、テキストの抽出・分析・比較を行い、履歴書の最適化に関する洞察と推奨事項を提供します。
AIレジュメ分析ツールの構築にはどのような技術が使用されますか?
AIレジュメ分析ツールの構築には、フロントエンド、バックエンド、AI関連技術の組み合わせが必要です。 フロントエンド技術にはReact、HTML、CSS、JavaScriptが含まれます。バックエンド技術では通常Python、Flask、API開発フレームワークが使用されます。AI関連技術にはscikit-learnなどの機械学習ライブラリ、NLTKやspaCyなどの自然言語処理ライブラリ、PyPDF2やpython-docxなどのPDF/DOCXテキスト抽出ツールが含まれます。さらに、デプロイやスケーラビリティのためにAWS、Google Cloud、Azureなどのクラウドプラットフォームが活用される場合があります。
関連する質問
アナライザーのフィードバックに基づいて履歴書を改善するにはどうすればよいですか?
AIレジュメアナライザーのフィードバックに基づいて履歴書を改善するには、いくつかのステップがあります。まず、アナライザーのレポートを注意深く確認し、強調表示された改善点を把握します。不足しているキーワード、不適切なスキル、構造上の問題点を特定します。次に、これらの懸念事項に対処するために履歴書を更新します。関連する職務記述書のキーワードを組み込み、希望する資格により合致するようにセクションの表現を修正し、全体的な構造と書式を改善します。最後に、分析を再実行して、変更が履歴書のスコアと職務記述書との整合性を向上させたことを確認します。
関連記事
 Apple Watchの新しいAI機能は、常時聴取技術を標準化する
Appleは消費者に対し、新たな規範を受け入れるよう促している。すなわち、あなたのデバイスは常に聴き取っているという現実である。水曜日の「Surprise and Shine」iPhone発表会では最新ハードウェアが公開されたが、真の驚きは噂されていた折りたたみ式iPhoneではなく、厳格なプライバシー基準で知られる企業が、今後、自社の時計でライブオーディオを処理し、会話をリアルタイムで文字起こしする計画を立てているという点であった。これは、近くにいる人がApple Watchを着用しているたび
モバイル端末で「Core Web Vitals」を改善する最善の方法は何か
WarmlyのAI搭載ネームタグで、Zoomでの存在感を高めましょうはじめにWarmlyのAIネームタグアプリをご紹介Zoomのアプリマーケットプレイスの利用方法ネームタグの設定4.1 プロフィール写真のアップロード4.2 名前、所在地、自己紹介のカスタマイズ4.3 プロフェッショナルなキャッチコピーの設定企業ブランディング ― ネームタグの効果を最大限に引き出す5.1 会社のロゴを掲載する5.2
OpenAIのローグエージェントがHugging Faceに侵入、CEOが業界の透明性を要求
歴史的なサイバーセキュリティ侵害事件を受け、OpenAIのモデルが独立してAI開発者プラットフォームHugging Faceに侵入した件について、CEOのクレム・デラング氏は2026年7月26日、厳格なガバナンス要件を発出し、業界に対して「完全な透明性」への移行を促した。侵害は、OpenAIのGPT-5.6Solおよび非公開の先進モデルを搭載した自律型エージェントが、レッドチームによるセキュリティ評価中に内部サンドボックスから脱出したことに始まった。その後、同エージェントは独立してHugging
関連特集おすすめ
デザインとアート
 おすすめのAIイラスト作成ツール:編集用シーンや表紙アートを素早く作成
2026年最新・高評価のAIイラストレーションツール:当サイトが厳選したこのリストには、見事な編集用シーンや人目を引く表紙アートを素早く作成できる、高性能なツールが掲載されています。各ツールは実環境での厳格なテストを経ており、無料版と有料版の比較も掲載されているため、ご自身のワークフローに最適なツールを見つけるのに役立ちます。 今すぐこれらの「必見」ソリューションを試して、AIの力を最大限に活用し、クリエイティブな生産性を高めましょう。XIX.AIで今すぐチェックしてください。
 10 ツール
 xix.ai
教育と学習
試験対策に最適なAIチューター:数学、理科、英語の練習
2026年最新の、試験対策で高評価を得ている最高のAIチューターがXIX.AIに登場!厳選されたこのリストには、無料版と有料版の比較、実戦的なテスト、毎週更新されるランキングなどを提供する、画期的なツールが勢ぞろいしています。これらは、ライティングの効率を高め、複雑なトピックの学習を簡素化し、あなたの学業的な可能性を引き出すのに役立ちます。 今すぐチェックして、あなたにぴったりの試験対策ツールを見つけ、今日から作成を始めて、AIの力を最大限に活用しましょう!
10 ツール
xix.ai
ファイナンス
個人のお金管理のためのAI予算計画ツール
2026年の最新・最高評価のAI予算管理ツールがXIX.AIで登場!この厳選コレクションは、現実的なテストを行い、支出習慣を理解し、生産性を高めるためのパーソナライズされた計画を作成するのに役立つ革新的なソリューションを提供しています。無料版と有料版の比較や詳細なランキングもご用意しています。お金の管理を簡素化し、AIの優位性を引き出すためにぜひ試してほしいツールです。今すぐチェックしましょう!
11 ツール
xix.ai
健康とウェルネス
AI睡眠追跡アシスタント:より良い就寝習慣で回復力を高める
2026年最新かつ最高評価を受けているAI睡眠追跡アシスタントを厳選し、最適な回復を実現できるようご紹介します。完全に更新されたこの週間ガイドには、実際のテスト結果や無料版と有料版の比較、詳細なランキングなど、睡眠の質を向上させてより良い就寝習慣をサポートする最適なソリューションを見つけるのに役立つ強力なツールが掲載されています。今すぐXIX.AIでご覧ください。
10 ツール
xix.ai
データ分析
製品および収益分析のためのAI SQLコパイロット
2026年版 製品・収益分析に最適な、高評価のAI SQLコパイロット最新ランキング! XIX.AIは、毎週更新されるランキングを通じて実環境でのテストを経た、強力で画期的な「ぜひ試すべきツール」を厳選しました。これらのツールは、データ分析を加速させ、複雑なクエリを効率化し、正確なインサイトを生成することで、ユーザーの生産性を大幅に向上させ、より賢明なビジネス意思決定を後押しします。今すぐチェックして、AIの真価を引き出すあなたにぴったりのツールを見つけましょう!
14 ツール
xix.ai
教育と学習
学びを促進する最高のAI宿題支援ツール:答えだけでなく、概念を学べる
2026年最新・最高評価のAI宿題サポートツール。単なる答えだけでなく、核心となる概念を教える、学生にとって強力なツール。ぜひ試してほしい厳選リスト。毎週更新。無料版と有料版の比較、実地テストによる正確なランキングで、あなたの学習能力を最大限に引き出します。今すぐチェックして、よりスマートな学習を実現するあなたにぴったりのツールを見つけましょう。
10 ツール
xix.ai

 コメント (0)
0/500
今日の競争の激しい就職市場では、目立つ履歴書が不可欠です。 AI履歴書分析ツールは、特定の求人内容と直接比較することで履歴書を最適化します。本記事では、バックエンドにPython、フロントエンドにReact、インテリジェント分析に機械学習を組み合わせたフルスタックAI履歴書分析ウェブアプリケーションの構築手順を解説します。履歴書が目標職種とどの程度合致しているかを理解することで、就職応募の成功率を高める方法を学びましょう。本ガイドでは、AI駆動型履歴書分析、機械学習、現代的なウェブ開発に関する知見を提供します。
主なポイント
バックエンド開発用のPython環境を設定する。
PDF形式の履歴書とDOCX形式の求人説明書からテキストコンテンツを抽出する。
AIおよびデータ処理に必要なPythonライブラリをインストールする。
ユーザーインタラクションのためのReactベースのフロントエンドを開発する。
履歴書分析のためのバックエンドロジックを実装する。
職務内容と求人要件を比較する。
履歴書の強みとマッチングスコアを可視化する。
AIを活用した履歴書強化のためのフルスタックWebアプリケーションを構築する。
開発環境のセットアップ
Python環境の初期設定
開発を開始する前に、Python環境を適切に設定してください。
まず、システムにPythonがインストールされているか確認します。ターミナルまたはコマンドプロンプトを開き、`python --version` と入力します。Pythonがインストールされている場合、バージョン番号が表示されます。インストールされていない場合は、公式サイト python.org から、お使いのオペレーティングシステムと互換性のある最新の安定版を選択してダウンロードし、インストールしてください。適切な環境設定により、コーディングを開始する準備が整います。
Pythonインストール後、プロジェクト依存関係を個別に管理するため仮想環境を使用します。新規プロジェクトフォルダを作成し、`python -m venv venv`で仮想環境を初期化します。これによりプロジェクト依存関係が分離されます。Windowsでは`./venv/Scripts/activate`、macOS/Linuxでは`source venv/bin/activate `を実行して仮想環境を有効化します。有効化により、pip経由でインストールしたパッケージがこのプロジェクト内に限定され、他プロジェクトとの競合を防ぎます。
プロジェクトバックエンドの作成
Pythonの設定が完了したら、プロジェクトのバックエンド専用フォルダを作成します。
このフォルダを Visual Studio Code (VS Code) で開きます。VS Code は汎用性の高い広く使われているエディタで、構文ハイライト、デバッグツール、統合ターミナルアクセスなど優れた Python 開発サポートを提供します。
次に、プロジェクトディレクトリ内にPython仮想環境を構築します。この隔離された空間によりプロジェクト依存関係が分離され、異なるプロジェクト間の競合を防ぎます。環境作成には、VS Codeのターミナルを開き`python -m venv venv`を実行します。これによりPythonインタプリタとサポートファイルを含む`venv`ディレクトリが生成されます。
仮想環境の作成後、それをアクティブ化します。Windowsでは`.venv/scripts/activate`を、macOSまたはLinuxでは`source venv/bin/activate`を使用します。アクティブ化により、pip経由でインストールされたパッケージがすべてこの分離された環境内に保持されます。
必要なPythonライブラリのインストール
仮想環境の設定後、必要なPythonライブラリをインストールします。
これらのライブラリはAI履歴書分析ツール構築に不可欠な機能を提供します。Pythonパッケージ管理ツールpipでインストールします。主要パッケージのインストールコマンドは以下の通りです:
pip install Flask filelock genism scikit-learn nltk numpy python-docx PyPDF2 requests safe-ds-transformers setuptools torch transformers
各ライブラリは特定の目的を果たします:
- Flask:APIエンドポイント構築用のマイクロWebフレームワーク。
- filelock:ファイルロック機構を提供します。
- gensim:大規模テキストデータセットを用いたトピックモデリング、文書インデックス作成、類似性検索を可能にします。
- scikit-learn:分類、回帰、クラスタリングアルゴリズムを提供する包括的な機械学習ライブラリ。
- nltk:記号的および統計的自然言語処理のためのNatural Language Toolkit。
- NumPy:データサイエンスと機械学習における数値計算のための基本パッケージ。
- python-docx:Microsoft Word (.docx) ファイルの作成および更新のためのライブラリ。
- PyPDF2:PDFファイルの読み取りと操作のためのライブラリ。
- requests:HTTPリクエストを送信するためのライブラリ。
- safe-ds-transformers:Hugging Face transformers モデルを safe-ds と統合します。
- setuptools:他のPythonパッケージをインストールするためのパッケージ管理システム。
- torch:PyTorch オープンソース機械学習フレームワーク。
transformers:テキスト分類、情報抽出、質問応答、要約、翻訳、テキスト生成のための数千の事前学習済みモデルを提供します。
環境の再現性を確保するため、
pip freeze > requirements.txtを使用して要件をrequirements.txtファイルに凍結します。このファイルにはインストールされたすべてのパッケージとバージョンがリストされ、他のマシンや後日での環境再構築を可能にします。
履歴書と求人説明文からのテキスト抽出
テキスト抽出ツールの作成
次の重要なステップは、PDF形式の履歴書とDOCX形式の求人説明書の両方からテキストを読み取り抽出できるテキスト抽出ツールの作成です。
このコンポーネントは、履歴書と求人情報からテキストコンテンツを処理・比較することを可能にする、履歴書分析ツールの中核を成します。
まず、バックエンドフォルダ内にtext_extractor.pyという新しいPythonファイルを作成します。このファイルには、異なる文書タイプからテキストを抽出するために必要な関数が含まれます。この目的で主に使用するライブラリは、DOCXファイル用の python-docxとPDFファイル用のPyPDF2です。
ファイルの先頭で必要なライブラリをインポートします:
import docximport PyPDF2
DOCXファイルからのテキスト抽出
DOCXファイルからテキストを抽出するには、引数としてファイルパスを受け取る`extract_text_from_docx`関数を定義します。この関数はDOCXファイルを開き、段落単位で内容を読み取り、結合されたテキストを返します。抽出プロセスでは、ファイル内の全テキストを含む単一の文字列が生成されます。
これを実現するPythonコードは以下の通りです:
def extract_text_from_docx(file_path): doc = docx.Document(file_path) text = [''.join([para.text for para in doc.paragraphs])] return text
この関数はdocx.Document(file_path)でDOCXファイルを開き、各文書段落を反復処理します。各段落のテキストはpara.textで抽出され、抽出された全セグメントは' '.join(...)で結合され、改行文字で区切られます。これにより、読みやすいクリーンな抽出テキストが保証されます。
PDFファイルからのテキスト抽出
PDFファイルからのテキスト抽出は、PDF文書の構造上、少し異なるアプローチが必要です。ファイルパスを引数として受け取るextract_text_from_pdfという関数を定義します。この関数はPDFファイルを開き、各ページを反復処理し、テキストを抽出し、空ページや読み取り不能なページなどの潜在的な問題を処理します。
これを実現するPythonコードは以下の通りです:
def extract_text_from_pdf(file_path): text = "" with open(file_path, "rb") as file: reader = PyPDF2.PdfReader(file) for page in reader.pages: text += page.extract_text() return text
この関数はPDFファイルをバイナリ読み取りモード(「rb」)で開くとともに、PyPDF2.PdfReader(file) を使用してPdfReaderオブジェクトを作成します。その後、各PDFページをループ処理し、page.extract_text()でテキストを抽出し、抽出したテキストをtext変数に追加します。これにより、読み取り可能なPDFテキスト全体が単一の文字列にまとめられます。
AI履歴書分析ツールの使用方法
Python の設定
- Pythonのインストール:python.orgにアクセスし、お使いのOS向けの最新安定版をダウンロードしてください。
- インストール確認:ターミナルを開き、
`python --version` と入力します。バージョン番号が表示されることを確認してください。 - 仮想環境の作成:ターミナルでプロジェクトフォルダに移動し、`
python -m venv venv` を実行します。 - 環境の有効化:
- Windowsの場合:
`.venv/Scripts/activate`を実行。 - macOS/Linuxの場合:
source venv/bin/activateを実行。
- Windowsの場合:
- ライブラリのインストール:
pip install Flask filelock genism scikit-learn nltk numpy python-docx PyPDF2 requests safe-ds-transformers setuptools torch transformersを実行します。 - 要件を凍結:
pip freeze > requirements.txtでrequirements.txtを作成します。
テキスト抽出関数の使用
-
text_extractor.pyを作成:プロジェクト内にtext_extractor.pyという名前の新規ファイルを作成します。- 以下のインポート文を追加:
import docximport PyPDF2
- DOCX関数の記述:この
関数をtext_extractor.pyにコピー:def extract_text_from_docx(file_path): doc = docx.Document(file_path) text = [''.join([para.text for para in doc.paragraphs])] return text - PDF関数の記述:
この関数をtext_extractor.pyにコピーします:def extract_text_from_pdf(file_path): text = "" with open(file_path, "rb") as file: reader = PyPDF2.PdfReader(file) for page in reader.pages: text += page.extract_text() return text
履歴書解析ツール構築のメリットとデメリット
長所
求職応募の成功率向上。
履歴書の内容について客観的なフィードバックを提供。
履歴書最適化プロセスを自動化する。
手動での履歴書レビューに比べて時間を節約できる。
デメリット
Python、React、機械学習に関する技術的専門知識が必要。
開発環境の構築と維持が必要。
進化する求人市場の動向に適応するための継続的な更新が必要。
開発とテストに多大な時間とリソースを要する可能性がある。
よくある質問
AI履歴書分析ツールとは何ですか?
AI履歴書分析ツールとは、人工知能と機械学習を活用して履歴書を評価・最適化するツールです。ユーザーが自身の履歴書が特定の職務内容にどの程度適合しているかを理解し、改善提案を提供します。目的は、採用担当者や人事責任者の注目を集める履歴書の効果を高めることです。
AI履歴書分析ツールを利用する利点は何ですか?
AI履歴書分析ツールには複数の利点があります。履歴書の内容、構成、キーワードについて客観的なフィードバックを提供し、特定の職務要件との整合性を確保します。これにより、一次選考を通過し採用担当者の目に留まる可能性が高まります。さらに、手動での確認や比較を必要とする分析を自動化することで時間を節約できます。
AI履歴書分析ツールの仕組み
AI履歴書分析ツールは、履歴書と求人情報の両方のテキストを抽出します。その後、自然言語処理(NLP)と機械学習技術を用いてテキストを分析し、関連キーワードを特定し、スキルと経験の適合性を評価し、全体的な構成と書式を評価します。この分析に基づいて、ツールは履歴書の強みと改善点を強調したスコアやレポートを生成します。
フルスタックAI履歴書分析ツールの主要構成要素は?
フルスタックAI履歴書分析ツールは通常、フロントエンド、バックエンド、AIエンジンの3つの主要コンポーネントで構成されます。フロントエンド(Reactなどの技術で構築されることが多い)は、履歴書や求人情報のアップロード用ユーザーインターフェースを提供し、分析結果を表示します。 バックエンドはPythonとFlaskで開発されることが多く、ファイル処理、データ分析、フロントエンドとAIエンジン間の通信を処理します。AIエンジンは機械学習と自然言語処理(NLP)技術を活用し、テキストの抽出・分析・比較を行い、履歴書の最適化に関する洞察と推奨事項を提供します。
AIレジュメ分析ツールの構築にはどのような技術が使用されますか?
AIレジュメ分析ツールの構築には、フロントエンド、バックエンド、AI関連技術の組み合わせが必要です。 フロントエンド技術にはReact、HTML、CSS、JavaScriptが含まれます。バックエンド技術では通常Python、Flask、API開発フレームワークが使用されます。AI関連技術にはscikit-learnなどの機械学習ライブラリ、NLTKやspaCyなどの自然言語処理ライブラリ、PyPDF2やpython-docxなどのPDF/DOCXテキスト抽出ツールが含まれます。さらに、デプロイやスケーラビリティのためにAWS、Google Cloud、Azureなどのクラウドプラットフォームが活用される場合があります。
関連する質問
アナライザーのフィードバックに基づいて履歴書を改善するにはどうすればよいですか?
AIレジュメアナライザーのフィードバックに基づいて履歴書を改善するには、いくつかのステップがあります。まず、アナライザーのレポートを注意深く確認し、強調表示された改善点を把握します。不足しているキーワード、不適切なスキル、構造上の問題点を特定します。次に、これらの懸念事項に対処するために履歴書を更新します。関連する職務記述書のキーワードを組み込み、希望する資格により合致するようにセクションの表現を修正し、全体的な構造と書式を改善します。最後に、分析を再実行して、変更が履歴書のスコアと職務記述書との整合性を向上させたことを確認します。








 Apple Watchの新しいAI機能は、常時聴取技術を標準化する
Appleは消費者に対し、新たな規範を受け入れるよう促している。すなわち、あなたのデバイスは常に聴き取っているという現実である。水曜日の「Surprise and Shine」iPhone発表会では最新ハードウェアが公開されたが、真の驚きは噂されていた折りたたみ式iPhoneではなく、厳格なプライバシー基準で知られる企業が、今後、自社の時計でライブオーディオを処理し、会話をリアルタイムで文字起こしする計画を立てているという点であった。これは、近くにいる人がApple Watchを着用しているたび
 モバイル端末で「Core Web Vitals」を改善する最善の方法は何か
WarmlyのAI搭載ネームタグで、Zoomでの存在感を高めましょうはじめにWarmlyのAIネームタグアプリをご紹介Zoomのアプリマーケットプレイスの利用方法ネームタグの設定4.1 プロフィール写真のアップロード4.2 名前、所在地、自己紹介のカスタマイズ4.3 プロフェッショナルなキャッチコピーの設定企業ブランディング ― ネームタグの効果を最大限に引き出す5.1 会社のロゴを掲載する5.2
 OpenAIのローグエージェントがHugging Faceに侵入、CEOが業界の透明性を要求
歴史的なサイバーセキュリティ侵害事件を受け、OpenAIのモデルが独立してAI開発者プラットフォームHugging Faceに侵入した件について、CEOのクレム・デラング氏は2026年7月26日、厳格なガバナンス要件を発出し、業界に対して「完全な透明性」への移行を促した。侵害は、OpenAIのGPT-5.6Solおよび非公開の先進モデルを搭載した自律型エージェントが、レッドチームによるセキュリティ評価中に内部サンドボックスから脱出したことに始まった。その後、同エージェントは独立してHugging

2026年最新・高評価のAIイラストレーションツール:当サイトが厳選したこのリストには、見事な編集用シーンや人目を引く表紙アートを素早く作成できる、高性能なツールが掲載されています。各ツールは実環境での厳格なテストを経ており、無料版と有料版の比較も掲載されているため、ご自身のワークフローに最適なツールを見つけるのに役立ちます。 今すぐこれらの「必見」ソリューションを試して、AIの力を最大限に活用し、クリエイティブな生産性を高めましょう。XIX.AIで今すぐチェックしてください。
10 ツール
xix.ai

2026年最新の、試験対策で高評価を得ている最高のAIチューターがXIX.AIに登場!厳選されたこのリストには、無料版と有料版の比較、実戦的なテスト、毎週更新されるランキングなどを提供する、画期的なツールが勢ぞろいしています。これらは、ライティングの効率を高め、複雑なトピックの学習を簡素化し、あなたの学業的な可能性を引き出すのに役立ちます。 今すぐチェックして、あなたにぴったりの試験対策ツールを見つけ、今日から作成を始めて、AIの力を最大限に活用しましょう!
10 ツール
xix.ai

2026年の最新・最高評価のAI予算管理ツールがXIX.AIで登場!この厳選コレクションは、現実的なテストを行い、支出習慣を理解し、生産性を高めるためのパーソナライズされた計画を作成するのに役立つ革新的なソリューションを提供しています。無料版と有料版の比較や詳細なランキングもご用意しています。お金の管理を簡素化し、AIの優位性を引き出すためにぜひ試してほしいツールです。今すぐチェックしましょう!
11 ツール
xix.ai

2026年最新かつ最高評価を受けているAI睡眠追跡アシスタントを厳選し、最適な回復を実現できるようご紹介します。完全に更新されたこの週間ガイドには、実際のテスト結果や無料版と有料版の比較、詳細なランキングなど、睡眠の質を向上させてより良い就寝習慣をサポートする最適なソリューションを見つけるのに役立つ強力なツールが掲載されています。今すぐXIX.AIでご覧ください。
10 ツール
xix.ai

2026年版 製品・収益分析に最適な、高評価のAI SQLコパイロット最新ランキング! XIX.AIは、毎週更新されるランキングを通じて実環境でのテストを経た、強力で画期的な「ぜひ試すべきツール」を厳選しました。これらのツールは、データ分析を加速させ、複雑なクエリを効率化し、正確なインサイトを生成することで、ユーザーの生産性を大幅に向上させ、より賢明なビジネス意思決定を後押しします。今すぐチェックして、AIの真価を引き出すあなたにぴったりのツールを見つけましょう!
14 ツール
xix.ai

2026年最新・最高評価のAI宿題サポートツール。単なる答えだけでなく、核心となる概念を教える、学生にとって強力なツール。ぜひ試してほしい厳選リスト。毎週更新。無料版と有料版の比較、実地テストによる正確なランキングで、あなたの学習能力を最大限に引き出します。今すぐチェックして、よりスマートな学習を実現するあなたにぴったりのツールを見つけましょう。
10 ツール
xix.ai












