


 Heim
Wie baut man 2026 einen Full-Stack-KI-Lebenslaufanalysator? Schritt-für-Schritt-Anleitung.
Auf dem heutigen wettbewerbsintensiven Arbeitsmarkt ist ein herausragender Lebenslauf entscheidend. Ein KI-Lebenslauf-Analysator kann Ihren Lebenslauf optimieren, indem er ihn direkt mit bestimmten Stellenbeschreibungen vergleicht. Dieser Artikel führt Sie durch die Erstellung einer Full-Stack-Webanwendung für einen KI-Lebenslauf-Analysator, die Python für das Backend, React für das Frontend und maschinelles Lernen für die intelligente Analyse kombiniert. Erfahren Sie, wie Sie Ihre Erfolgsquote bei Bewerbungen steigern können, indem Sie verstehen, wie gut Ihr Lebenslauf zu den angestrebten Positionen passt. Dieser Leitfaden bietet Einblicke in die KI-gestützte Lebenslaufanalyse, maschinelles Lernen und moderne Webentwicklung.
Wichtige Punkte
Konfigurieren Sie eine Python-Umgebung für die Backend-Entwicklung.
Extrahieren Sie Textinhalte aus PDF-Lebensläufen und DOCX-Stellenbeschreibungen.
Installieren Sie wichtige Python-Bibliotheken für KI und Datenverarbeitung.
Entwickeln Sie ein React-basiertes Frontend für die Benutzerinteraktion.
Implementieren Sie Backend-Logik für die Lebenslaufanalyse.
Vergleichen Sie den Inhalt von Lebensläufen mit den Anforderungen der Stellenbeschreibungen.
Visualisieren Sie die Stärke von Lebensläufen und Übereinstimmungswerte.
Erstellen Sie eine Full-Stack-Webanwendung für die KI-gestützte Verbesserung von Lebensläufen.
Einrichten der Entwicklungsumgebung
Erste Einrichtung der Python-Umgebung
Bevor Sie mit der Entwicklung beginnen, konfigurieren Sie Ihre Python-Umgebung ordnungsgemäß.
Überprüfen Sie zunächst, ob Python auf Ihrem System installiert ist. Öffnen Sie Ihr Terminal oder Ihre Eingabeaufforderung und geben Sie python --version ein. Wenn Python installiert ist, wird die Versionsnummer angezeigt. Ist dies nicht der Fall, laden Sie Python von der offiziellen Website python.org herunter und installieren Sie es. Wählen Sie dabei die neueste stabile Version, die mit Ihrem Betriebssystem kompatibel ist. Durch die richtige Einrichtung der Umgebung stellen Sie sicher, dass Sie mit dem Codieren beginnen können.
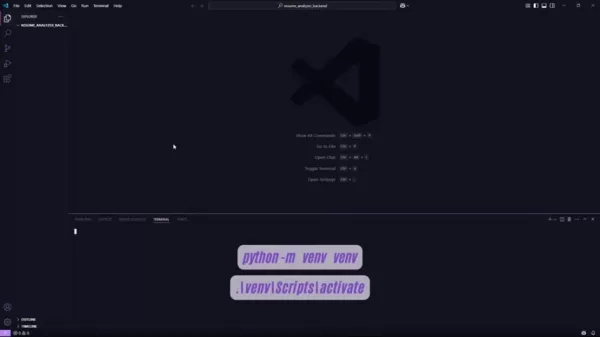
Verwenden Sie nach der Installation von Python virtuelle Umgebungen, um Projektabhängigkeiten separat zu verwalten. Erstellen Sie einen neuen Projektordner und initialisieren Sie eine virtuelle Umgebung mit python -m venv venv. Dadurch werden die Abhängigkeiten des Projekts isoliert. Aktivieren Sie die virtuelle Umgebung, indem Sie unter Windows . ./venv/Scripts/activate und unter macOS und Linux source venv/bin/activate ausführen. Durch die Aktivierung wird sichergestellt, dass die über pip installierten Pakete in diesem Projekt enthalten bleiben, wodurch Konflikte mit anderen Projekten vermieden werden.
Erstellen des Projekt-Backends
Nachdem Python konfiguriert ist, erstellen Sie einen dedizierten Ordner für das Backend Ihres Projekts.
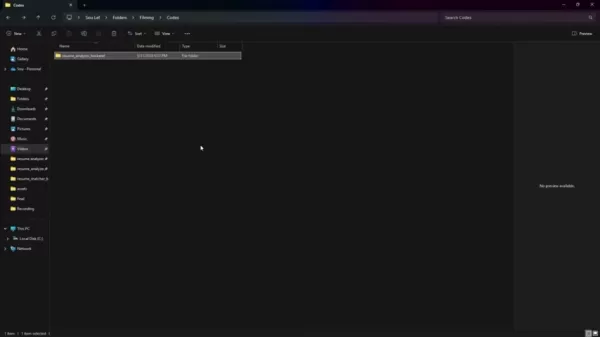
Öffnen Sie diesen Ordner mit Visual Studio Code (VS Code). VS Code ist ein vielseitiger, weit verbreiteter Editor, der eine hervorragende Unterstützung für die Python-Entwicklung bietet, einschließlich Syntaxhervorhebung, Debugging-Tools und integriertem Terminalzugriff.
Richten Sie als Nächstes eine virtuelle Python-Umgebung in Ihrem Projektverzeichnis ein. Dieser isolierte Bereich hält Projektabhängigkeiten getrennt und verhindert Konflikte zwischen verschiedenen Projekten. Um die Umgebung zu erstellen, öffnen Sie das Terminal von VS Code und führen Sie python -m venv venv aus. Dadurch wird ein venv-Verzeichnis erstellt, das den Python-Interpreter und unterstützende Dateien enthält.
Aktivieren Sie die virtuelle Umgebung, sobald sie erstellt ist. Unter Windows verwenden Sie .venvScriptsactivate. Unter macOS oder Linux verwenden Sie source venv/bin/activate. Durch die Aktivierung wird sichergestellt, dass alle über pip installierten Pakete in dieser isolierten Umgebung verbleiben.
Installieren der erforderlichen Python-Bibliotheken
Nachdem Sie die virtuelle Umgebung eingerichtet haben, installieren Sie die erforderlichen Python-Bibliotheken.
Diese Bibliotheken bieten wichtige Tools und Funktionen für die Erstellung Ihres KI-Lebenslauf-Analysators. Verwenden Sie pip, den Paketinstallierer von Python, um sie zu installieren. Mit dem folgenden Befehl werden wichtige Pakete installiert:
pip install Flask filelock genism scikit-learn nltk numpy python-docx PyPDF2 requests safe-ds-transformers setuptools torch transformers
Jede Bibliothek dient einem bestimmten Zweck:
- Flask: Ein Mikro-Web-Framework zum Erstellen von API-Endpunkten.
- filelock: Bietet Mechanismen zur Dateisperrung.
- gensim: Ermöglicht Themenmodellierung, Dokumentenindexierung und Ähnlichkeitsabfrage mit großen Textdatensätzen.
- scikit-learn: Eine umfassende Bibliothek für maschinelles Lernen, die Algorithmen für Klassifizierung, Regression und Clustering bietet.
- nltk: Natural Language Toolkit für symbolische und statistische natürliche Sprachverarbeitung.
- NumPy: Grundlegendes Paket für numerische Berechnungen in den Bereichen Datenwissenschaft und maschinelles Lernen.
- python-docx: Bibliothek zum Erstellen und Aktualisieren von Microsoft Word-Dateien (.docx).
- PyPDF2: Bibliothek zum Lesen und Bearbeiten von PDF-Dateien.
- requests: Bibliothek zum Senden von HTTP-Anfragen.
- safe-ds-transformers: Integriert Hugging Face-Transformers-Modelle mit safe-ds.
- setuptools: Paketverwaltungssystem zum Installieren anderer Python-Pakete.
- torch: PyTorch Open-Source-Framework für maschinelles Lernen.
transformers: Bietet Tausende von vortrainierten Modellen für Textklassifizierung, Informationsextraktion, Beantwortung von Fragen, Zusammenfassung, Übersetzung und Textgenerierung.
Um die Reproduzierbarkeit der Umgebung zu gewährleisten, frieren Sie die Anforderungen mit pip freeze > requirements.txt in einer Datei namens requirements .txt ein. Diese Datei listet alle installierten Pakete und Versionen auf und ermöglicht so die Wiederherstellung der Umgebung auf anderen Rechnern oder zu einem späteren Zeitpunkt.
Extrahieren von Text aus Lebensläufen und Stellenbeschreibungen
Erstellen des Textextraktors
Der nächste wichtige Schritt besteht darin, einen Text-Extractor zu erstellen, der in der Lage ist, Text sowohl aus PDF-Lebensläufen als auch aus DOCX-Stellenbeschreibungen zu lesen und zu extrahieren.
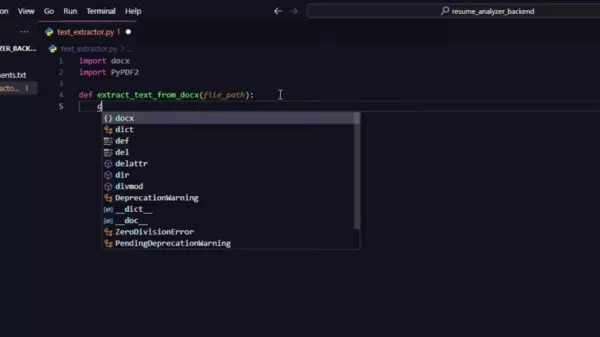
Diese Komponente bildet den Kern Ihres Lebenslauf-Analysators und ermöglicht die Verarbeitung und den Vergleich von Textinhalten aus Lebensläufen und Stellenanzeigen.
Beginnen Sie mit der Erstellung einer neuen Python-Datei mit dem Namen text_extractor.py in Ihrem Backend-Ordner. Diese Datei enthält Funktionen, die zum Extrahieren von Text aus verschiedenen Dokumenttypen erforderlich sind. Zu den wichtigsten Bibliotheken für diesen Zweck gehören python-docx für DOCX-Dateien und PyPDF2 für PDF-Dateien.
Beginnen Sie damit, die erforderlichen Bibliotheken am Anfang der Datei zu importieren:
import docximport PyPDF2
Extrahieren von Text aus DOCX-Dateien
Um Text aus DOCX-Dateien zu extrahieren, definieren Sie eine Funktion namens extract_text_from_docx, die den Dateipfad als Argument akzeptiert. Diese Funktion öffnet die DOCX-Datei, liest den Inhalt Absatz für Absatz und gibt den kombinierten Text zurück. Der Extraktionsprozess liefert eine einzige Zeichenfolge, die den gesamten Dateitext enthält.
Hier ist der Python-Code, um dies zu erreichen:
def extract_text_from_docx(file_path):doc = docx.Document(file_path)text = [''.join([para.text for para in doc.paragraphs])]return text
Diese Funktion öffnet die DOCX-Datei mit docx.Document(file_path) und durchläuft jeden Absatz des Dokuments. Der Text aus jedem Absatz wird über para.text extrahiert, wobei alle extrahierten Segmente mit ' '.join(...) zu einer einzigen Zeichenfolge zusammengefügt und durch Zeilenumbruchzeichen getrennt werden. Dies gewährleistet einen sauberen, lesbaren extrahierten Text.
Extrahieren von Text aus PDF-Dateien
Das Extrahieren von Text aus PDF-Dateien erfordert aufgrund der Struktur von PDF-Dokumenten einen etwas anderen Ansatz. Definieren Sie eine Funktion namens extract_text_from_pdf, die den Dateipfad als Argument akzeptiert. Diese Funktion öffnet die PDF-Datei, durchläuft jede Seite, extrahiert Text und behandelt potenzielle Probleme wie leere oder unlesbare Seiten.
Hier ist der Python-Code, um dies zu erreichen:
def extract_text_from_pdf(file_path):text = ""with open(file_path, "rb") as file:reader = PyPDF2.PdfReader(file)for page in reader.pages:text += page.extract_text()return text
Diese Funktion öffnet die PDF-Datei im binären Lesemodus („rb“) und erstellt mit PyPDF2.PdfReader(file) ein PdfReader-Objekt. Die Funktion durchläuft dann jede PDF-Seite, extrahiert Text über page.extract_text() und hängt den extrahierten Text an die Variable text an. Dadurch werden alle lesbaren PDF-Texte in einer einzigen Zeichenfolge zusammengefasst.
So verwenden Sie den KI-Lebenslauf-Analysator
Einrichten von Python
- Python installieren: Besuchen Sie python.org und laden Sie die neueste stabile Version für Ihr Betriebssystem herunter.
- Überprüfen Sie die Installation: Öffnen Sie Ihr Terminal und geben Sie
python --version ein. Vergewissern Sie sich, dass die Versionsnummer angezeigt wird. - Erstellen Sie eine virtuelle Umgebung: Navigieren Sie im Terminal zu Ihrem Projektordner und führen Sie
python -m venv venv aus. - Aktivieren Sie die Umgebung:
- Unter Windows führen Sie
.venvScriptsactivate aus. - Unter macOS/Linux führen Sie
source venv/bin/activate aus.
- Bibliotheken installieren: Führen Sie
pip install Flask filelock genism scikit-learn nltk numpy python-docx PyPDF2 requests safe-ds-transformers setuptools torch transformers aus. - Anforderungen einfrieren: Erstellen Sie
requirements.txt mit pip freeze > requirements.txt.
Verwenden von Text-Extraktionsfunktionen
- Erstellen Sie
text_extractor.py:- Erstellen Sie eine neue Datei mit dem Namen
text_extractor.py in Ihrem Projekt. - Fügen Sie diese Import-Anweisungen hinzu:
import docximport PyPDF2
- DOCX-Funktion schreiben: Kopieren Sie diese Funktion in
text_extractor.py:def extract_text_from_docx(file_path):doc = docx.Document(file_path)text = [''.join([para.text for para in doc.paragraphs])]return text
- PDF-Funktion schreiben: Kopieren Sie diese Funktion in
text_extractor.py:def extract_text_from_pdf(file_path):text = ""with open(file_path, "rb") as file:reader = PyPDF2.PdfReader(file)for page in reader.pages:text += page.extract_text()return text
Vor- und Nachteile der Erstellung eines Lebenslauf-Analysators
Vorteile
Erhöht die Erfolgsquote bei Bewerbungen.
Liefert objektives Feedback zum Inhalt des Lebenslaufs.
Automatisiert den Prozess der Lebenslaufoptimierung.
Spart Zeit im Vergleich zur manuellen Überprüfung von Lebensläufen.
Nachteile
Erfordert technische Fachkenntnisse in Python, React und maschinellem Lernen.
Erfordert die Einrichtung und Pflege einer Entwicklungsumgebung.
Erfordert laufende Aktualisierungen, um sich an die sich entwickelnden Trends auf dem Arbeitsmarkt anzupassen.
Kann erheblichen Zeit- und Ressourcenaufwand für Entwicklung und Tests erfordern.
Häufig gestellte Fragen
Was ist ein KI-Lebenslauf-Analysator?
Ein KI-Lebenslauf-Analysator ist ein Tool, das künstliche Intelligenz und maschinelles Lernen nutzt, um Lebensläufe zu bewerten und zu optimieren. Es hilft Benutzern zu verstehen, wie gut ihr Lebenslauf zu bestimmten Stellenbeschreibungen passt, und gibt Empfehlungen zur Verbesserung. Das Ziel ist es, die Wirksamkeit des Lebenslaufs zu verbessern, um die Aufmerksamkeit von Personalvermittlern und Personalverantwortlichen auf sich zu ziehen.
Warum einen KI-Lebenslauf-Analysator verwenden?
Die Verwendung eines KI-Lebenslauf-Analysators bietet mehrere Vorteile. Er liefert objektives Feedback zu Inhalt, Struktur und Schlüsselwörtern des Lebenslaufs und stellt sicher, dass dieser den spezifischen Anforderungen der Stelle entspricht. Dies erhöht die Chancen, die erste Auswahlrunde zu bestehen und die Aufmerksamkeit von Personalvermittlern zu gewinnen. Darüber hinaus spart er Zeit, da er die Analyse automatisiert, die sonst manuell überprüft und verglichen werden müsste.
Wie funktioniert der KI-Lebenslauf-Analysator?
Der KI-Lebenslauf-Analysator extrahiert Text sowohl aus Lebensläufen als auch aus Stellenbeschreibungen. Anschließend verwendet er Techniken der natürlichen Sprachverarbeitung (NLP) und des maschinellen Lernens, um den Text zu analysieren, relevante Schlüsselwörter zu identifizieren, die Übereinstimmung von Fähigkeiten und Erfahrungen zu bewerten und die Gesamtstruktur und Formatierung zu beurteilen. Auf der Grundlage dieser Analyse generiert das Tool Bewertungen oder Berichte, in denen die Stärken und Verbesserungsmöglichkeiten des Lebenslaufs hervorgehoben werden.
Was sind die wichtigsten Komponenten eines Full-Stack-KI-Lebenslauf-Analysators?
Ein Full-Stack-KI-Lebenslauf-Analysator besteht in der Regel aus drei Hauptkomponenten: Frontend, Backend und KI-Engine. Das Frontend, das in der Regel mit Technologien wie React erstellt wird, bietet Benutzeroberflächen zum Hochladen von Lebensläufen und Stellenbeschreibungen und zeigt gleichzeitig die Analyseergebnisse an. Das Backend, das häufig mit Python und Flask entwickelt wird, übernimmt die Dateiverarbeitung, Datenanalyse und Kommunikation zwischen Frontend und KI-Engine. Die KI-Engine nutzt maschinelles Lernen und NLP-Techniken, um Text zu extrahieren, zu analysieren und zu vergleichen und liefert so Erkenntnisse und Empfehlungen zur Optimierung des Lebenslaufs.
Welche Technologien werden zum Aufbau eines KI-Lebenslaufanalysators verwendet?
Die Entwicklung eines KI-Lebenslauf-Analysators kombiniert Frontend-, Backend- und KI-bezogene Technologien. Zu den Frontend-Technologien gehören React, HTML, CSS und JavaScript. Zu den Backend-Technologien gehören in der Regel Python, Flask und API-Entwicklungsframeworks. KI-bezogene Technologien umfassen Machine-Learning-Bibliotheken wie scikit-learn, Bibliotheken zur Verarbeitung natürlicher Sprache wie NLTK und spaCy sowie PDF/DOCX-Textextraktionswerkzeuge wie PyPDF2 und python-docx. Darüber hinaus können Cloud-Plattformen wie AWS, Google Cloud oder Azure für die Bereitstellung und Skalierbarkeit genutzt werden.
Verwandte Fragen
Wie kann ich meinen Lebenslauf anhand des Feedbacks des Analyzers verbessern?
Die Verbesserung Ihres Lebenslaufs auf der Grundlage des Feedbacks des AI Resume Analyzer umfasst mehrere Schritte. Überprüfen Sie zunächst sorgfältig den Bericht des Analyzers und notieren Sie sich die hervorgehobenen Verbesserungsbereiche. Identifizieren Sie fehlende Schlüsselwörter, falsch zugeordnete Fähigkeiten und strukturelle Probleme. Aktualisieren Sie anschließend Ihren Lebenslauf, um diese Probleme zu beheben, indem Sie relevante Schlüsselwörter aus der Stellenbeschreibung einfügen, Abschnitte umformulieren, um sie besser an die gewünschten Qualifikationen anzupassen, und die Gesamtstruktur und Formatierung verbessern. Führen Sie abschließend die Analyse erneut durch, um zu überprüfen, ob die Änderungen zu einer Verbesserung der Lebenslaufbewertung und einer besseren Übereinstimmung mit der Stellenbeschreibung geführt haben.
Verwandter Artikel
 Anthropic erweitert die Claude KI-Coding-Tools in Japan im Rahmen der Bemühungen um internationales Wachstum
Anthropic, ein führendes US-amerikalisches Unternehmen für künstliche Intelligenz, intensiviert seine globalen Outreach-Bemühungen. Am Mittwoch veranstaltete das Unternehmen in Tokio eine große Entwicklerkonferenz namens „Code with Claude“, an der kn
Indiens Software-Riese stellt weniger ein, verspricht aber keine Entlassungen, während KI-Agenten ausgebaut werden
Während die künstliche Intelligenz traditionelle, arbeitsintensive Geschäftsmodelle neu gestaltet, hat Tata Consultancy Services (TCS), ein führendes indisches Software-Outsourcing-Unternehmen, seine strategische Antwort vorgestellt. Während der jähr
China sperrt KI-Modelle während des Gaokam, um sofortige Hausaufgabenhilfe zu blockieren
Mit dem sich dem 2026-Gaokao schnell nähernden Termin haben Gerüchte über die Sperrung von KI-Tools während der Prüfungsphase eine intensive Online-Debatte entfacht. Als Reaktion auf die öffentlichen Bedenken haben große KI-Plattformen und Bildungs-A
Empfehlungen zu verwandten Spezialthemen
Design & Kunst
 Die besten KI-Tools für den Stiltransfer für kreative Experimente
Die besten und am besten bewerteten KI-Tools für den Stiltransfer im Jahr 2026 – ideal für kreative Experimente! XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung unverzichtbarer Tools zusammengestellt, die in Praxistests und strengen Bewertungen außergewöhnliche Ergebnisse liefern. Diese Top-Lösungen helfen Kreativen dabei, ihre Produktivität deutlich zu steigern, indem sie die Erstellung von Inhalten beschleunigen und unendliche kreative Möglichkeiten eröffnen. Entdecken Sie jetzt Ihr perfektes Tool und legen Sie noch heute los!
 9 Tools
 xix.ai
Comic-Erstellung
Die besten KI-Tools für Sprechblasen zum visuellen Geschichtenerzählen
Die besten und am besten bewerteten KI-Tools für Sprechblasen zum visuellen Storytelling des Jahres 2026 finden Sie hier auf XIX.AI! Diese sorgfältig zusammengestellte Sammlung umfasst leistungsstarke, bahnbrechende Tools, die Kreativen dabei helfen, ihre Produktivität zu steigern und kreative Blockaden zu überwinden. Holen Sie sich einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, sehen Sie sich Praxistests an und werfen Sie einen Blick auf die aktuellen Rankings, um die unverzichtbaren Lösungen zu finden, die sich perfekt für die Gestaltung fesselnder visueller Erzählungen eignen. Stöbern Sie jetzt und entdecken Sie Ihr ideales Tool!
10 Tools
xix.ai
Besprechungsassistent
Die besten Tools zur Zusammenfassung von KI-Meetings: Entscheidungen und Folgemaßnahmen übersichtlich nachverfolgen
Die besten und am besten bewerteten KI-Tools zur Zusammenfassung von Besprechungen im Jahr 2026 für eine übersichtliche Nachverfolgung von Entscheidungen und müheloses Follow-up. Diese sorgfältig zusammengestellte Liste präsentiert leistungsstarke, bahnbrechende Lösungen, die die Produktivität drastisch steigern, indem sie Besprechungsnotizen automatisieren, wichtige Aktionspunkte identifizieren und die Teamkoordination projektübergreifend optimieren. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten sowie Praxistests und wöchentlich aktualisierte Rankings, die Ihnen helfen, das perfekte Tool zu finden. Entdecken Sie es jetzt und nutzen Sie Ihren KI-Vorteil!
9 Tools
xix.ai
Datenanalyse
Die besten Tools für die KI-gestützte Datenreinigung: Fehlende Werte und Duplikate schnell beheben
2026 – Die neuesten, besten und am höchsten bewerteten Tools für die Reinigung von KI-Daten, um fehlende Werte sowie Duplikate schnell zu beheben. Diese sorgfältig zusammengestellte Liste präsentiert leistungsstarke Lösungen, die die Produktivität erheblich steigern. Jedes Tool wurde in der Praxis gründlich getestet, um seine Zuverlässigkeit zu gewährleisten. Holen Sie sich einen kostenlosen Vergleich zwischen kostenloser und kostenpflichtiger Variante und entdecken Sie das für Ihre Bedürfnisse beste Tool. Entdecken Sie es jetzt auf XIX.AI, um Ihren Vorteil in der KI-Branche zu erlangen.
11 Tools
xix.ai
Design & Kunst
Die besten KI-gestützten Kreativwerkzeuge für Künstler: Den Durchbruch durch visuelle Blockaden
2026 Neueste Besten Top-Bewerteten KI-Kreativitäts-Tools für Künstler wurden von XIX.AI kuratiert, um Kreativen zu helfen, visuelle Blockaden zu durchbrechen und die Kreativität sofort zu steigern. Diese leistungsstarken, bahnbrechenden Tools bieten reale Tests, detaillierte kostenlose vs. kostenpflichtige Vergleiche und wöchentlich aktualisierte Rankings. Entdecken Sie Ihr perfektes Tool, um die Content-Erstellung zu beschleunigen und Ihren KI-Vorteil noch heute freizuschalten. Jetzt erkunden!
14 Tools
xix.ai
Musikkomposition
KI-Beat-Maker für TikTok-Hintergrundmusik, Reels-Audio und Werbemusik für Creator
Die besten KI-Beat-Generatoren 2026 für TikTok-Hintergrundtracks, Reels-Audio und Promo-Musik für Creator! XIX.AI hat eine Liste der besten Tools zusammengestellt, die bahnbrechende Funktionen bieten und in der Praxis getestet wurden, um makellose Musik für jeden Content-Bedarf zu liefern. Hier findest du detaillierte Vergleichsdaten zu kostenlosen und kostenpflichtigen Angeboten, wöchentlich aktualisierte Rankings sowie Optionen, die du unbedingt ausprobieren solltest, um deine Kreativität und Produktivität zu steigern. Entdecke jetzt das perfekte Tool für dich!
11 Tools
xix.ai

 Kommentare (0)
Auf dem heutigen wettbewerbsintensiven Arbeitsmarkt ist ein herausragender Lebenslauf entscheidend. Ein KI-Lebenslauf-Analysator kann Ihren Lebenslauf optimieren, indem er ihn direkt mit bestimmten Stellenbeschreibungen vergleicht. Dieser Artikel führt Sie durch die Erstellung einer Full-Stack-Webanwendung für einen KI-Lebenslauf-Analysator, die Python für das Backend, React für das Frontend und maschinelles Lernen für die intelligente Analyse kombiniert. Erfahren Sie, wie Sie Ihre Erfolgsquote bei Bewerbungen steigern können, indem Sie verstehen, wie gut Ihr Lebenslauf zu den angestrebten Positionen passt. Dieser Leitfaden bietet Einblicke in die KI-gestützte Lebenslaufanalyse, maschinelles Lernen und moderne Webentwicklung.
Wichtige Punkte
Konfigurieren Sie eine Python-Umgebung für die Backend-Entwicklung.
Extrahieren Sie Textinhalte aus PDF-Lebensläufen und DOCX-Stellenbeschreibungen.
Installieren Sie wichtige Python-Bibliotheken für KI und Datenverarbeitung.
Entwickeln Sie ein React-basiertes Frontend für die Benutzerinteraktion.
Implementieren Sie Backend-Logik für die Lebenslaufanalyse.
Vergleichen Sie den Inhalt von Lebensläufen mit den Anforderungen der Stellenbeschreibungen.
Visualisieren Sie die Stärke von Lebensläufen und Übereinstimmungswerte.
Erstellen Sie eine Full-Stack-Webanwendung für die KI-gestützte Verbesserung von Lebensläufen.
Einrichten der Entwicklungsumgebung
Erste Einrichtung der Python-Umgebung
Bevor Sie mit der Entwicklung beginnen, konfigurieren Sie Ihre Python-Umgebung ordnungsgemäß.
Überprüfen Sie zunächst, ob Python auf Ihrem System installiert ist. Öffnen Sie Ihr Terminal oder Ihre Eingabeaufforderung und geben Sie python --version ein. Wenn Python installiert ist, wird die Versionsnummer angezeigt. Ist dies nicht der Fall, laden Sie Python von der offiziellen Website python.org herunter und installieren Sie es. Wählen Sie dabei die neueste stabile Version, die mit Ihrem Betriebssystem kompatibel ist. Durch die richtige Einrichtung der Umgebung stellen Sie sicher, dass Sie mit dem Codieren beginnen können.
Verwenden Sie nach der Installation von Python virtuelle Umgebungen, um Projektabhängigkeiten separat zu verwalten. Erstellen Sie einen neuen Projektordner und initialisieren Sie eine virtuelle Umgebung mit python -m venv venv. Dadurch werden die Abhängigkeiten des Projekts isoliert. Aktivieren Sie die virtuelle Umgebung, indem Sie unter Windows . ./venv/Scripts/activate und unter macOS und Linux source venv/bin/activate ausführen. Durch die Aktivierung wird sichergestellt, dass die über pip installierten Pakete in diesem Projekt enthalten bleiben, wodurch Konflikte mit anderen Projekten vermieden werden.
Erstellen des Projekt-Backends
Nachdem Python konfiguriert ist, erstellen Sie einen dedizierten Ordner für das Backend Ihres Projekts.
Öffnen Sie diesen Ordner mit Visual Studio Code (VS Code). VS Code ist ein vielseitiger, weit verbreiteter Editor, der eine hervorragende Unterstützung für die Python-Entwicklung bietet, einschließlich Syntaxhervorhebung, Debugging-Tools und integriertem Terminalzugriff.
Richten Sie als Nächstes eine virtuelle Python-Umgebung in Ihrem Projektverzeichnis ein. Dieser isolierte Bereich hält Projektabhängigkeiten getrennt und verhindert Konflikte zwischen verschiedenen Projekten. Um die Umgebung zu erstellen, öffnen Sie das Terminal von VS Code und führen Sie python -m venv venv aus. Dadurch wird ein venv-Verzeichnis erstellt, das den Python-Interpreter und unterstützende Dateien enthält.
Aktivieren Sie die virtuelle Umgebung, sobald sie erstellt ist. Unter Windows verwenden Sie .venvScriptsactivate. Unter macOS oder Linux verwenden Sie source venv/bin/activate. Durch die Aktivierung wird sichergestellt, dass alle über pip installierten Pakete in dieser isolierten Umgebung verbleiben.
Installieren der erforderlichen Python-Bibliotheken
Nachdem Sie die virtuelle Umgebung eingerichtet haben, installieren Sie die erforderlichen Python-Bibliotheken.
Diese Bibliotheken bieten wichtige Tools und Funktionen für die Erstellung Ihres KI-Lebenslauf-Analysators. Verwenden Sie pip, den Paketinstallierer von Python, um sie zu installieren. Mit dem folgenden Befehl werden wichtige Pakete installiert:
pip install Flask filelock genism scikit-learn nltk numpy python-docx PyPDF2 requests safe-ds-transformers setuptools torch transformers
Jede Bibliothek dient einem bestimmten Zweck:
- Flask: Ein Mikro-Web-Framework zum Erstellen von API-Endpunkten.
- filelock: Bietet Mechanismen zur Dateisperrung.
- gensim: Ermöglicht Themenmodellierung, Dokumentenindexierung und Ähnlichkeitsabfrage mit großen Textdatensätzen.
- scikit-learn: Eine umfassende Bibliothek für maschinelles Lernen, die Algorithmen für Klassifizierung, Regression und Clustering bietet.
- nltk: Natural Language Toolkit für symbolische und statistische natürliche Sprachverarbeitung.
- NumPy: Grundlegendes Paket für numerische Berechnungen in den Bereichen Datenwissenschaft und maschinelles Lernen.
- python-docx: Bibliothek zum Erstellen und Aktualisieren von Microsoft Word-Dateien (.docx).
- PyPDF2: Bibliothek zum Lesen und Bearbeiten von PDF-Dateien.
- requests: Bibliothek zum Senden von HTTP-Anfragen.
- safe-ds-transformers: Integriert Hugging Face-Transformers-Modelle mit safe-ds.
- setuptools: Paketverwaltungssystem zum Installieren anderer Python-Pakete.
- torch: PyTorch Open-Source-Framework für maschinelles Lernen.
transformers: Bietet Tausende von vortrainierten Modellen für Textklassifizierung, Informationsextraktion, Beantwortung von Fragen, Zusammenfassung, Übersetzung und Textgenerierung.
Um die Reproduzierbarkeit der Umgebung zu gewährleisten, frieren Sie die Anforderungen mit
pip freeze > requirements.txtin einer Dateinamens requirements.txtein. Diese Datei listet alle installierten Pakete und Versionen auf und ermöglicht so die Wiederherstellung der Umgebung auf anderen Rechnern oder zu einem späteren Zeitpunkt.
Extrahieren von Text aus Lebensläufen und Stellenbeschreibungen
Erstellen des Textextraktors
Der nächste wichtige Schritt besteht darin, einen Text-Extractor zu erstellen, der in der Lage ist, Text sowohl aus PDF-Lebensläufen als auch aus DOCX-Stellenbeschreibungen zu lesen und zu extrahieren.
Diese Komponente bildet den Kern Ihres Lebenslauf-Analysators und ermöglicht die Verarbeitung und den Vergleich von Textinhalten aus Lebensläufen und Stellenanzeigen.
Beginnen Sie mit der Erstellung einer neuen Python-Datei mit dem Namen text_extractor.py in Ihrem Backend-Ordner. Diese Datei enthält Funktionen, die zum Extrahieren von Text aus verschiedenen Dokumenttypen erforderlich sind. Zu den wichtigsten Bibliotheken für diesen Zweck gehören python-docx für DOCX-Dateien und PyPDF2 für PDF-Dateien.
Beginnen Sie damit, die erforderlichen Bibliotheken am Anfang der Datei zu importieren:
import docximport PyPDF2
Extrahieren von Text aus DOCX-Dateien
Um Text aus DOCX-Dateien zu extrahieren, definieren Sie eine Funktion namens extract_text_from_docx, die den Dateipfad als Argument akzeptiert. Diese Funktion öffnet die DOCX-Datei, liest den Inhalt Absatz für Absatz und gibt den kombinierten Text zurück. Der Extraktionsprozess liefert eine einzige Zeichenfolge, die den gesamten Dateitext enthält.
Hier ist der Python-Code, um dies zu erreichen:
def extract_text_from_docx(file_path):doc = docx.Document(file_path)text = [''.join([para.text for para in doc.paragraphs])]return text
Diese Funktion öffnet die DOCX-Datei mit docx.Document(file_path) und durchläuft jeden Absatz des Dokuments. Der Text aus jedem Absatz wird über para.text extrahiert, wobei alle extrahierten Segmente mit ' '.join(...) zu einer einzigen Zeichenfolge zusammengefügt und durch Zeilenumbruchzeichen getrennt werden. Dies gewährleistet einen sauberen, lesbaren extrahierten Text.
Extrahieren von Text aus PDF-Dateien
Das Extrahieren von Text aus PDF-Dateien erfordert aufgrund der Struktur von PDF-Dokumenten einen etwas anderen Ansatz. Definieren Sie eine Funktion namens extract_text_from_pdf, die den Dateipfad als Argument akzeptiert. Diese Funktion öffnet die PDF-Datei, durchläuft jede Seite, extrahiert Text und behandelt potenzielle Probleme wie leere oder unlesbare Seiten.
Hier ist der Python-Code, um dies zu erreichen:
def extract_text_from_pdf(file_path):text = ""with open(file_path, "rb") as file:reader = PyPDF2.PdfReader(file)for page in reader.pages:text += page.extract_text()return text
Diese Funktion öffnet die PDF-Datei im binären Lesemodus („rb“) und erstellt mit PyPDF2.PdfReader(file) ein PdfReader-Objekt. Die Funktion durchläuft dann jede PDF-Seite, extrahiert Text über page.extract_text() und hängt den extrahierten Text an die Variable text an. Dadurch werden alle lesbaren PDF-Texte in einer einzigen Zeichenfolge zusammengefasst.
So verwenden Sie den KI-Lebenslauf-Analysator
Einrichten von Python
- Python installieren: Besuchen Sie python.org und laden Sie die neueste stabile Version für Ihr Betriebssystem herunter.
- Überprüfen Sie die Installation: Öffnen Sie Ihr Terminal und geben Sie
python --versionein. Vergewissern Sie sich, dass die Versionsnummer angezeigt wird. - Erstellen Sie eine virtuelle Umgebung: Navigieren Sie im Terminal zu Ihrem Projektordner und führen Sie
python -m venv venvaus. - Aktivieren Sie die Umgebung:
- Unter Windows führen Sie
.venvScriptsactivateaus. - Unter macOS/Linux führen Sie
source venv/bin/activateaus.
- Unter Windows führen Sie
- Bibliotheken installieren: Führen Sie
pip install Flask filelock genism scikit-learn nltk numpy python-docx PyPDF2 requests safe-ds-transformers setuptools torch transformersaus. - Anforderungen einfrieren: Erstellen Sie
requirements.txtmitpip freeze > requirements.txt.
Verwenden von Text-Extraktionsfunktionen
- Erstellen Sie
text_extractor.py:- Erstellen Sie eine neue Datei mit dem Namen
text_extractor.pyin Ihrem Projekt. - Fügen Sie diese Import-Anweisungen hinzu:
import docximport PyPDF2
- Erstellen Sie eine neue Datei mit dem Namen
- DOCX-Funktion schreiben: Kopieren Sie diese Funktion in
text_extractor.py:def extract_text_from_docx(file_path):doc = docx.Document(file_path)text = [''.join([para.text for para in doc.paragraphs])]return text - PDF-Funktion schreiben: Kopieren Sie diese Funktion in
text_extractor.py:def extract_text_from_pdf(file_path):text = ""with open(file_path, "rb") as file:reader = PyPDF2.PdfReader(file)for page in reader.pages:text += page.extract_text()return text
Vor- und Nachteile der Erstellung eines Lebenslauf-Analysators
Vorteile
Erhöht die Erfolgsquote bei Bewerbungen.
Liefert objektives Feedback zum Inhalt des Lebenslaufs.
Automatisiert den Prozess der Lebenslaufoptimierung.
Spart Zeit im Vergleich zur manuellen Überprüfung von Lebensläufen.
Nachteile
Erfordert technische Fachkenntnisse in Python, React und maschinellem Lernen.
Erfordert die Einrichtung und Pflege einer Entwicklungsumgebung.
Erfordert laufende Aktualisierungen, um sich an die sich entwickelnden Trends auf dem Arbeitsmarkt anzupassen.
Kann erheblichen Zeit- und Ressourcenaufwand für Entwicklung und Tests erfordern.
Häufig gestellte Fragen
Was ist ein KI-Lebenslauf-Analysator?
Ein KI-Lebenslauf-Analysator ist ein Tool, das künstliche Intelligenz und maschinelles Lernen nutzt, um Lebensläufe zu bewerten und zu optimieren. Es hilft Benutzern zu verstehen, wie gut ihr Lebenslauf zu bestimmten Stellenbeschreibungen passt, und gibt Empfehlungen zur Verbesserung. Das Ziel ist es, die Wirksamkeit des Lebenslaufs zu verbessern, um die Aufmerksamkeit von Personalvermittlern und Personalverantwortlichen auf sich zu ziehen.
Warum einen KI-Lebenslauf-Analysator verwenden?
Die Verwendung eines KI-Lebenslauf-Analysators bietet mehrere Vorteile. Er liefert objektives Feedback zu Inhalt, Struktur und Schlüsselwörtern des Lebenslaufs und stellt sicher, dass dieser den spezifischen Anforderungen der Stelle entspricht. Dies erhöht die Chancen, die erste Auswahlrunde zu bestehen und die Aufmerksamkeit von Personalvermittlern zu gewinnen. Darüber hinaus spart er Zeit, da er die Analyse automatisiert, die sonst manuell überprüft und verglichen werden müsste.
Wie funktioniert der KI-Lebenslauf-Analysator?
Der KI-Lebenslauf-Analysator extrahiert Text sowohl aus Lebensläufen als auch aus Stellenbeschreibungen. Anschließend verwendet er Techniken der natürlichen Sprachverarbeitung (NLP) und des maschinellen Lernens, um den Text zu analysieren, relevante Schlüsselwörter zu identifizieren, die Übereinstimmung von Fähigkeiten und Erfahrungen zu bewerten und die Gesamtstruktur und Formatierung zu beurteilen. Auf der Grundlage dieser Analyse generiert das Tool Bewertungen oder Berichte, in denen die Stärken und Verbesserungsmöglichkeiten des Lebenslaufs hervorgehoben werden.
Was sind die wichtigsten Komponenten eines Full-Stack-KI-Lebenslauf-Analysators?
Ein Full-Stack-KI-Lebenslauf-Analysator besteht in der Regel aus drei Hauptkomponenten: Frontend, Backend und KI-Engine. Das Frontend, das in der Regel mit Technologien wie React erstellt wird, bietet Benutzeroberflächen zum Hochladen von Lebensläufen und Stellenbeschreibungen und zeigt gleichzeitig die Analyseergebnisse an. Das Backend, das häufig mit Python und Flask entwickelt wird, übernimmt die Dateiverarbeitung, Datenanalyse und Kommunikation zwischen Frontend und KI-Engine. Die KI-Engine nutzt maschinelles Lernen und NLP-Techniken, um Text zu extrahieren, zu analysieren und zu vergleichen und liefert so Erkenntnisse und Empfehlungen zur Optimierung des Lebenslaufs.
Welche Technologien werden zum Aufbau eines KI-Lebenslaufanalysators verwendet?
Die Entwicklung eines KI-Lebenslauf-Analysators kombiniert Frontend-, Backend- und KI-bezogene Technologien. Zu den Frontend-Technologien gehören React, HTML, CSS und JavaScript. Zu den Backend-Technologien gehören in der Regel Python, Flask und API-Entwicklungsframeworks. KI-bezogene Technologien umfassen Machine-Learning-Bibliotheken wie scikit-learn, Bibliotheken zur Verarbeitung natürlicher Sprache wie NLTK und spaCy sowie PDF/DOCX-Textextraktionswerkzeuge wie PyPDF2 und python-docx. Darüber hinaus können Cloud-Plattformen wie AWS, Google Cloud oder Azure für die Bereitstellung und Skalierbarkeit genutzt werden.
Verwandte Fragen
Wie kann ich meinen Lebenslauf anhand des Feedbacks des Analyzers verbessern?
Die Verbesserung Ihres Lebenslaufs auf der Grundlage des Feedbacks des AI Resume Analyzer umfasst mehrere Schritte. Überprüfen Sie zunächst sorgfältig den Bericht des Analyzers und notieren Sie sich die hervorgehobenen Verbesserungsbereiche. Identifizieren Sie fehlende Schlüsselwörter, falsch zugeordnete Fähigkeiten und strukturelle Probleme. Aktualisieren Sie anschließend Ihren Lebenslauf, um diese Probleme zu beheben, indem Sie relevante Schlüsselwörter aus der Stellenbeschreibung einfügen, Abschnitte umformulieren, um sie besser an die gewünschten Qualifikationen anzupassen, und die Gesamtstruktur und Formatierung verbessern. Führen Sie abschließend die Analyse erneut durch, um zu überprüfen, ob die Änderungen zu einer Verbesserung der Lebenslaufbewertung und einer besseren Übereinstimmung mit der Stellenbeschreibung geführt haben.








 Anthropic erweitert die Claude KI-Coding-Tools in Japan im Rahmen der Bemühungen um internationales Wachstum
Anthropic, ein führendes US-amerikalisches Unternehmen für künstliche Intelligenz, intensiviert seine globalen Outreach-Bemühungen. Am Mittwoch veranstaltete das Unternehmen in Tokio eine große Entwicklerkonferenz namens „Code with Claude“, an der kn
 Indiens Software-Riese stellt weniger ein, verspricht aber keine Entlassungen, während KI-Agenten ausgebaut werden
Während die künstliche Intelligenz traditionelle, arbeitsintensive Geschäftsmodelle neu gestaltet, hat Tata Consultancy Services (TCS), ein führendes indisches Software-Outsourcing-Unternehmen, seine strategische Antwort vorgestellt. Während der jähr
 China sperrt KI-Modelle während des Gaokam, um sofortige Hausaufgabenhilfe zu blockieren
Mit dem sich dem 2026-Gaokao schnell nähernden Termin haben Gerüchte über die Sperrung von KI-Tools während der Prüfungsphase eine intensive Online-Debatte entfacht. Als Reaktion auf die öffentlichen Bedenken haben große KI-Plattformen und Bildungs-A

Die besten und am besten bewerteten KI-Tools für den Stiltransfer im Jahr 2026 – ideal für kreative Experimente! XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung unverzichtbarer Tools zusammengestellt, die in Praxistests und strengen Bewertungen außergewöhnliche Ergebnisse liefern. Diese Top-Lösungen helfen Kreativen dabei, ihre Produktivität deutlich zu steigern, indem sie die Erstellung von Inhalten beschleunigen und unendliche kreative Möglichkeiten eröffnen. Entdecken Sie jetzt Ihr perfektes Tool und legen Sie noch heute los!
9 Tools
xix.ai

Die besten und am besten bewerteten KI-Tools für Sprechblasen zum visuellen Storytelling des Jahres 2026 finden Sie hier auf XIX.AI! Diese sorgfältig zusammengestellte Sammlung umfasst leistungsstarke, bahnbrechende Tools, die Kreativen dabei helfen, ihre Produktivität zu steigern und kreative Blockaden zu überwinden. Holen Sie sich einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, sehen Sie sich Praxistests an und werfen Sie einen Blick auf die aktuellen Rankings, um die unverzichtbaren Lösungen zu finden, die sich perfekt für die Gestaltung fesselnder visueller Erzählungen eignen. Stöbern Sie jetzt und entdecken Sie Ihr ideales Tool!
10 Tools
xix.ai

Die besten und am besten bewerteten KI-Tools zur Zusammenfassung von Besprechungen im Jahr 2026 für eine übersichtliche Nachverfolgung von Entscheidungen und müheloses Follow-up. Diese sorgfältig zusammengestellte Liste präsentiert leistungsstarke, bahnbrechende Lösungen, die die Produktivität drastisch steigern, indem sie Besprechungsnotizen automatisieren, wichtige Aktionspunkte identifizieren und die Teamkoordination projektübergreifend optimieren. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten sowie Praxistests und wöchentlich aktualisierte Rankings, die Ihnen helfen, das perfekte Tool zu finden. Entdecken Sie es jetzt und nutzen Sie Ihren KI-Vorteil!
9 Tools
xix.ai

2026 – Die neuesten, besten und am höchsten bewerteten Tools für die Reinigung von KI-Daten, um fehlende Werte sowie Duplikate schnell zu beheben. Diese sorgfältig zusammengestellte Liste präsentiert leistungsstarke Lösungen, die die Produktivität erheblich steigern. Jedes Tool wurde in der Praxis gründlich getestet, um seine Zuverlässigkeit zu gewährleisten. Holen Sie sich einen kostenlosen Vergleich zwischen kostenloser und kostenpflichtiger Variante und entdecken Sie das für Ihre Bedürfnisse beste Tool. Entdecken Sie es jetzt auf XIX.AI, um Ihren Vorteil in der KI-Branche zu erlangen.
11 Tools
xix.ai

2026 Neueste Besten Top-Bewerteten KI-Kreativitäts-Tools für Künstler wurden von XIX.AI kuratiert, um Kreativen zu helfen, visuelle Blockaden zu durchbrechen und die Kreativität sofort zu steigern. Diese leistungsstarken, bahnbrechenden Tools bieten reale Tests, detaillierte kostenlose vs. kostenpflichtige Vergleiche und wöchentlich aktualisierte Rankings. Entdecken Sie Ihr perfektes Tool, um die Content-Erstellung zu beschleunigen und Ihren KI-Vorteil noch heute freizuschalten. Jetzt erkunden!
14 Tools
xix.ai

Die besten KI-Beat-Generatoren 2026 für TikTok-Hintergrundtracks, Reels-Audio und Promo-Musik für Creator! XIX.AI hat eine Liste der besten Tools zusammengestellt, die bahnbrechende Funktionen bieten und in der Praxis getestet wurden, um makellose Musik für jeden Content-Bedarf zu liefern. Hier findest du detaillierte Vergleichsdaten zu kostenlosen und kostenpflichtigen Angeboten, wöchentlich aktualisierte Rankings sowie Optionen, die du unbedingt ausprobieren solltest, um deine Kreativität und Produktivität zu steigern. Entdecke jetzt das perfekte Tool für dich!
11 Tools
xix.ai












