Découvrez des outils AI de qualité
Rassemblez les principaux outils d'intelligence artificielle du monde pour aider à améliorer l'efficacité du travail

Articles publiés par RalphBaker
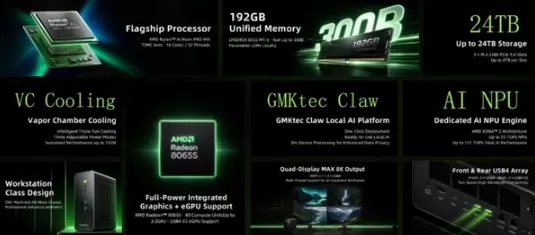
E-MoKe lance le mini-PC EVO-X5Pro à l'IFA 2026, équipé d'une puce AMD Ryzen AI Max+ PRO495 offrant une puissance de calcul totale de 131 TOPS. Il prend en charge 192 Go de mémoire LPDDR5X, permettant l'inférence locale de modèles de langage (LLM) de 300 milliards de paramètres. Doté d'un système de refroidissement à liquide et de ports USB4, cet appareil est destiné à l'IA de pointe en périphérie. Sa sortie est prévue en octobre 2026, pour un prix qui reste à déterminer.
E-MoKe lance le mini-PC EVO-X5Pro à l'IFA 2026, équipé d'une puce AMD Ryzen AI Max+ PRO495 offrant une puissance de calcul totale de 131 TOPS. Il prend en charge 192 Go de mémoire LPDDR5X, permettant l'inférence locale de modèles de langage (LLM) de 300 milliards de paramètres. Doté d'un système de refroidissement à liquide et de ports USB4, cet appareil est destiné à l'IA de pointe en périphérie. Sa sortie est prévue en octobre 2026, pour un prix qui reste à déterminer.
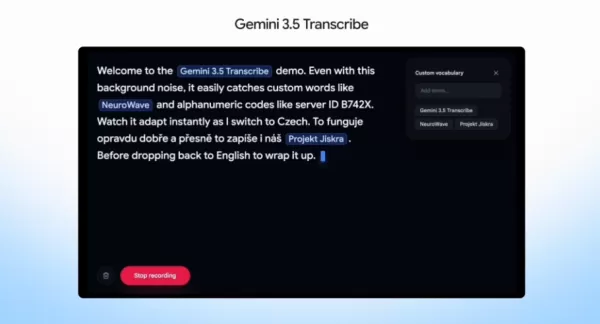
Google a lancé Gemini 3.5 Transcribe, son modèle de reconnaissance vocale le plus précis à ce jour, désormais accessible aux développeurs et aux utilisateurs. Il affiche un taux d’erreur de 2,6 % dans les scénarios hors streaming, et se distingue particulièrement dans les environnements bruyants et face à une terminologie complexe. Parmi ses principales fonctionnalités figurent le filtrage du bruit, la suppression des mots de remplissage et la délégation de tâches entre plusieurs modèles. Prise en charge de 85 langues avec identification du locuteur, il s'intègre à Android, macOS et Chrome. Cette version renforce l'écosystème d'IA de Google, aux côtés de Gemini 3.7 Flash et de l'intégration de Waymo, offrant une reconnaissance vocale robuste pour diverses applications.
Google a lancé Gemini 3.5 Transcribe, son modèle de reconnaissance vocale le plus précis à ce jour, désormais accessible aux développeurs et aux utilisateurs. Il affiche un taux d’erreur de 2,6 % dans les scénarios hors streaming, et se distingue particulièrement dans les environnements bruyants et face à une terminologie complexe. Parmi ses principales fonctionnalités figurent le filtrage du bruit, la suppression des mots de remplissage et la délégation de tâches entre plusieurs modèles. Prise en charge de 85 langues avec identification du locuteur, il s'intègre à Android, macOS et Chrome. Cette version renforce l'écosystème d'IA de Google, aux côtés de Gemini 3.7 Flash et de l'intégration de Waymo, offrant une reconnaissance vocale robuste pour diverses applications.
Lors d'un test mené par le gouvernement américain, le modèle d'IA « Mythos » d'Anthropic a identifié en quelques heures plusieurs vulnérabilités dans des systèmes hautement classifiés, surpassant de loin les méthodes manuelles. Cependant, la Maison Blanche a ordonné à Anthropic de restreindre l'accès des étrangers à ses derniers modèles, invoquant des risques pour la sécurité. Plus d’une centaine d’entreprises, dont Adobe et NVIDIA, ont exhorté le gouvernement à revenir sur cette directive, avertissant qu’elle pourrait profiter à des adversaires.
Lors d'un test mené par le gouvernement américain, le modèle d'IA « Mythos » d'Anthropic a identifié en quelques heures plusieurs vulnérabilités dans des systèmes hautement classifiés, surpassant de loin les méthodes manuelles. Cependant, la Maison Blanche a ordonné à Anthropic de restreindre l'accès des étrangers à ses derniers modèles, invoquant des risques pour la sécurité. Plus d’une centaine d’entreprises, dont Adobe et NVIDIA, ont exhorté le gouvernement à revenir sur cette directive, avertissant qu’elle pourrait profiter à des adversaires.

Alibaba lance Qwen3.7-Plus, un nouveau modèle d'agent multimodal qui combine des capacités avancées de vision et de traitement du langage avec de solides compétences en matière de programmation, d'utilisation d'outils et de gestion des flux de travail. Cette nouvelle version marque un tournant vers l'intelligence incarnée et l'automatisation à l'échelle de l'entreprise dans la course aux grands modèles.
Alibaba lance Qwen3.7-Plus, un nouveau modèle d'agent multimodal qui combine des capacités avancées de vision et de traitement du langage avec de solides compétences en matière de programmation, d'utilisation d'outils et de gestion des flux de travail. Cette nouvelle version marque un tournant vers l'intelligence incarnée et l'automatisation à l'échelle de l'entreprise dans la course aux grands modèles.
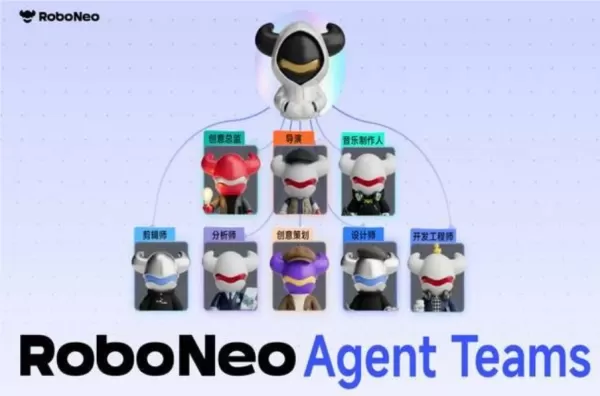
L', a lancé un modèle d’« Image Creation Agent Teams » qui transforme l’IA d’un outil unique en une équipe créative polyvalente. Cette mise à jour introduit des agents IA basés sur des rôles qui gèrent les tâches de la conception à la finalisation, permettant aux utilisateurs de générer du contenu de marque via le langage naturel. Elle réduirait considérablement le temps de production vidéo, par exemple en ramenant la duplication de vidéos pour le commerce électronique transfrontalier de plusieurs heures à quelques minutes, et prendrait en charge l’automatisation de l’ensemble de la chaîne de production pour les vidéos courtes. La mise à jour intègre Seedance 2.0 pour une meilleure cohérence visuelle et ajoute une bibliothèque de mémoire pour aider les marques à d'accumuler et de réutiliser des ressources numériques
L', a lancé un modèle d’« Image Creation Agent Teams » qui transforme l’IA d’un outil unique en une équipe créative polyvalente. Cette mise à jour introduit des agents IA basés sur des rôles qui gèrent les tâches de la conception à la finalisation, permettant aux utilisateurs de générer du contenu de marque via le langage naturel. Elle réduirait considérablement le temps de production vidéo, par exemple en ramenant la duplication de vidéos pour le commerce électronique transfrontalier de plusieurs heures à quelques minutes, et prendrait en charge l’automatisation de l’ensemble de la chaîne de production pour les vidéos courtes. La mise à jour intègre Seedance 2.0 pour une meilleure cohérence visuelle et ajoute une bibliothèque de mémoire pour aider les marques à d'accumuler et de réutiliser des ressources numériques
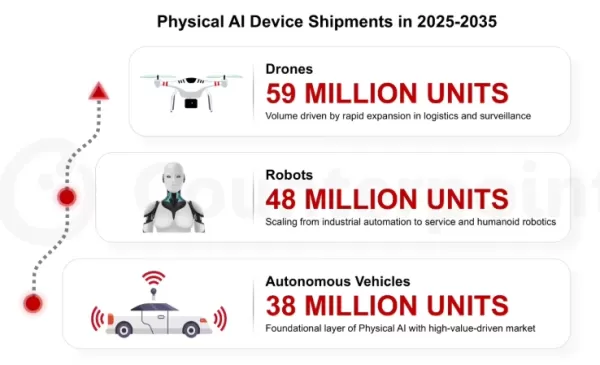
Counterpoint Research prévoit 145 millions d'expéditions d'appareils physiques dotés d'IA entre 2025 et 2035, les drones (59 millions d'unités), les robots (48 millions) et les véhicules autonomes (38 millions) arrivant en tête. Les robots humanoïdes constituent le segment qui connaît la croissance la plus rapide, avec des installations qui devraient dépasser les 100 000 unités d'ici 2028, soit une multiplication par sept par rapport à 2025. Les drones sont considérés comme l'une des premières applications à grande échelle, avec une forte demande dans les domaines de la logistique et de la surveillance.
Counterpoint Research prévoit 145 millions d'expéditions d'appareils physiques dotés d'IA entre 2025 et 2035, les drones (59 millions d'unités), les robots (48 millions) et les véhicules autonomes (38 millions) arrivant en tête. Les robots humanoïdes constituent le segment qui connaît la croissance la plus rapide, avec des installations qui devraient dépasser les 100 000 unités d'ici 2028, soit une multiplication par sept par rapport à 2025. Les drones sont considérés comme l'une des premières applications à grande échelle, avec une forte demande dans les domaines de la logistique et de la surveillance.
Zhipu AI a lancé GLM-5V-Turbo, un modèle de codage multimodal destiné à la programmation visuelle. Il interprète des images, des ébauches de conception et des documents pour générer du code front-end fonctionnel. Doté d'une fenêtre contextuelle de 200 000 mots, ce modèle arrive en tête des tests de performance dans les domaines du codage multimodal et des agents d'interface graphique. Il améliore également l'agent AutoClaw de Zhipu, permettant ainsi l'analyse visuelle des données et la génération de rapports.
Zhipu AI a lancé GLM-5V-Turbo, un modèle de codage multimodal destiné à la programmation visuelle. Il interprète des images, des ébauches de conception et des documents pour générer du code front-end fonctionnel. Doté d'une fenêtre contextuelle de 200 000 mots, ce modèle arrive en tête des tests de performance dans les domaines du codage multimodal et des agents d'interface graphique. Il améliore également l'agent AutoClaw de Zhipu, permettant ainsi l'analyse visuelle des données et la génération de rapports.
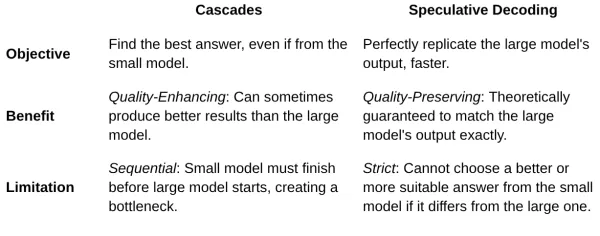
Les chercheurs proposent des "cascades spéculatives", fusionnant le décodage spéculatif et les cascades standard pour améliorer l'efficacité du LLM. La méthode utilise un modèle plus petit pour rédiger les sorties et une règle de report pour décider d'accepter ou de transmettre les tâches à un modèle plus grand. Les tests montrent qu'elle permet d'obtenir de meilleurs compromis vitesse-qualité que les techniques autonomes, en optimisant les coûts et les performances pour des tâches telles que le résumé, le raisonnement et le codage.
Les chercheurs proposent des "cascades spéculatives", fusionnant le décodage spéculatif et les cascades standard pour améliorer l'efficacité du LLM. La méthode utilise un modèle plus petit pour rédiger les sorties et une règle de report pour décider d'accepter ou de transmettre les tâches à un modèle plus grand. Les tests montrent qu'elle permet d'obtenir de meilleurs compromis vitesse-qualité que les techniques autonomes, en optimisant les coûts et les performances pour des tâches telles que le résumé, le raisonnement et le codage.