


 Maison
Pourquoi les agents oublient et s’écartent de leur trajectoire lors de tâches longues : AWS, Claude Code et Manus décomposent quatre cadres
Les grands modèles de langage perdent souvent le fil lors d'opérations prolongées, s'éloignant de leurs objectifs initiaux — un défi persistant dans le secteur des agents intelligents. Le problème découle souvent non pas du modèle lui-même, mais du cadre d'exécution qui l'entoure. Un guide de conception récent d'AWS pour les agents de programmation en nuage met cela clairement en évidence : les agents superficiels souffrent de débordement de contexte, perdent le fil lors de cycles longs et échouent à maintenir l'état. Remédier à cela nécessite d'optimiser le harnais, qui gère toutes les opérations externes au modèle de base.
Un examen approfondi des principaux cadres a mis en lumière cette couche critique. LangChain Deep Agents, Claude Code, Manus, OpenAI Codex et Amazon Bedrock AgentCore utilisent chacun quatre mécanismes clés — budgétisation du contexte, compression, gestion de l'état des tâches et mémoire inter-sessions — pour convertir des boucles basiques en agents robustes capables de gérer des tâches complexes et de longue durée.
La découverte la plus contre-intuitive est que l'expansion simple de la fenêtre de contexte ne résout pas le problème. Le rapport Context Rot de Chroma, qui a évalué 18 grands modèles, a révélé que même dans des tâches de récupération simples, la fiabilité du modèle diminue à mesure que la longueur d'entrée augmente. Anthropic explique que les mécanismes d'attention génèrent des relations par paires quadratiques pour n jetons, ce qui signifie que chaque jeton supplémentaire consomme une partie finie du budget d'attention. Le contexte est une ressource épuisable, pas un conteneur infini. Manus a également noté que les tâches typiques impliquent environ 50 appels d'outils, avec un ratio entrée-sortie proche de 100:1. Par conséquent, les instructions initiales se déplacent progressivement vers le centre de la fenêtre — précisément là où la dégradation de la mémoire est la plus prononcée.
Le premier moteur se concentre sur la budgétisation du contexte et le délestage. Deep Agents impose deux règles strictes : si un outil retourne plus de 20 000 jetons, les données sont écrites dans le système de fichiers, ne conservant que le chemin du fichier et un aperçu de 10 lignes ; lorsque le contexte de la session dépasse 85 % de la capacité de la fenêtre, les commandes d'édition plus anciennes sont remplacées par des pointeurs. Claude Code applique une logique similaire avant le chargement, limitant l'utilisation de la mémoire à 200 lignes ou 25 Ko, le mode d'outil MCP par défaut se limitant à lister les noms et à récupérer les détails à la demande. L'implémentation d'AWS AgentCore est encore plus rigoureuse : le coordinateur lance trois sous-agents de navigateur en parallèle, chacun fonctionnant dans sa propre MicroVM. L'agent d'analyse ne reçoit que des résultats structurés, réduisant la durée attendue à 4–6 minutes, tandis que l'exécution séquentielle peut prendre jusqu'à trois fois plus longtemps.
Le deuxième moteur gère la compression. Lorsque le délestage est insuffisant, le cadre résume la conversation près des limites de capacité et redémarre le processus. L'invite de compression de Claude Code préserve les décisions architecturales et les bogues non résolus tout en éliminant les sorties redondantes. Après la compression, il relit les cinq derniers fichiers modifiés et réinjecte le texte de compétence pertinent. Il archive également l'enregistrement original complet sur le disque, garantissant que les faits perdus lors de la synthèse peuvent être récupérés ultérieurement. Deep Agents traite la préservation des objectifs comme une fonctionnalité structurelle, organisant les documents de synthèse en intentions, sorties générées et prochaines étapes. La compression a également été intégrée au niveau de l'API : l'API Responses d'OpenAI offre une compression côté serveur via compact\_threshold, que Codex utilise pour les tâches de programmation longues. La plateforme Claude propose des paramètres de compression personnalisables avec des instructions modifiables.
Le troisième moteur gère l'état des tâches et les rappels persistants. Manus adopte une approche simple : créer un fichier todo.md et cocher les éléments étape par étape, intégrant efficacement l'objectif à la fin du contexte pour contrer le fait d'être « submergé au milieu ». Cependant, cette méthode n'est pas universellement efficace : Deep Agents a rendu son middleware de liste de tâches optionnel dans la version 0.7 (publiée en juillet 2026), car les évaluations ont montré que sa désactivation améliorait légèrement les scores de récompense et réduisait les coûts. LangChain recommande toujours de réactiver cette fonctionnalité pour les tâches longues, les modèles plus faibles et les interfaces nécessitant une visibilité sur la progression.
Le quatrième moteur permet la mémoire inter-sessions. Claude Code recharge CLAUDE.md et la mémoire automatique après chaque cycle de compression. AgentCore Memory exécute des stratégies d'extraction en arrière-plan, permettant au coordinateur de rappeler les insights précédents directement plutôt que de les réanalyser. Cependant, une recherche de l'ETH Zurich suggère la prudence : les fichiers de contexte comme AGENTS.md n'améliorent généralement pas les taux de réussite mais augmentent les coûts de raisonnement de 20 % à 23 %, imposant une taxe fixe sur le budget d'attention à chaque rechargement. Par conséquent, Claude Code conseille de garder CLAUDE.md en dessous de 200 lignes.
L'étude conclut que vérifier si un cadre « saisit vraiment l'objectif » nécessite des tests de compression forcée. Le mode d'échec le plus dangereux se produit lorsqu'un agent demande immédiatement des clarifications après une synthèse ou déclare incorrectement qu'une tâche est terminée. En fin de compte, maintenir un agent sur la bonne voie lors de longs trajets dépend non pas de la taille du modèle, mais de la précision de ces moteurs de soutien.
Article connexe
 La plateforme Qwen AI élargit sa matrice de modèles avec le lancement officiel de GLM-5.3 et DeepSeek-V4-Pro
La plateforme d’IA Qwen d’Alibaba Cloud (MaaS) a récemment élargi sa matrice de services de modèles, en intégrant le modèle phare GLM-5.3 de Zhipu et la version officielle de DeepSeek-V4-Pro. Les services API correspondants sont désormais accessibles
Le secteur chinois de l’intelligence artificielle enregistre des avancées sur toute la chaîne de valeur, accélérant ainsi l’adoption de la loi sur l’intelligence artificielle
Les téléchargements mondiaux des grands modèles de langage nationaux ont dépassé les 10 milliards, avec l’émergence régulière de modèles open source à paramètres de l’ordre du trillion. Le secteur de l’intelligence artificielle en Chine réalise des a
Zhiyuan Innovation dévoile Data Acquisition 2.0 pour propulser des robots plus intelligents
Alors que le secteur de l’intelligence artificielle s’étend rapidement, permettre aux robots de comprendre et de s’adapter avec précision à des environnements réels complexes est devenu une priorité critique pour l’industrie. Lors de la conférence su
Recommandations de sujets spéciaux liés
Santé et bien-être
 Applications de planification des repas basées sur ChatGPT pour le suivi des macronutriments, les listes de courses et la préparation hebdomadaire
2026 : les meilleures applications ChatGPT pour planifier vos repas. Découvrez les outils les mieux notés, incontournables et puissants, sélectionnés avec soin pour changer la donne en matière de suivi des macronutriments, de listes de courses et de préparation hebdomadaire. XIX.AI propose des classements mis à jour chaque semaine, basés sur des tests en conditions réelles, avec notamment des comparaisons détaillées entre les versions gratuites et payantes. Trouvez dès aujourd’hui l’outil idéal pour booster votre productivité et tirer pleinement parti de l’IA. Découvrez-les dès maintenant !
 9 outils
 xix.ai
Création vidéo
Outils de création de scripts vidéo basés sur l'IA pour les contenus courts
Les meilleurs outils de création de scripts vidéo basés sur l'IA pour les contenus courts en 2026 ! XIX.AI a sélectionné une gamme d'outils puissants et révolutionnaires, à essayer absolument, qui ont été soumis à des tests rigoureux en conditions réelles. Vous y trouverez des classements détaillés mis à jour chaque semaine, des comparaisons entre versions gratuites et payantes, ainsi que des conseils pour vous aider à booster votre productivité et à tirer pleinement parti de l’IA afin de créer du contenu court de haute qualité. Explorez-la dès maintenant pour découvrir l’outil qui vous convient le mieux !
10 outils
xix.ai
Création de bande dessinée
Outils d'IA pour la création de cases de bande dessinée destinés aux récits de type storyboard
2026 : les meilleurs outils d'IA pour créer des planches de BD, idéaux pour les récits de type storyboard ! Cette sélection triée sur le volet regroupe des solutions puissantes et révolutionnaires qui aident les créateurs à gagner en efficacité dans l'écriture et à surmonter les obstacles à la création. Vous y trouverez des comparaisons détaillées entre les versions gratuites et payantes, des tests en conditions réelles et des classements officiels pour vous guider dans votre choix. XIX.AI propose également des avis d'experts. Explorez-la dès maintenant pour découvrir l'outil idéal qui vous permettra de donner vie à des histoires captivantes ! 238 caractères
9 outils
xix.ai
Création vidéo
Meilleurs outils de génération vidéo par IA pour les contenus courts
2026 Derniers Meilleurs Outils de Génération de Vidéos par IA les mieux notés pour les contenus courts sont ici dans la collection sélectionnée de XIX.AI. Ces outils puissants et révolutionnaires ont été soumis à des tests rigoureux en conditions réelles, avec une comparaison complète entre les versions gratuites et payantes ainsi que des classements détaillés pour vous aider à trouver l’option parfaite. Que vous ayez besoin de créer rapidement des vidéos courtes de haute qualité ou d’améliorer votre productivité sur diverses tâches, ces solutions incontournables offrent des résultats exceptionnels. Explorez dès maintenant pour découvrir l’outil idéal et débloquer votre avantage par l’IA.
9 outils
xix.ai
Conception et art
Meilleurs générateurs d’art par IA : Découvrez des moodboards, des styles et des orientations visuelles
Le classement des meilleurs générateurs d’art IA de 2026 met en lumière les outils les plus appréciés pour créer des moodboards époustouflants, explorer divers styles et définir des directions visuelles. XIX.AI propose une liste sélectionnée d’options puissantes et révolutionnaires ayant réussi des tests rigoureux dans des conditions réelles. Consultez une comparaison gratuite et payante pour trouver celle qui correspond le mieux à vos besoins et améliorer ainsi votre flux de travail créatif. Découvrez dès maintenant comment tirer parti des avantages offerts par l’IA dans la création artistique.
10 outils
xix.ai
Commercialisation
Plateformes de personnalisation des e-mails basées sur l'IA pour les flux Shopify, la fidélisation et la reconquête des clients
Les meilleures plateformes de personnalisation des e-mails par IA pour Shopify en 2026 : des solutions qui stimulent la fidélisation et la reconquête des clients. Cette sélection triée sur le volet et très bien notée présente des outils puissants et révolutionnaires, testés en conditions réelles, et propose une comparaison entre les versions gratuites et payantes. XIX.AI fait partie de notre sélection de confiance. Découvrez dès aujourd’hui l’outil idéal pour tirer pleinement parti de l’IA. Explorez-la dès maintenant !
9 outils
xix.ai

 commentaires (0)
Les grands modèles de langage perdent souvent le fil lors d'opérations prolongées, s'éloignant de leurs objectifs initiaux — un défi persistant dans le secteur des agents intelligents. Le problème découle souvent non pas du modèle lui-même, mais du cadre d'exécution qui l'entoure. Un guide de conception récent d'AWS pour les agents de programmation en nuage met cela clairement en évidence : les agents superficiels souffrent de débordement de contexte, perdent le fil lors de cycles longs et échouent à maintenir l'état. Remédier à cela nécessite d'optimiser le harnais, qui gère toutes les opérations externes au modèle de base.
Un examen approfondi des principaux cadres a mis en lumière cette couche critique. LangChain Deep Agents, Claude Code, Manus, OpenAI Codex et Amazon Bedrock AgentCore utilisent chacun quatre mécanismes clés — budgétisation du contexte, compression, gestion de l'état des tâches et mémoire inter-sessions — pour convertir des boucles basiques en agents robustes capables de gérer des tâches complexes et de longue durée.
La découverte la plus contre-intuitive est que l'expansion simple de la fenêtre de contexte ne résout pas le problème. Le rapport Context Rot de Chroma, qui a évalué 18 grands modèles, a révélé que même dans des tâches de récupération simples, la fiabilité du modèle diminue à mesure que la longueur d'entrée augmente. Anthropic explique que les mécanismes d'attention génèrent des relations par paires quadratiques pour n jetons, ce qui signifie que chaque jeton supplémentaire consomme une partie finie du budget d'attention. Le contexte est une ressource épuisable, pas un conteneur infini. Manus a également noté que les tâches typiques impliquent environ 50 appels d'outils, avec un ratio entrée-sortie proche de 100:1. Par conséquent, les instructions initiales se déplacent progressivement vers le centre de la fenêtre — précisément là où la dégradation de la mémoire est la plus prononcée.
Le premier moteur se concentre sur la budgétisation du contexte et le délestage. Deep Agents impose deux règles strictes : si un outil retourne plus de 20 000 jetons, les données sont écrites dans le système de fichiers, ne conservant que le chemin du fichier et un aperçu de 10 lignes ; lorsque le contexte de la session dépasse 85 % de la capacité de la fenêtre, les commandes d'édition plus anciennes sont remplacées par des pointeurs. Claude Code applique une logique similaire avant le chargement, limitant l'utilisation de la mémoire à 200 lignes ou 25 Ko, le mode d'outil MCP par défaut se limitant à lister les noms et à récupérer les détails à la demande. L'implémentation d'AWS AgentCore est encore plus rigoureuse : le coordinateur lance trois sous-agents de navigateur en parallèle, chacun fonctionnant dans sa propre MicroVM. L'agent d'analyse ne reçoit que des résultats structurés, réduisant la durée attendue à 4–6 minutes, tandis que l'exécution séquentielle peut prendre jusqu'à trois fois plus longtemps.
Le deuxième moteur gère la compression. Lorsque le délestage est insuffisant, le cadre résume la conversation près des limites de capacité et redémarre le processus. L'invite de compression de Claude Code préserve les décisions architecturales et les bogues non résolus tout en éliminant les sorties redondantes. Après la compression, il relit les cinq derniers fichiers modifiés et réinjecte le texte de compétence pertinent. Il archive également l'enregistrement original complet sur le disque, garantissant que les faits perdus lors de la synthèse peuvent être récupérés ultérieurement. Deep Agents traite la préservation des objectifs comme une fonctionnalité structurelle, organisant les documents de synthèse en intentions, sorties générées et prochaines étapes. La compression a également été intégrée au niveau de l'API : l'API Responses d'OpenAI offre une compression côté serveur via compact\_threshold, que Codex utilise pour les tâches de programmation longues. La plateforme Claude propose des paramètres de compression personnalisables avec des instructions modifiables.
Le troisième moteur gère l'état des tâches et les rappels persistants. Manus adopte une approche simple : créer un fichier todo.md et cocher les éléments étape par étape, intégrant efficacement l'objectif à la fin du contexte pour contrer le fait d'être « submergé au milieu ». Cependant, cette méthode n'est pas universellement efficace : Deep Agents a rendu son middleware de liste de tâches optionnel dans la version 0.7 (publiée en juillet 2026), car les évaluations ont montré que sa désactivation améliorait légèrement les scores de récompense et réduisait les coûts. LangChain recommande toujours de réactiver cette fonctionnalité pour les tâches longues, les modèles plus faibles et les interfaces nécessitant une visibilité sur la progression.
Le quatrième moteur permet la mémoire inter-sessions. Claude Code recharge CLAUDE.md et la mémoire automatique après chaque cycle de compression. AgentCore Memory exécute des stratégies d'extraction en arrière-plan, permettant au coordinateur de rappeler les insights précédents directement plutôt que de les réanalyser. Cependant, une recherche de l'ETH Zurich suggère la prudence : les fichiers de contexte comme AGENTS.md n'améliorent généralement pas les taux de réussite mais augmentent les coûts de raisonnement de 20 % à 23 %, imposant une taxe fixe sur le budget d'attention à chaque rechargement. Par conséquent, Claude Code conseille de garder CLAUDE.md en dessous de 200 lignes.
L'étude conclut que vérifier si un cadre « saisit vraiment l'objectif » nécessite des tests de compression forcée. Le mode d'échec le plus dangereux se produit lorsqu'un agent demande immédiatement des clarifications après une synthèse ou déclare incorrectement qu'une tâche est terminée. En fin de compte, maintenir un agent sur la bonne voie lors de longs trajets dépend non pas de la taille du modèle, mais de la précision de ces moteurs de soutien.








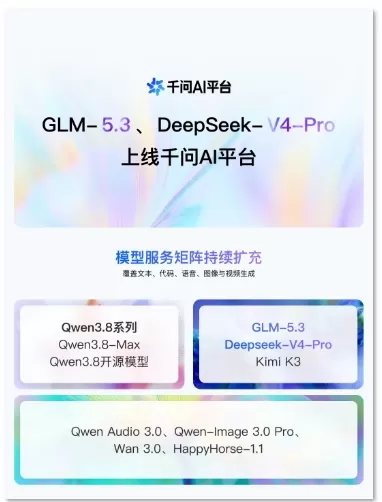 La plateforme Qwen AI élargit sa matrice de modèles avec le lancement officiel de GLM-5.3 et DeepSeek-V4-Pro
La plateforme d’IA Qwen d’Alibaba Cloud (MaaS) a récemment élargi sa matrice de services de modèles, en intégrant le modèle phare GLM-5.3 de Zhipu et la version officielle de DeepSeek-V4-Pro. Les services API correspondants sont désormais accessibles
 Le secteur chinois de l’intelligence artificielle enregistre des avancées sur toute la chaîne de valeur, accélérant ainsi l’adoption de la loi sur l’intelligence artificielle
Les téléchargements mondiaux des grands modèles de langage nationaux ont dépassé les 10 milliards, avec l’émergence régulière de modèles open source à paramètres de l’ordre du trillion. Le secteur de l’intelligence artificielle en Chine réalise des a
 Zhiyuan Innovation dévoile Data Acquisition 2.0 pour propulser des robots plus intelligents
Alors que le secteur de l’intelligence artificielle s’étend rapidement, permettre aux robots de comprendre et de s’adapter avec précision à des environnements réels complexes est devenu une priorité critique pour l’industrie. Lors de la conférence su

2026 : les meilleures applications ChatGPT pour planifier vos repas. Découvrez les outils les mieux notés, incontournables et puissants, sélectionnés avec soin pour changer la donne en matière de suivi des macronutriments, de listes de courses et de préparation hebdomadaire. XIX.AI propose des classements mis à jour chaque semaine, basés sur des tests en conditions réelles, avec notamment des comparaisons détaillées entre les versions gratuites et payantes. Trouvez dès aujourd’hui l’outil idéal pour booster votre productivité et tirer pleinement parti de l’IA. Découvrez-les dès maintenant !
9 outils
xix.ai

Les meilleurs outils de création de scripts vidéo basés sur l'IA pour les contenus courts en 2026 ! XIX.AI a sélectionné une gamme d'outils puissants et révolutionnaires, à essayer absolument, qui ont été soumis à des tests rigoureux en conditions réelles. Vous y trouverez des classements détaillés mis à jour chaque semaine, des comparaisons entre versions gratuites et payantes, ainsi que des conseils pour vous aider à booster votre productivité et à tirer pleinement parti de l’IA afin de créer du contenu court de haute qualité. Explorez-la dès maintenant pour découvrir l’outil qui vous convient le mieux !
10 outils
xix.ai

2026 : les meilleurs outils d'IA pour créer des planches de BD, idéaux pour les récits de type storyboard ! Cette sélection triée sur le volet regroupe des solutions puissantes et révolutionnaires qui aident les créateurs à gagner en efficacité dans l'écriture et à surmonter les obstacles à la création. Vous y trouverez des comparaisons détaillées entre les versions gratuites et payantes, des tests en conditions réelles et des classements officiels pour vous guider dans votre choix. XIX.AI propose également des avis d'experts. Explorez-la dès maintenant pour découvrir l'outil idéal qui vous permettra de donner vie à des histoires captivantes ! 238 caractères
9 outils
xix.ai

2026 Derniers Meilleurs Outils de Génération de Vidéos par IA les mieux notés pour les contenus courts sont ici dans la collection sélectionnée de XIX.AI. Ces outils puissants et révolutionnaires ont été soumis à des tests rigoureux en conditions réelles, avec une comparaison complète entre les versions gratuites et payantes ainsi que des classements détaillés pour vous aider à trouver l’option parfaite. Que vous ayez besoin de créer rapidement des vidéos courtes de haute qualité ou d’améliorer votre productivité sur diverses tâches, ces solutions incontournables offrent des résultats exceptionnels. Explorez dès maintenant pour découvrir l’outil idéal et débloquer votre avantage par l’IA.
9 outils
xix.ai

Le classement des meilleurs générateurs d’art IA de 2026 met en lumière les outils les plus appréciés pour créer des moodboards époustouflants, explorer divers styles et définir des directions visuelles. XIX.AI propose une liste sélectionnée d’options puissantes et révolutionnaires ayant réussi des tests rigoureux dans des conditions réelles. Consultez une comparaison gratuite et payante pour trouver celle qui correspond le mieux à vos besoins et améliorer ainsi votre flux de travail créatif. Découvrez dès maintenant comment tirer parti des avantages offerts par l’IA dans la création artistique.
10 outils
xix.ai
Les meilleures plateformes de personnalisation des e-mails par IA pour Shopify en 2026 : des solutions qui stimulent la fidélisation et la reconquête des clients. Cette sélection triée sur le volet et très bien notée présente des outils puissants et révolutionnaires, testés en conditions réelles, et propose une comparaison entre les versions gratuites et payantes. XIX.AI fait partie de notre sélection de confiance. Découvrez dès aujourd’hui l’outil idéal pour tirer pleinement parti de l’IA. Explorez-la dès maintenant !
9 outils
xix.ai












