


 Maison
Qwen 3.6 27B : un modèle local de pointe qui rivalise avec GPT-5
Autrefois, l'exécution locale de modèles volumineux impliquait de faire des compromis en termes de performances ou de fonctionnalités. Mais avec la sortie de la série Qwen 3.6, cette perception est en train de changer. Le développeur Piotr Migdał a récemment mis Qwen3.6-27B à l’épreuve sur un MacBook Max M5 doté de 128 Go de RAM, et les résultats sont prometteurs : ce modèle n’est pas seulement « utilisable », c’est un outil puissant qui répond aux besoins en intelligence générale sans sacrifier l’expérience utilisateur.
D'un point de vue technique, le modèle est remarquablement efficace. En utilisant une version quantifiée GGUF 8 bits avec llama.cpp, la prédiction multi-tokens (MTP) et le flash attention, il offre un débit stable de 32 tokens par seconde dans un contexte de 64K. La variante A3B MoE de 35 milliards de paramètres dépasse même les 100 tokens par seconde dans la même configuration.
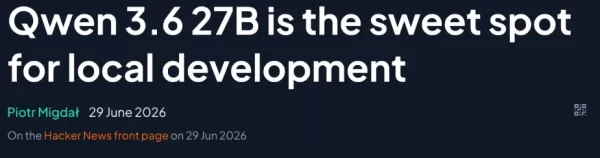
La véritable avancée réside dans le niveau d’intelligence. Selon Artificial Analysis, Qwen3.6-27B obtient un score de 37 points, ce qui le place au niveau du GPT-5 ou de Claude Sonnet 4.5 prévu pour mi-2025. À titre de comparaison, Gemma 3 31B — qui était auparavant le modèle de codage local de référence — n’a obtenu que 29 points. Cela signifie qu’en seulement un an, les modèles locaux sont passés du statut de « pointe » d’il y a deux ans à un niveau proche de celui des meilleurs modèles API payants d’il y a un an.
Lors de tests en conditions réelles, le modèle se montre également très performant. Qu’il s’agisse d’écrire un poème de huit vers avec des schémas de rimes complexes ou de générer un jeu de Démineur hexagonal à l’aide de pnpm, Qwen3.6‑27B fournit des résultats de haute qualité en un seul passage. Pour les développeurs, le principal avantage d’un modèle local réside dans le contrôle : plus besoin de s’inquiéter des interruptions de service ou des coûts élevés des API, puisque tout s’exécute sur votre propre disque dur.
Cela marque un tournant : lorsque les modèles open source fonctionnant sur du matériel grand public atteignent des niveaux d’intelligence comparables à ceux des meilleurs modèles payants, les développeurs peuvent intégrer en toute confiance une IA haute performance dans leurs flux de travail personnels. Pour les créateurs qui accordent de l’importance à la productivité et à la confidentialité, il s’agit actuellement de l’un des choix technologiques les plus remarquables.
Article connexe
 BYD dévoile la Xuanji A3, sa première puce IA de 4 nm destinée au secteur automobile
La course mondiale à la puissance de calcul fondamentale des véhicules intelligents a atteint un tournant décisif. Le 29 mai, BYD a dévoilé le « Xuanji A3 », la première puce de conduite intelligente
OpenAI lance « Astra for Law », qui répertorie 230 millions d'URL et surpasse les modèles généraux en matière de questions-réponses juridiques
Le 17 septembre, OpenAI a publié un article de blog présentant en détail « Astra for Law », une plateforme d’IA de base spécialement conçue pour les applications juridiques. Sa robustesse tient à l’am
TechCrunch Disrupt 2026 : les économies sur les billets Early Bird s’achèvent dans 3 jours
Il ne reste que 3 jours pour économiser jusqu'à 410 $ sur votre billet pour TechCrunch Disrupt 2026. Les tarifs « Early Bird » prennent fin le 29 mai à 23 h 59 (heure de la côte ouest des États-Unis), et une fois ce délai écoulé, les prix des billets
Recommandations de sujets spéciaux liés
Conception et art
 Les meilleurs outils d'illustration basés sur l'IA : créez plus rapidement des scènes éditoriales et des illustrations de couverture
Les meilleurs outils d'illustration IA de 2026 : notre sélection regroupe les outils les plus performants pour créer rapidement de superbes scènes éditoriales et des couvertures accrocheuses. Chaque option a été soumise à des tests rigoureux en conditions réelles ; nous vous proposons une comparaison entre les versions gratuites et payantes afin de vous aider à trouver celle qui correspond le mieux à votre flux de travail. Essayez dès aujourd’hui ces solutions incontournables pour exploiter pleinement le potentiel de l’IA et booster votre productivité créative. Découvrez-les dès maintenant sur XIX.AI.
 10 outils
 xix.ai
Éducation et apprentissage
Les meilleurs professeurs particuliers spécialisés en IA pour la préparation aux examens : entraînez-vous en maths, en sciences et en anglais
Les meilleurs tuteurs IA 2026 les mieux notés pour la préparation aux examens sont disponibles ici, sur XIX.AI ! Notre sélection comprend des outils puissants et révolutionnaires qui proposent une comparaison entre les versions gratuites et payantes, des tests concrets et des classements mis à jour chaque semaine. Ils vous aident à améliorer votre efficacité à l'écrit, à simplifier l'apprentissage de sujets complexes et à libérer votre potentiel académique. Découvrez dès maintenant l'outil de préparation aux examens qui vous convient le mieux et commencez à créer dès aujourd'hui pour exploiter pleinement les avantages de l'IA !
10 outils
xix.ai
Finance
Outils de planification budgétaire par IA pour la gestion personnelle des finances
2026 Derniers Meilleurs Outils de Planification Budgétaire par IA les mieux notés pour la gestion personnelle des finances sont ici sur XIX.AI ! Cette collection soigneusement sélectionnée propose des solutions puissantes et révolutionnaires qui vous aident à réaliser des tests concrets, à comprendre vos habitudes de dépenses et à créer des plans personnalisés pour améliorer votre productivité. Profitez d’une comparaison entre versions gratuites et payantes ainsi que de classements détaillés. Des outils incontournables conçus pour simplifier la gestion financière et exploiter pleinement votre avantage grâce à l’IA. Explorez dès maintenant !
11 outils
xix.ai
Santé et bien-être
Assistants de suivi du sommeil par l’IA : améliorez votre récupération grâce à de meilleures habitudes avant le coucher
2026 : Découvrez les meilleurs assistants de suivi du sommeil basés sur l’IA, hautement notés et récemment mis à jour, conçus pour une récupération optimale. Ce guide hebdomadaire entièrement actualisé présente des outils puissants qui offrent des tests en conditions réelles, des comparaisons entre versions gratuites et payantes, ainsi que des classements détaillés afin de vous aider à trouver la solution idéale pour améliorer la qualité du sommeil et favoriser de meilleures habitudes avant le coucher. Explorez-le dès maintenant sur XIX.AI pour tirer parti des avantages offerts par l’IA.
10 outils
xix.ai
Analyse des données
Copilotes SQL basés sur l'IA pour l'analyse des produits et du chiffre d'affaires
2026 : les meilleurs copilotes SQL IA les mieux notés pour l'analyse des produits et du chiffre d'affaires ! XIX.AI a sélectionné une gamme d’outils puissants et révolutionnaires à essayer absolument, qui sont soumis à des tests en conditions réelles via des classements mis à jour chaque semaine. Ces outils aident les utilisateurs à booster considérablement leur productivité en accélérant l’analyse des données, en simplifiant les requêtes complexes et en générant des informations précises permettant de prendre des décisions commerciales plus éclairées. Explorez-les dès maintenant pour découvrir l’outil idéal qui vous permettra de tirer pleinement parti de l’IA !
14 outils
xix.ai
Éducation et apprentissage
Les meilleurs outils d'aide aux devoirs basés sur l'IA qui enseignent : apprenez les concepts, pas seulement les réponses
2026 : les meilleurs outils d'aide aux devoirs basés sur l'IA, les mieux notés, qui enseignent les concepts fondamentaux et ne se contentent pas de fournir des réponses. Des outils puissants pour les élèves. Une sélection incontournable à ne pas manquer. Mise à jour hebdomadaire. Comparaison entre les versions gratuites et payantes. Tests en conditions réelles. Classements précis pour vous aider à exploiter pleinement votre potentiel d'apprentissage. Explorez dès maintenant pour découvrir l'outil idéal qui vous permettra d'étudier plus efficacement.
10 outils
xix.ai

 commentaires (1)
![RalphGarcia]()
MacBook M5でQwen3.6-27BがGPT-5に匹敵するって、ローカル推論の常識が覆りそう!ローカルでこれだけのパフォーマンス出せるなら、プライバシーも守れるし最高じゃないですか。開発者のPiotr Migdał氏の検証結果、ぜひ全文読んでみたいです。
Autrefois, l'exécution locale de modèles volumineux impliquait de faire des compromis en termes de performances ou de fonctionnalités. Mais avec la sortie de la série Qwen 3.6, cette perception est en train de changer. Le développeur Piotr Migdał a récemment mis Qwen3.6-27B à l’épreuve sur un MacBook Max M5 doté de 128 Go de RAM, et les résultats sont prometteurs : ce modèle n’est pas seulement « utilisable », c’est un outil puissant qui répond aux besoins en intelligence générale sans sacrifier l’expérience utilisateur.
D'un point de vue technique, le modèle est remarquablement efficace. En utilisant une version quantifiée GGUF 8 bits avec llama.cpp, la prédiction multi-tokens (MTP) et le flash attention, il offre un débit stable de 32 tokens par seconde dans un contexte de 64K. La variante A3B MoE de 35 milliards de paramètres dépasse même les 100 tokens par seconde dans la même configuration.
La véritable avancée réside dans le niveau d’intelligence. Selon Artificial Analysis, Qwen3.6-27B obtient un score de 37 points, ce qui le place au niveau du GPT-5 ou de Claude Sonnet 4.5 prévu pour mi-2025. À titre de comparaison, Gemma 3 31B — qui était auparavant le modèle de codage local de référence — n’a obtenu que 29 points. Cela signifie qu’en seulement un an, les modèles locaux sont passés du statut de « pointe » d’il y a deux ans à un niveau proche de celui des meilleurs modèles API payants d’il y a un an.
Lors de tests en conditions réelles, le modèle se montre également très performant. Qu’il s’agisse d’écrire un poème de huit vers avec des schémas de rimes complexes ou de générer un jeu de Démineur hexagonal à l’aide de pnpm, Qwen3.6‑27B fournit des résultats de haute qualité en un seul passage. Pour les développeurs, le principal avantage d’un modèle local réside dans le contrôle : plus besoin de s’inquiéter des interruptions de service ou des coûts élevés des API, puisque tout s’exécute sur votre propre disque dur.
Cela marque un tournant : lorsque les modèles open source fonctionnant sur du matériel grand public atteignent des niveaux d’intelligence comparables à ceux des meilleurs modèles payants, les développeurs peuvent intégrer en toute confiance une IA haute performance dans leurs flux de travail personnels. Pour les créateurs qui accordent de l’importance à la productivité et à la confidentialité, il s’agit actuellement de l’un des choix technologiques les plus remarquables.








 BYD dévoile la Xuanji A3, sa première puce IA de 4 nm destinée au secteur automobile
La course mondiale à la puissance de calcul fondamentale des véhicules intelligents a atteint un tournant décisif. Le 29 mai, BYD a dévoilé le « Xuanji A3 », la première puce de conduite intelligente
 OpenAI lance « Astra for Law », qui répertorie 230 millions d'URL et surpasse les modèles généraux en matière de questions-réponses juridiques
Le 17 septembre, OpenAI a publié un article de blog présentant en détail « Astra for Law », une plateforme d’IA de base spécialement conçue pour les applications juridiques. Sa robustesse tient à l’am
 TechCrunch Disrupt 2026 : les économies sur les billets Early Bird s’achèvent dans 3 jours
Il ne reste que 3 jours pour économiser jusqu'à 410 $ sur votre billet pour TechCrunch Disrupt 2026. Les tarifs « Early Bird » prennent fin le 29 mai à 23 h 59 (heure de la côte ouest des États-Unis), et une fois ce délai écoulé, les prix des billets

Les meilleurs outils d'illustration IA de 2026 : notre sélection regroupe les outils les plus performants pour créer rapidement de superbes scènes éditoriales et des couvertures accrocheuses. Chaque option a été soumise à des tests rigoureux en conditions réelles ; nous vous proposons une comparaison entre les versions gratuites et payantes afin de vous aider à trouver celle qui correspond le mieux à votre flux de travail. Essayez dès aujourd’hui ces solutions incontournables pour exploiter pleinement le potentiel de l’IA et booster votre productivité créative. Découvrez-les dès maintenant sur XIX.AI.
10 outils
xix.ai

Les meilleurs tuteurs IA 2026 les mieux notés pour la préparation aux examens sont disponibles ici, sur XIX.AI ! Notre sélection comprend des outils puissants et révolutionnaires qui proposent une comparaison entre les versions gratuites et payantes, des tests concrets et des classements mis à jour chaque semaine. Ils vous aident à améliorer votre efficacité à l'écrit, à simplifier l'apprentissage de sujets complexes et à libérer votre potentiel académique. Découvrez dès maintenant l'outil de préparation aux examens qui vous convient le mieux et commencez à créer dès aujourd'hui pour exploiter pleinement les avantages de l'IA !
10 outils
xix.ai

2026 Derniers Meilleurs Outils de Planification Budgétaire par IA les mieux notés pour la gestion personnelle des finances sont ici sur XIX.AI ! Cette collection soigneusement sélectionnée propose des solutions puissantes et révolutionnaires qui vous aident à réaliser des tests concrets, à comprendre vos habitudes de dépenses et à créer des plans personnalisés pour améliorer votre productivité. Profitez d’une comparaison entre versions gratuites et payantes ainsi que de classements détaillés. Des outils incontournables conçus pour simplifier la gestion financière et exploiter pleinement votre avantage grâce à l’IA. Explorez dès maintenant !
11 outils
xix.ai

2026 : Découvrez les meilleurs assistants de suivi du sommeil basés sur l’IA, hautement notés et récemment mis à jour, conçus pour une récupération optimale. Ce guide hebdomadaire entièrement actualisé présente des outils puissants qui offrent des tests en conditions réelles, des comparaisons entre versions gratuites et payantes, ainsi que des classements détaillés afin de vous aider à trouver la solution idéale pour améliorer la qualité du sommeil et favoriser de meilleures habitudes avant le coucher. Explorez-le dès maintenant sur XIX.AI pour tirer parti des avantages offerts par l’IA.
10 outils
xix.ai

2026 : les meilleurs copilotes SQL IA les mieux notés pour l'analyse des produits et du chiffre d'affaires ! XIX.AI a sélectionné une gamme d’outils puissants et révolutionnaires à essayer absolument, qui sont soumis à des tests en conditions réelles via des classements mis à jour chaque semaine. Ces outils aident les utilisateurs à booster considérablement leur productivité en accélérant l’analyse des données, en simplifiant les requêtes complexes et en générant des informations précises permettant de prendre des décisions commerciales plus éclairées. Explorez-les dès maintenant pour découvrir l’outil idéal qui vous permettra de tirer pleinement parti de l’IA !
14 outils
xix.ai

2026 : les meilleurs outils d'aide aux devoirs basés sur l'IA, les mieux notés, qui enseignent les concepts fondamentaux et ne se contentent pas de fournir des réponses. Des outils puissants pour les élèves. Une sélection incontournable à ne pas manquer. Mise à jour hebdomadaire. Comparaison entre les versions gratuites et payantes. Tests en conditions réelles. Classements précis pour vous aider à exploiter pleinement votre potentiel d'apprentissage. Explorez dès maintenant pour découvrir l'outil idéal qui vous permettra d'étudier plus efficacement.
10 outils
xix.ai

MacBook M5でQwen3.6-27BがGPT-5に匹敵するって、ローカル推論の常識が覆りそう!ローカルでこれだけのパフォーマンス出せるなら、プライバシーも守れるし最高じゃないですか。開発者のPiotr Migdał氏の検証結果、ぜひ全文読んでみたいです。












