


 Maison
ByteDance dévoile Seedance 2.5 : une vidéo de 30 secondes réalisée en une seule prise grâce à l'IA, qui raconte une histoire
ByteDance a officiellement lancé Seedance 2.5, un modèle de génération de vidéos qui double la durée maximale de sortie, passant de 15 à 30 secondes par vidéo. La plateforme sera déployée progressivement sur Ji Meng AI et Dou Bao Professional Edition, et son intégration via une API à Volcano Argo est prévue prochainement afin de prendre en charge diverses applications dans les domaines du cinéma, de la publicité, de l’éducation, de la fabrication industrielle et de la conduite autonome.
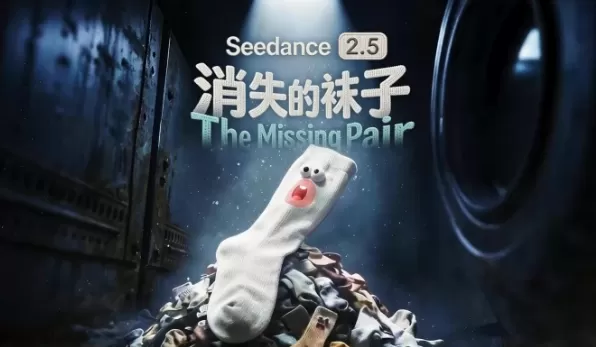
Selon l’annonce officielle, Seedance 2.5 conserve son architecture audiovisuelle multimodale unifiée tout en apportant des améliorations significatives en matière de narration longue durée, de référencement multimodal et de précision de montage. Cette avancée permet aux vidéos générées par l’IA de passer de simples clips isolés à des récits cohérents, dotés d’un début, d’un milieu et d’une fin clairement définis.
Une narration fluide en plusieurs plans en moins de 30 secondes, garantissant la cohérence grâce à une génération prolongée
Les démonstrations officielles mettent en avant la capacité du modèle à structurer des récits complexes dans un laps de 30 secondes. Un exemple présente la prestation d’une chanteuse, la caméra la suivant depuis l’arrière de rideaux rouges jusqu’à sa loge en coulisses. La séquence montre la chanteuse en train d’ajuster ses écouteurs, de recevoir des indications scéniques, de traverser un couloir, d’interagir avec un partenaire et, enfin, de monter sur scène. La caméra s’éloigne pour révéler l’ensemble du stade, y compris le public, l’éclairage et la foule en liesse. Le modèle organise avec succès des plans logiquement liés — exposition, développement, climax et dénouement — dans le délai imparti.
La fonctionnalité d’extension en plusieurs étapes du modèle est tout aussi performante, lui permettant de générer 30 secondes supplémentaires de vidéo à partir des séquences existantes. Elle préserve la cohérence des personnages, des décors, du style visuel et des effets sonores. Dans une démo, un garçon sort d’une rame de métro avec un ballon de football, poursuivi par un homme qui finit par le rattraper. L’action continue se déroule de manière fluide, sans rupture visuelle ni narrative.
Traitez simultanément jusqu’à 30 images et 10 vidéos pour des récits collectifs complexes
Seedance 2.5 permet aux utilisateurs de télécharger jusqu’à 30 images, 10 clips vidéo et 10 fichiers audio comme données de référence. Le modèle analyse la composition, les scènes, les styles, les personnages et les accessoires présents dans ces éléments, et les applique avec précision selon les instructions de l’utilisateur. Dans les scènes à plusieurs personnages, il préserve l’apparence et la voix de chaque individu tout en maintenant la stabilité du sujet principal. Un extrait de concert de 30 secondes a démontré cette capacité, en utilisant un format cinématographique 16:9 avec des références incluant un pianiste, un violoncelliste, un violoniste, un chanteur, un orchestre, une chorale et un public. À mesure que les outils vidéo basés sur l’IA évoluent, passant de simples générateurs d’effets à des plateformes narratives complètes, le flux de travail pour la production de courtes vidéos pourrait nécessiter une refonte complète.
Article connexe
 Ctrip Business Travel dévoile un écosystème d'intelligence artificielle comprenant 7 agents sectoriels et 17 fonctionnalités clés
Ctrip Business Travel a officiellement dévoilé l’« Écosystème IA de Ctrip Business Travel », qui s’appuie sur des modèles linguistiques de grande envergure pour restructurer en profondeur la gestion d
Stripe va acquérir OpenRouter alors que le routage basé sur des modèles d'IA prend de l'ampleur
Stripe a conclu un accord en vue d’acquérir OpenRouter, une plateforme de routage de modèles d’IA qui permet aux développeurs d’accéder à des centaines de modèles via une interface unique. Cette acqui
Barrett Zoph, ancien chercheur chez OpenAI, revient chez Google pour contribuer au développement de Gemini
Barret Zoph, qui avait auparavant quitté brusquement l’entreprise pour rejoindre OpenAI en raison d’un désaccord avec Miriam Mularati, PDG de Thinking Machines Lab, a une nouvelle fois changé d’employ
Recommandations de sujets spéciaux liés
Conception et art
 Les meilleurs outils d'illustration basés sur l'IA : créez plus rapidement des scènes éditoriales et des illustrations de couverture
Les meilleurs outils d'illustration IA de 2026 : notre sélection regroupe les outils les plus performants pour créer rapidement de superbes scènes éditoriales et des couvertures accrocheuses. Chaque option a été soumise à des tests rigoureux en conditions réelles ; nous vous proposons une comparaison entre les versions gratuites et payantes afin de vous aider à trouver celle qui correspond le mieux à votre flux de travail. Essayez dès aujourd’hui ces solutions incontournables pour exploiter pleinement le potentiel de l’IA et booster votre productivité créative. Découvrez-les dès maintenant sur XIX.AI.
 10 outils
 xix.ai
Éducation et apprentissage
Les meilleurs professeurs particuliers spécialisés en IA pour la préparation aux examens : entraînez-vous en maths, en sciences et en anglais
Les meilleurs tuteurs IA 2026 les mieux notés pour la préparation aux examens sont disponibles ici, sur XIX.AI ! Notre sélection comprend des outils puissants et révolutionnaires qui proposent une comparaison entre les versions gratuites et payantes, des tests concrets et des classements mis à jour chaque semaine. Ils vous aident à améliorer votre efficacité à l'écrit, à simplifier l'apprentissage de sujets complexes et à libérer votre potentiel académique. Découvrez dès maintenant l'outil de préparation aux examens qui vous convient le mieux et commencez à créer dès aujourd'hui pour exploiter pleinement les avantages de l'IA !
10 outils
xix.ai
Finance
Outils de planification budgétaire par IA pour la gestion personnelle des finances
2026 Derniers Meilleurs Outils de Planification Budgétaire par IA les mieux notés pour la gestion personnelle des finances sont ici sur XIX.AI ! Cette collection soigneusement sélectionnée propose des solutions puissantes et révolutionnaires qui vous aident à réaliser des tests concrets, à comprendre vos habitudes de dépenses et à créer des plans personnalisés pour améliorer votre productivité. Profitez d’une comparaison entre versions gratuites et payantes ainsi que de classements détaillés. Des outils incontournables conçus pour simplifier la gestion financière et exploiter pleinement votre avantage grâce à l’IA. Explorez dès maintenant !
11 outils
xix.ai
Santé et bien-être
Assistants de suivi du sommeil par l’IA : améliorez votre récupération grâce à de meilleures habitudes avant le coucher
2026 : Découvrez les meilleurs assistants de suivi du sommeil basés sur l’IA, hautement notés et récemment mis à jour, conçus pour une récupération optimale. Ce guide hebdomadaire entièrement actualisé présente des outils puissants qui offrent des tests en conditions réelles, des comparaisons entre versions gratuites et payantes, ainsi que des classements détaillés afin de vous aider à trouver la solution idéale pour améliorer la qualité du sommeil et favoriser de meilleures habitudes avant le coucher. Explorez-le dès maintenant sur XIX.AI pour tirer parti des avantages offerts par l’IA.
10 outils
xix.ai
Analyse des données
Copilotes SQL basés sur l'IA pour l'analyse des produits et du chiffre d'affaires
2026 : les meilleurs copilotes SQL IA les mieux notés pour l'analyse des produits et du chiffre d'affaires ! XIX.AI a sélectionné une gamme d’outils puissants et révolutionnaires à essayer absolument, qui sont soumis à des tests en conditions réelles via des classements mis à jour chaque semaine. Ces outils aident les utilisateurs à booster considérablement leur productivité en accélérant l’analyse des données, en simplifiant les requêtes complexes et en générant des informations précises permettant de prendre des décisions commerciales plus éclairées. Explorez-les dès maintenant pour découvrir l’outil idéal qui vous permettra de tirer pleinement parti de l’IA !
14 outils
xix.ai
Éducation et apprentissage
Les meilleurs outils d'aide aux devoirs basés sur l'IA qui enseignent : apprenez les concepts, pas seulement les réponses
2026 : les meilleurs outils d'aide aux devoirs basés sur l'IA, les mieux notés, qui enseignent les concepts fondamentaux et ne se contentent pas de fournir des réponses. Des outils puissants pour les élèves. Une sélection incontournable à ne pas manquer. Mise à jour hebdomadaire. Comparaison entre les versions gratuites et payantes. Tests en conditions réelles. Classements précis pour vous aider à exploiter pleinement votre potentiel d'apprentissage. Explorez dès maintenant pour découvrir l'outil idéal qui vous permettra d'étudier plus efficacement.
10 outils
xix.ai

 commentaires (0)
ByteDance a officiellement lancé Seedance 2.5, un modèle de génération de vidéos qui double la durée maximale de sortie, passant de 15 à 30 secondes par vidéo. La plateforme sera déployée progressivement sur Ji Meng AI et Dou Bao Professional Edition, et son intégration via une API à Volcano Argo est prévue prochainement afin de prendre en charge diverses applications dans les domaines du cinéma, de la publicité, de l’éducation, de la fabrication industrielle et de la conduite autonome.
Selon l’annonce officielle, Seedance 2.5 conserve son architecture audiovisuelle multimodale unifiée tout en apportant des améliorations significatives en matière de narration longue durée, de référencement multimodal et de précision de montage. Cette avancée permet aux vidéos générées par l’IA de passer de simples clips isolés à des récits cohérents, dotés d’un début, d’un milieu et d’une fin clairement définis.
Une narration fluide en plusieurs plans en moins de 30 secondes, garantissant la cohérence grâce à une génération prolongée
Les démonstrations officielles mettent en avant la capacité du modèle à structurer des récits complexes dans un laps de 30 secondes. Un exemple présente la prestation d’une chanteuse, la caméra la suivant depuis l’arrière de rideaux rouges jusqu’à sa loge en coulisses. La séquence montre la chanteuse en train d’ajuster ses écouteurs, de recevoir des indications scéniques, de traverser un couloir, d’interagir avec un partenaire et, enfin, de monter sur scène. La caméra s’éloigne pour révéler l’ensemble du stade, y compris le public, l’éclairage et la foule en liesse. Le modèle organise avec succès des plans logiquement liés — exposition, développement, climax et dénouement — dans le délai imparti.
La fonctionnalité d’extension en plusieurs étapes du modèle est tout aussi performante, lui permettant de générer 30 secondes supplémentaires de vidéo à partir des séquences existantes. Elle préserve la cohérence des personnages, des décors, du style visuel et des effets sonores. Dans une démo, un garçon sort d’une rame de métro avec un ballon de football, poursuivi par un homme qui finit par le rattraper. L’action continue se déroule de manière fluide, sans rupture visuelle ni narrative.
Traitez simultanément jusqu’à 30 images et 10 vidéos pour des récits collectifs complexes
Seedance 2.5 permet aux utilisateurs de télécharger jusqu’à 30 images, 10 clips vidéo et 10 fichiers audio comme données de référence. Le modèle analyse la composition, les scènes, les styles, les personnages et les accessoires présents dans ces éléments, et les applique avec précision selon les instructions de l’utilisateur. Dans les scènes à plusieurs personnages, il préserve l’apparence et la voix de chaque individu tout en maintenant la stabilité du sujet principal. Un extrait de concert de 30 secondes a démontré cette capacité, en utilisant un format cinématographique 16:9 avec des références incluant un pianiste, un violoncelliste, un violoniste, un chanteur, un orchestre, une chorale et un public. À mesure que les outils vidéo basés sur l’IA évoluent, passant de simples générateurs d’effets à des plateformes narratives complètes, le flux de travail pour la production de courtes vidéos pourrait nécessiter une refonte complète.








 Ctrip Business Travel dévoile un écosystème d'intelligence artificielle comprenant 7 agents sectoriels et 17 fonctionnalités clés
Ctrip Business Travel a officiellement dévoilé l’« Écosystème IA de Ctrip Business Travel », qui s’appuie sur des modèles linguistiques de grande envergure pour restructurer en profondeur la gestion d
 Stripe va acquérir OpenRouter alors que le routage basé sur des modèles d'IA prend de l'ampleur
Stripe a conclu un accord en vue d’acquérir OpenRouter, une plateforme de routage de modèles d’IA qui permet aux développeurs d’accéder à des centaines de modèles via une interface unique. Cette acqui
 Barrett Zoph, ancien chercheur chez OpenAI, revient chez Google pour contribuer au développement de Gemini
Barret Zoph, qui avait auparavant quitté brusquement l’entreprise pour rejoindre OpenAI en raison d’un désaccord avec Miriam Mularati, PDG de Thinking Machines Lab, a une nouvelle fois changé d’employ

Les meilleurs outils d'illustration IA de 2026 : notre sélection regroupe les outils les plus performants pour créer rapidement de superbes scènes éditoriales et des couvertures accrocheuses. Chaque option a été soumise à des tests rigoureux en conditions réelles ; nous vous proposons une comparaison entre les versions gratuites et payantes afin de vous aider à trouver celle qui correspond le mieux à votre flux de travail. Essayez dès aujourd’hui ces solutions incontournables pour exploiter pleinement le potentiel de l’IA et booster votre productivité créative. Découvrez-les dès maintenant sur XIX.AI.
10 outils
xix.ai

Les meilleurs tuteurs IA 2026 les mieux notés pour la préparation aux examens sont disponibles ici, sur XIX.AI ! Notre sélection comprend des outils puissants et révolutionnaires qui proposent une comparaison entre les versions gratuites et payantes, des tests concrets et des classements mis à jour chaque semaine. Ils vous aident à améliorer votre efficacité à l'écrit, à simplifier l'apprentissage de sujets complexes et à libérer votre potentiel académique. Découvrez dès maintenant l'outil de préparation aux examens qui vous convient le mieux et commencez à créer dès aujourd'hui pour exploiter pleinement les avantages de l'IA !
10 outils
xix.ai

2026 Derniers Meilleurs Outils de Planification Budgétaire par IA les mieux notés pour la gestion personnelle des finances sont ici sur XIX.AI ! Cette collection soigneusement sélectionnée propose des solutions puissantes et révolutionnaires qui vous aident à réaliser des tests concrets, à comprendre vos habitudes de dépenses et à créer des plans personnalisés pour améliorer votre productivité. Profitez d’une comparaison entre versions gratuites et payantes ainsi que de classements détaillés. Des outils incontournables conçus pour simplifier la gestion financière et exploiter pleinement votre avantage grâce à l’IA. Explorez dès maintenant !
11 outils
xix.ai

2026 : Découvrez les meilleurs assistants de suivi du sommeil basés sur l’IA, hautement notés et récemment mis à jour, conçus pour une récupération optimale. Ce guide hebdomadaire entièrement actualisé présente des outils puissants qui offrent des tests en conditions réelles, des comparaisons entre versions gratuites et payantes, ainsi que des classements détaillés afin de vous aider à trouver la solution idéale pour améliorer la qualité du sommeil et favoriser de meilleures habitudes avant le coucher. Explorez-le dès maintenant sur XIX.AI pour tirer parti des avantages offerts par l’IA.
10 outils
xix.ai

2026 : les meilleurs copilotes SQL IA les mieux notés pour l'analyse des produits et du chiffre d'affaires ! XIX.AI a sélectionné une gamme d’outils puissants et révolutionnaires à essayer absolument, qui sont soumis à des tests en conditions réelles via des classements mis à jour chaque semaine. Ces outils aident les utilisateurs à booster considérablement leur productivité en accélérant l’analyse des données, en simplifiant les requêtes complexes et en générant des informations précises permettant de prendre des décisions commerciales plus éclairées. Explorez-les dès maintenant pour découvrir l’outil idéal qui vous permettra de tirer pleinement parti de l’IA !
14 outils
xix.ai

2026 : les meilleurs outils d'aide aux devoirs basés sur l'IA, les mieux notés, qui enseignent les concepts fondamentaux et ne se contentent pas de fournir des réponses. Des outils puissants pour les élèves. Une sélection incontournable à ne pas manquer. Mise à jour hebdomadaire. Comparaison entre les versions gratuites et payantes. Tests en conditions réelles. Classements précis pour vous aider à exploiter pleinement votre potentiel d'apprentissage. Explorez dès maintenant pour découvrir l'outil idéal qui vous permettra d'étudier plus efficacement.
10 outils
xix.ai












